Представляем Olmo-core 3: Открытая, масштабируемая инфраструктура для обучения больших MoE-моделей





Сегодня мы выпускаем Olmo-core 3 — значительное обновление нашего фреймворка для разработки больших языковых моделей с переработанной открытой системой обучения моделей со смесью экспертов (MoE).
Olmo-core 3 разработан для масштабирования обучения MoE до диапазона в триллионы параметров при сохранении вычислительной эффективности. Это одна из ключевых систем следующего поколения Olmo и часть нашей постоянной работы по открытию инструментов и инфраструктуры обучения, лежащих в основе каждой новой модели.
Обучение больших ИИ-моделей требует значительных вычислительных ресурсов, повышает затраты и энергопотребление и делает разработку передовых моделей недоступной для многих академических исследователей и небольших лабораторий. Модели MoE предлагают более эффективный подход: они могут содержать гораздо больше изученных компонентов, или параметров, не требуя от каждого входного элемента использовать их все. Однако всю модель по-прежнему необходимо хранить в памяти GPU и обновлять во время обучения, а направление входных данных к нужным экспертам — специализированным компонентам внутри MoE — в кластере создаёт дополнительные расходы на коммуникацию и координацию. По мере роста MoE эти расходы могут свести на нет значительную часть вычислительного преимущества, получаемого благодаря использованию лишь части модели для каждого входного элемента.
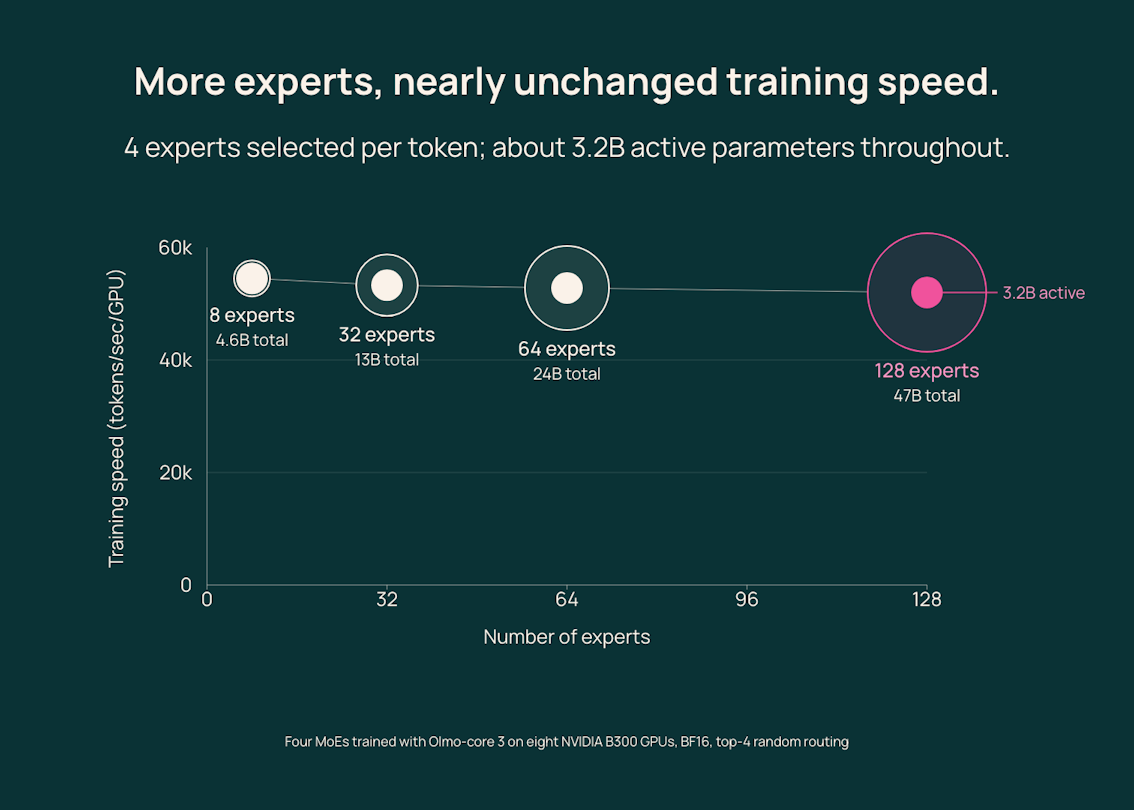
Olmo-core 3 призван устранить этот разрыв. В одном из тестов мы увеличили пул экспертов с 8 до 128, при этом выбирая только четырёх экспертов для каждого токена — небольших единиц текста, обрабатываемых языковой моделью, — и сохранили примерно постоянное число активных параметров на токен: около 3,2 млрд. Общая ёмкость параметров выросла с 4,6 млрд до 47 млрд, а пропускная способность обучения снизилась менее чем на 5%.
Та же инфраструктура была протестирована при общем количестве параметров свыше одного триллиона.
Создание стека обучения с учётом принципов работы MoE
Olmo-core развивался вместе с каждым новым поколением Olmo.
Наша работа над разреженными моделями началась с OlmoE, в которой использовалась архитектура MoE с 64 маршрутизируемыми экспертами. В отличие от неё, Olmo 3 использовала плотную архитектуру: это означает, что почти вся модель была активна для каждого токена, а её стек обучения создавался с учётом этой конструкции. Olmo-core 3 расширяет фреймворк системой обучения, предназначенной для гораздо более крупных моделей MoE.
В нашей предыдущей реализации MoE в Olmo-core использовался полностью фрагментированный параллелизм данных (FSDP), настроенный на сбор и повторное распределение весов модели для каждой небольшой порции обучающих данных. Olmo-core 3 переходит на систему, основанную на распределённом параллелизме данных (DDP). Она сохраняет экспертов на GPU и направляет к ним соответствующие данные, избегая повторного сбора весов.
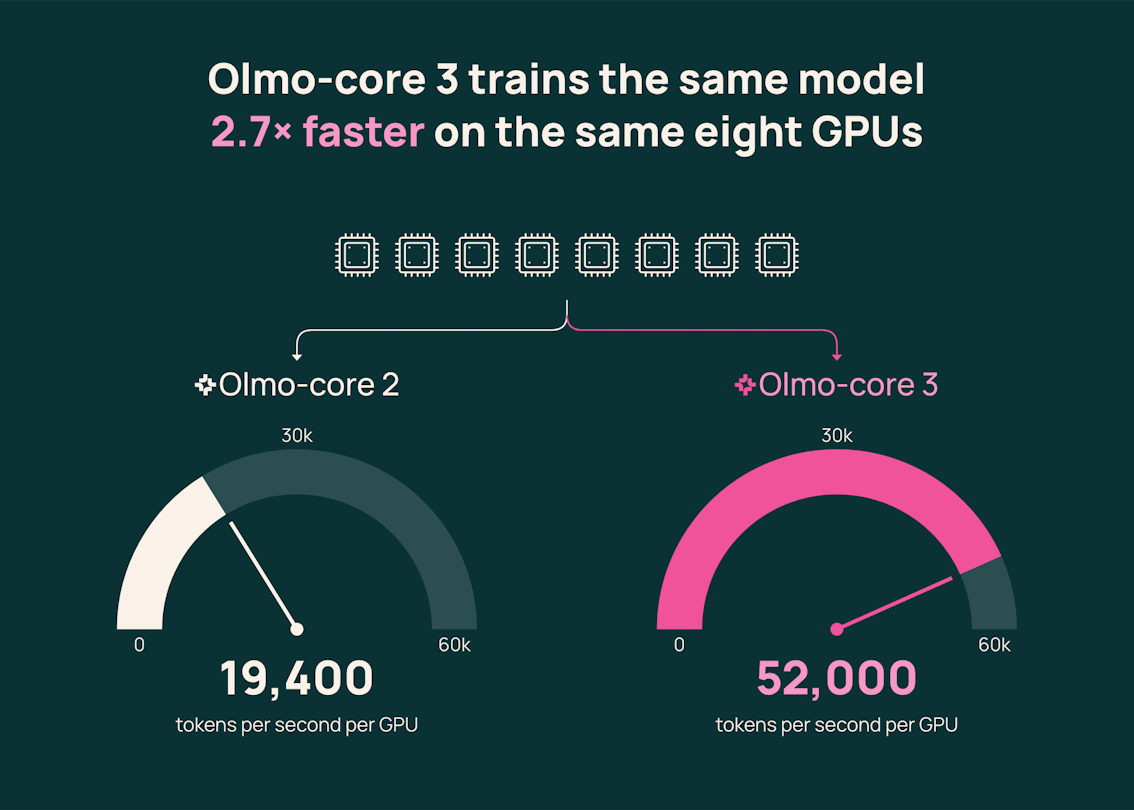
Megatron-Core от NVIDIA — устоявшееся решение для обучения крупных MoE. Olmo-core 3 добавляет интегрированный стек обучения MoE во фреймворк, лежащий в основе Olmo, и благодаря переработке повышает пропускную способность по сравнению с нашей предыдущей реализацией на базе FSDP. В предварительном тесте на восьми GPU NVIDIA B300 MoE-модель с 47 млрд параметров обрабатывала 52 000 токенов в секунду на GPU с новым стеком против 19 400 в предыдущей реализации — примерно в 2,7 раза выше.
Масштабирование и оптимизация обучения MoE
Olmo-core 3 объединяет несколько методов распределения крупных MoE по кластерам GPU с оптимизациями, повышающими эффективность маршрутизации и вычислений.
Три метода определяют, как модель и её состояние обучения распределяются между аппаратными ресурсами:
- Параллелизм экспертов распределяет экспертов по GPU, поэтому каждый GPU хранит лишь часть полного пула экспертов.
- Конвейерный параллелизм разделяет слои модели — последовательные этапы преобразования входных данных — между группами GPU, уменьшая объём модели, который должен храниться в памяти каждого GPU.
- Распределённый оптимизатор распределяет состояние оптимизатора — дополнительные данные, используемые для расчёта и применения обновлений во время обучения, — между GPU вместо хранения полной копии на каждом GPU.
Вместе эти методы позволяют масштабировать MoE без необходимости хранить на каждом GPU всю модель и состояние её обучения в памяти.
Olmo-core 3 также снижает стоимость направления данных к нужным экспертам и выполнения их вычислений. Построчный параллелизм экспертов помещает маршрутизируемые данные непосредственно во входные буферы экспертов, сводя к минимуму дополнительные операции по их перестановке. Маршрутизация с размещением на GPU хранит метаданные маршрутизации на GPU, поэтому CPU может ставить задачи в очередь, не ожидая копирования этой информации обратно. А сгруппированная GEMM объединяет множество небольших вычислений экспертов, чтобы GPU могли выполнять их эффективнее.
Наконец, Olmo-core 3 поддерживает MXFP8 — числовой формат с более низкой точностью, в котором некоторые значения представляются меньшим числом битов. Это может сократить объём вычислений и данных, передаваемых между GPU, если полученная экономия превышает затраты на преобразование между числовыми форматами.
Мы измерили влияние MXFP8 на сквозную пропускную способность обучения в контролируемом тесте на четырёх GPU NVIDIA B300, равномерно распределив нагрузку между экспертами. При включённом MXFP8 в тех частях системы, где он был наиболее эффективен, пропускная способность обучения была примерно на 21% выше, чем при использовании BF16 — формата с более высокой точностью, взятого нами за базовый, — а пиковый объём активной памяти снизился со 103 ГиБ до 95 ГиБ. Большая часть прироста пришлась на прямые вычисления и передачу данных между экспертами, а не только на механизм внимания.
Эти методы и оптимизации должны работать согласованно. Ускорение одной части обучения может создать дополнительные затраты в другой: более быстрые вычисления могут потребовать перемещения большего объёма данных, а передача меньшего числа битов не принесёт пользы, если преобразование данных занимает слишком много времени. Olmo-core 3 построен с учётом этих компромиссов на протяжении всего процесса обучения, предоставляя нам и исследователям, использующим открытый стек, контроль над тем, как взаимодействуют его компоненты.
Изучите наше интерактивное руководство, чтобы увидеть, как параллелизм данных, экспертов и конвейера совместно масштабируют обучение MoE — от одного GPU до множества.

Масштабирование до диапазона в триллионы параметров
Мы протестировали Olmo-core 3 на различных конфигурациях с использованием GPU NVIDIA B300, включая модель с 1,2 трлн параметров, в которой на каждый токен приходилось 58,36 млрд активных параметров при работе на 512 GPU. Максимальная зафиксированная пропускная способность составила 858 TFLOP/s/GPU — это показатель полезных вычислений модели в секунду на каждом GPU. В этих тестах использовалась случайная маршрутизация для измерения производительности системы, а не качества обученной модели.
Мы также экспериментировали с DeepEP v2 — альтернативным способом организации обмена данными между экспертами на разных GPU, — достигнув конфигурации с общим числом параметров 2,38 трлн. Это был кратковременный тест ёмкости, а не полноценный запуск обучения, поэтому он демонстрирует достижимый масштаб Olmo-core 3, а не устойчивую производительность обучения.
На таких масштабах производительность системы — лишь часть картины. В нашем техническом отчёте также описаны эксперименты, повлиявшие на то, как мы обучаем MoE и измеряем её производительность. Например:
- Оценка, призванная поощрять сбалансированную маршрутизацию, могла улучшаться, даже когда фактическая рабочая нагрузка становилась менее сбалансированной. Мы называем эту проблему джерримендерингом токенов.
- Снижение скорости обучения экспертов — величины обновлений во время обучения — из-за обработки ими меньшего числа токенов не улучшило результаты в протестированном нами семействе моделей.
- Вычисления на GPU занимали разное время при изменении обрабатываемых значений, даже если размеры матриц оставались одинаковыми. Поэтому для сравнения производительности необходимо сопоставлять не только формы, но и входные значения.
- Перекрытие коммуникаций и вычислений в отдельных потоках GPU не всегда ускоряло обучение. В некоторых тестах это замедляло сквозное выполнение — напоминание о том, что большее перекрытие не обязательно означает более высокую пропускную способность.
В отчёте эти результаты рассматриваются наряду с подходами, которые мы протестировали и решили не применять.
Создано для следующего поколения Olmo и открыто для всех
Olmo-core 3 — основа того, что мы создаём дальше. В следующем поколении Olmo будет использоваться архитектура MoE, и мы стремимся сделать его самой мощной версией Olmo: модель будет обучена на нашем крупнейшем наборе данных и с самым длинным контекстным окном.
Новый стек позволяет нам выйти за пределы предыдущих работ с MoE и одновременно даёт больше гибкости для адаптации обучения по мере развития моделей и аппаратного обеспечения. Он полностью открыт: исследователи и разработчики могут использовать Olmo-core 3 для обучения собственных MoE-моделей, адаптировать его под различное оборудование и экспериментировать с маршрутизацией, параллелизмом и другими компонентами системы.
Так мы понимаем разработку открытых моделей: веса модели полезнее, когда инфраструктура и решения, лежащие в основе её обучения, также открыты.
Чтобы глубже изучить архитектуру системы, эксперименты, абляционные исследования и подходы, которые мы тестировали в процессе, прочитайте наш технический отчёт и изучите Olmo-core 3 на GitHub.


Сообщество
· Зарегистрируйтесь или войдите, чтобы оставить комментарий
Переведено автоматически с английского. Оригинал статьи — по ссылке ниже.