Представяме Olmo-core 3: Отворена, мащабируема инфраструктура за обучение на големи MoE модели





Днес представяме Olmo-core 3 — значително обновление на нашата рамка за разработване на големи езикови модели, включващо преработена отворена система за обучение със смес от експерти (MoE).
Olmo-core 3 е проектиран да мащабира обучението на MoE модели до диапазона от трилиони параметри, като същевременно запазва изчислителната ефективност. Това е една от основните системи зад следващото поколение Olmo и част от постоянния ни ангажимент да отваряме инструментите и инфраструктурата за обучение зад всеки нов модел.
Обучението на големи AI модели изисква значителни изчислителни ресурси, което увеличава разходите и потреблението на енергия и прави разработването на напреднали модели недостъпно за много академични изследователи и по-малки лаборатории. MoE моделите предлагат по-ефективен подход — те могат да съдържат много повече научени компоненти, или параметри, без всеки вход да използва всички от тях. Но целият модел все пак трябва да се съхранява в паметта на графичните процесори и да се обновява по време на обучението, а насочването на входовете към правилните експерти — специализираните компоненти в MoE — в рамките на клъстер създава собствени разходи за комуникация и координация. С нарастването на MoE моделите тези разходи могат да заличат голяма част от изчислителното предимство на използването само на част от модела за всеки вход.
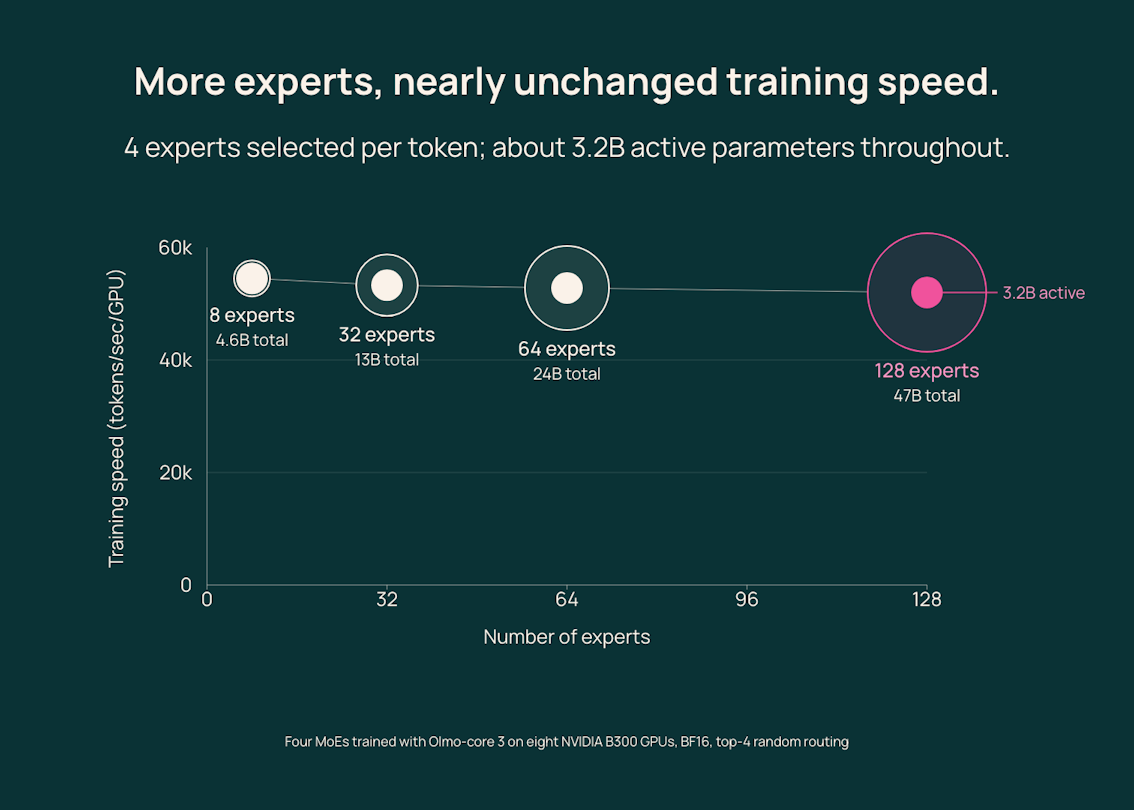
Olmo-core 3 е създаден, за да преодолее тази разлика. В един бенчмарк увеличихме набора от експерти от 8 на 128, като продължихме да избираме само четири експерта за всеки токен — малките единици текст, които езиковият модел обработва — и така запазихме приблизително постоянен броя на активните параметри на токен — около 3,2 млрд. Общият капацитет на параметрите нарасна от 4,6 млрд. на 47 млрд., докато пропускателната способност при обучението спадна с по-малко от 5%.
Същата инфраструктура е тествана с общо над един трилион параметри.
Изграждане на стек за обучение според реалния начин на работа на MoE моделите
Olmo-core се развива с всяко поколение на Olmo.
Работата ни по разредените модели започна с OlmoE, който използва MoE архитектура с 64 насочвани експерти. Olmo 3, за разлика от него, използваше плътна архитектура, което означава, че почти целият модел беше активен за всеки токен, а стекът му за обучение беше изграден около този дизайн. Olmo-core 3 разширява рамката със система за обучение, проектирана за много по-големи MoE модели.
По-ранната ни MoE реализация в Olmo-core използваше напълно шардиран паралелизъм на данните (FSDP), конфигуриран да събира и повторно да шардира теглата на модела за всеки малък пакет тренировъчни данни. Olmo-core 3 преминава към система, базирана на разпределен паралелизъм на данните (DDP). Тя поддържа експертите постоянно заредени в графичните процесори и насочва съответните данни към тях, като избягва многократното събиране на теглата.
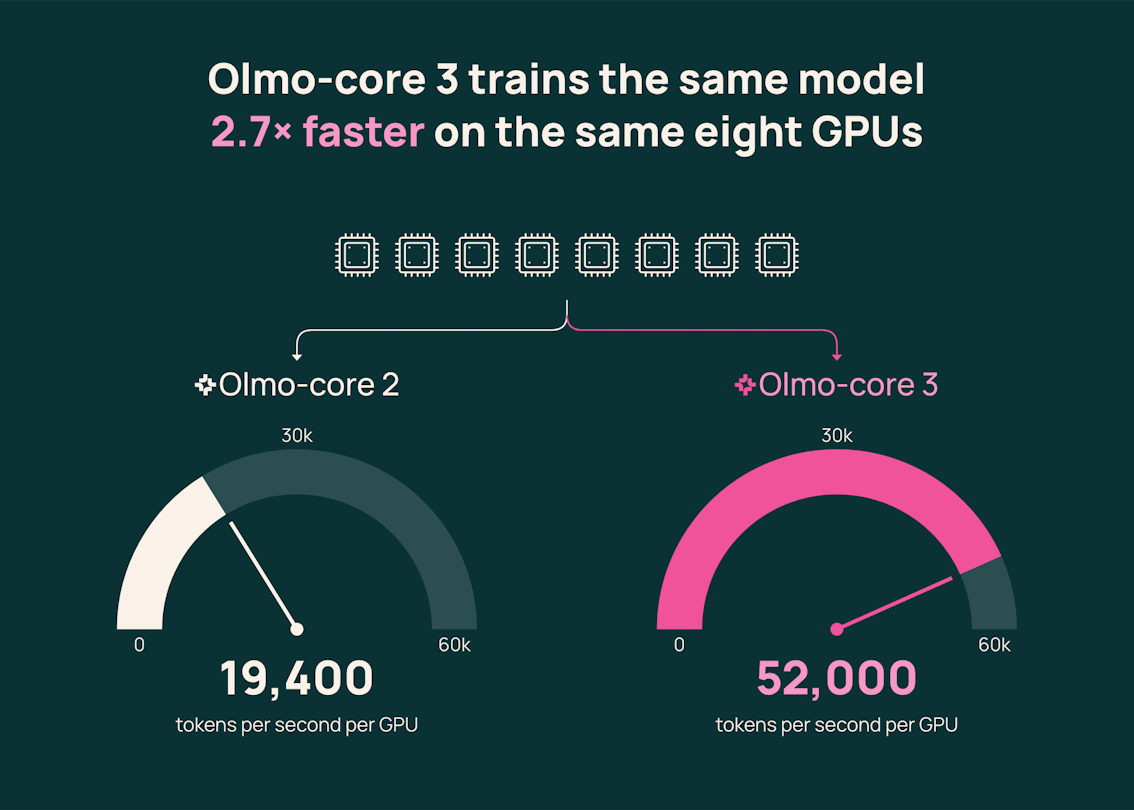
Megatron-Core на NVIDIA е утвърдена опция за обучение на големи MoE модели. Olmo-core 3 добавя интегриран стек за обучение на MoE към рамката зад Olmo, с преработен дизайн, който подобрява пропускателната способност спрямо по-ранната ни реализация, базирана на FSDP. При предварителен тест с осем графични процесора NVIDIA B300, MoE модел с 47 милиарда параметри обработи 52 000 токена в секунда на графичен процесор с новия стек, в сравнение с 19 400 при по-ранната ни реализация — около 2,7 пъти по-висока пропускателна способност.
Мащабиране и оптимизиране на обучението на MoE модели
Olmo-core 3 комбинира няколко техники за разпределяне на големи MoE модели в клъстери от графични процесори с оптимизации, които правят маршрутизирането и изчисленията по-ефективни.
Три техники определят начина, по който моделът и състоянието му при обучение се разделят между хардуера:
- Паралелизъм на експертите разпределя експертите между графичните процесори, така че всеки графичен процесор съхранява само част от целия набор експерти.
- Конвейерен паралелизъм разделя слоевете на модела — последователните етапи, които преобразуват входа — между групи графични процесори, като намалява количеството от модела, което всеки графичен процесор трябва да държи в паметта.
- Разпределен оптимизатор разпределя състоянието на оптимизатора — допълнителните данни, използвани за изчисляване и прилагане на обновленията по време на обучението — между графичните процесори, вместо да съхранява пълно копие във всеки графичен процесор.
Заедно тези техники позволяват на MoE моделите да се мащабират, без всеки графичен процесор да трябва да съхранява целия модел и състоянието му при обучение в паметта.
Olmo-core 3 също така намалява разходите за маршрутизиране на данните към правилните експерти и за изпълнение на техните изчисления. Паралелизъм на експертите по редове поставя маршрутизираните данни директно във входните буфери на експертите, като минимизира допълнителната работа, необходима за пренареждането им. Маршрутизиране, разположено в графичния процесор поддържа метаданните за маршрутизирането в графичните процесори, така че процесорът може да поставя работата в опашка, без да изчаква информацията да бъде копирана обратно. А групираният GEMM комбинира множество малки изчисления на експертите, за да могат графичните процесори да ги изпълняват по-ефективно.
Накрая, Olmo-core 3 поддържа MXFP8 — числов формат с по-ниска точност, който представя някои стойности с по-малко битове. Това може да намали изчисленията и количеството данни, прехвърляни между графичните процесори, стига тези спестявания да надвишават разходите за преобразуване между числовите формати.
Измерихме ефекта на MXFP8 върху пропускателната способност при цялостното обучение в контролиран бенчмарк на четири графични процесора NVIDIA B300, с равномерно разпределена работа между експертите. При активиран MXFP8 за частите от системата, в които той помагаше най-много, пропускателната способност при обучението беше с около 21% по-висока от тази при BF16 — формата с по-висока точност, който използвахме като базова линия — докато пиковата активна памет спадна от 103 GiB на 95 GiB. По-голямата част от подобрението идваше от изчисленията с пряко подаване и преместването на данни между експертите, а не само от вниманието.
Тези техники и оптимизации трябва да работят заедно. Ускоряването на една част от обучението може да създаде разходи на друго място; по-бързите изчисления могат да изискват повече преместване на данни, докато преместването на по-малко битове може да не помогне, ако преобразуването на данните отнема твърде много време. Olmo-core 3 е изграден около тези компромиси в целия процес на обучение, като дава на нас — и на изследователите, използващи отворения стек — контрол върху начина, по който отделните части се съчетават.
Разгледайте нашето интерактивно ръководство, за да видите как паралелизмът на данните, експертите и конвейера работят заедно за мащабиране на обучението на MoE модели — от един графичен процесор до много.

Мащабиране до диапазона от трилиони параметри
Тествахме Olmo-core 3 в редица конфигурации на графични процесори NVIDIA B300, включително модел с 1,2 трилиона параметри и 58,36 милиарда активни параметри на токен, разпределен между 512 графични процесора. Най-високата наблюдавана пропускателна способност беше 858 TFLOP/s/GPU — мярка за полезните изчисления на модела в секунда на всеки графичен процесор. При тези тестове използвахме случайно маршрутизиране, за да измерим производителността на системата, а не качеството на обучения модел.
Експериментирахме и с DeepEP v2 — алтернативен начин за обработка на комуникацията между експертите в различни графични процесори — като достигнахме конфигурация с общо 2,38 трилиона параметри. Това беше тест с кратък капацитет, а не пълно изпълнение на обучение, така че демонстрира мащаба, до който може да достигне Olmo-core 3, а не устойчивата производителност при обучение.
При тези мащаби производителността на системата е само част от картината. Техническият ни доклад също така документира експерименти, които ни помогнаха да определим как обучаваме MoE модели и измерваме тяхната производителност. Например:
- Показател, предназначен да насърчава балансирано маршрутизиране, можеше да се подобрява дори когато действителното натоварване ставаше по-небалансирано. Наричаме този проблем разпределително манипулиране на токените.
- Намаляването на скоростта на обучение на експертите — размера на техните обновления при обучение — тъй като обработват по-малко токени, не подобри резултатите при тестваното от нас семейство модели.
- Изчисленията на графичния процесор отнемаха различно време, когато обработваните стойности се променяха, дори при еднакви размери на матриците. Следователно сравненията на производителността изискват еднакви входни стойности, както и еднакви форми.
- Припокриването на комуникацията и изчисленията в отделни потоци на графичния процесор не винаги ускоряваше обучението. При някои тестове то забавяше изпълнението от край до край — напомняне, че по-голямото припокриване не означава непременно по-висока пропускателна способност.
Докладът обяснява тези констатации заедно с подходите, които тествахме и решихме да не възприемаме.
Създаден за следващото поколение Olmo, отворен за всички
Olmo-core 3 е основата на това, което изграждаме занапред. Следващото поколение Olmo ще използва MoE архитектура и целта ни е то да бъде най-способният Olmo досега, обучен с най-големия ни набор от данни и с най-дългия ни контекстен прозорец.
Новият стек ни позволява да надхвърлим предишната си работа по MoE модели, като същевременно ни дава по-голяма гъвкавост да адаптираме обучението с развитието на моделите и хардуера. И той е напълно отворен — изследователи и разработчици могат да използват Olmo-core 3 за обучение на собствени MoE модели, да го адаптират към различен хардуер и да експериментират с маршрутизиране, паралелизъм и други части на системата.
Това е част от начина, по който разбираме разработването на отворени модели — теглата на моделите са по-полезни, когато инфраструктурата и решенията за обучение зад тях също са отворени.
За по-задълбочен поглед върху дизайна на системата, експериментите, аблациите и подходите, които тествахме по пътя, прочетете техническия ни доклад и разгледайте Olmo-core 3 в GitHub.


Общност
· Регистрирайте се или влезте в профила си, за да коментирате
Преведено автоматично от английски. Оригиналната статия е на връзката по-долу.