Можно ли доверять LLM в оценке новизны исследовательской идеи?




Сегодня мы публикуем Старые идеи, новые задачи — новое исследование того, насколько надёжно большие языковые модели могут оценивать новизну научных исследовательских идей. Вместе со статьёй мы публикуем бенчмарк, данные и код для тестирования судей новизны, а также автоматизированный конвейер, который исследователи могут использовать для создания новых наборов оценки.
В Ai2 мы разрабатываем системы ИИ, поддерживающие различные этапы научных открытий. DataVoyager помогает исследователям изучать и анализировать структурированные данные, AutoDiscovery формулирует и проверяет гипотезы, а Theorizer синтезирует свидетельства из больших массивов литературы в потенциальные научные теории. Вместе с Asta эти проекты указывают путь к системам, которые могут помогать исследователям переходить от понимания предыдущих работ к выдвижению, проверке и совершенствованию новых идей.
Но генерация исследовательских идей — лишь часть задачи автоматизации научных открытий. Эти идеи также должны вносить нечто действительно новое, а значит, таким системам нужен способ отличать новое направление от того, которое в основном переупаковывает уже существующие работы.
Эту оценку часто поручают другой LLM — тому, что мы называем судьёй новизны. Судьи новизны оценивают, является ли исследовательская идея новой относительно предыдущих работ — самостоятельно или в сравнении с другой идеей. Стандартного способа их создания не существует: исследовательские команды выбирают модель, промпт, формат оценки, бюджет рассуждений, а иногда и систему поиска литературы. Эти решения могут существенно влиять на вердикт. Тем не менее таких судей часто проверяют только на написанных людьми статьях, а не на сгенерированных ИИ идеях, которые они фактически должны оценивать.
Результаты нашего нового бенчмарка показывают, что сама оценка новизны далека от надёжности. Для шести судей на базе LLM — GPT-5.1, GPT-5.2, GPT-5.4, Claude Sonnet 4.5, Claude Opus 4.5 и Claude Opus 4.6 — кажущиеся небольшими изменения в настройках оценки приводят к кардинально различающимся суждениям об одних и тех же идеях. В одном эксперименте изменение всего нескольких слов в промпте изменило точность модели при определении того, какая из двух идей более нова, более чем на 50 процентных пунктов. Поиск и дополнительные рассуждения не обеспечивают стабильного улучшения оценок, а две специально созданные системы оценки новизны показали худшие результаты, чем простой базовый вариант с промптом для Claude Opus 4.6.
Если ИИ будет играть более значительную роль в научных открытиях, нам нужны более надёжные способы определить, предлагает ли он действительно что-то новое. Наша работа предоставляет инструменты для изучения этой проблемы и одновременно показывает, сколько вопросов ещё остаётся нерешёнными.
Создание бенчмарка для судей новизны
Чтобы проверить, насколько надёжно судьи новизны могут отличать более новые исследовательские идеи от менее новых, нам сначала понадобились примеры, для которых существовали убедительные свидетельства оригинальности лежащего в основе научного вклада.
Поэтому мы создали автоматизированный конвейер на основе рецензий ICLR 2026. Вместо того чтобы считать принятие статьи косвенным показателем новизны, мы извлекли из самих рецензий фрагменты, в которых рецензенты прямо обсуждали оригинальность вклада. Это различие принципиально важно: статью могут принять, даже если она не отличается особой новизной, при условии что она достаточно сильна в других аспектах. Аналогично, у отклонённой статьи с оригинальным вкладом могут быть другие недостатки.
Мы создали пул высокой новизны из 154 исследовательских идей, написанных людьми, отобрав принятые статьи из входящих в верхние 10% по оценкам в своей исследовательской области ICLR, рецензенты которых положительно отмечали новизну и ни один из них её не оспаривал. Для создания пула низкой новизны мы применили обратные критерии: 145 идей из отклонённых статей, входящих в нижние 10%, рецензенты которых указывали на проблемы с оригинальностью, при этом ни один рецензент положительно не отмечал новизну. В рамках отдельной проверки процесса извлечения данных из рецензий аннотатор согласился с полярностью извлечённого сигнала новизны в 47 из 50 случаев; ни одно из расхождений не изменило бы того, считался ли рецензент хвалящим или оспаривающим новизну статьи.
Вместе эти два пула образуют нашу первую настройку оценки — Human-Only, которая проверяет, могут ли судьи новизны отличать написанные людьми идеи, для которых имеются убедительные свидетельства более высокой или более низкой новизны. Но на практике судьи новизны всё чаще используются для оценки идей, сгенерированных ИИ. Поэтому мы создали вторую настройку — Human+Generated.
Для этого пула мы сопоставили те же 154 проверенные человеческие идеи со 154 идеями, созданными простым генератором на базе LLM. Мы предположили, что сгенерированные идеи менее новы, чем соответствующие им идеи, написанные людьми; это слабые метки, а не проверенные суждения для каждой идеи. Генератору передавались только исследовательская область и инструкция предложить новую идею — без поиска литературы, инструментов, итераций или обратной связи. Это позволило получить консервативное сравнение идей базового генератора и вкладов из статей ICLR, входящих в верхние 10%, оригинальность которых рецензенты прямо подтвердили.
В качестве дополнительных проверок эксперт независимо изучил 30 пар Human+Generated, причём особое внимание уделялось случаям, в которых наш самый сильный судья ошибся; кроме того, мы переписали идеи, созданные людьми и ИИ, в общей структуре, чтобы проверить, не реагировали ли судьи просто на различия в стиле написания. Эксперт предпочёл человеческую идею во всех 30 парах и не признал новыми ни одну из сгенерированных идей.
Важно, что многие наши ключевые выводы вообще не зависят от меток. Если две разумные настройки оценки дают противоположные ответы для одной и той же пары идей, само это расхождение указывает на нестабильность.
Небольшие изменения могут приводить к совершенно разным вердиктам
Используя наши коллекции исследовательских идей, написанных людьми и сгенерированных ИИ, мы проверили, насколько хорошо шесть судей на базе LLM — GPT-5.1, GPT-5.2, GPT-5.4, Claude Sonnet 4.5, Claude Opus 4.5 и Claude Opus 4.6 — могут оценивать новизну посредством поточечных (то есть абсолютных оценок новизны) и попарных (то есть сравнения двух идей для определения наиболее новой) сравнений. Мы изменяли по одному фактору за раз: промпт, бюджет рассуждений, возможность судьи видеть связанные статьи, формат представления идей, количество объединяемых суждений для вынесения итогового вердикта и — для идей, сгенерированных ИИ, — модель, которая их создала.
Наиболее существенные изменения производительности были вызваны тем, как мы просили модель оценивать новизну.
Например, мы показали GPT-5.4 одни и те же пары Human+Generated — каждая содержала одну проверенную идею, написанную человеком, и одну идею, сгенерированную ИИ, — используя два промпта. В одном промпте модели сообщалось, что рецензенты признали ровно одну идею в каждой паре новой, и предлагалось определить, какую именно; в другом просто спрашивалось, какая идея является новой. После перехода к более простому промпту точность упала с 93,5% до 40,9% — ниже случайного уровня, — а модель изменила свой вердикт более чем для половины тех же пар.
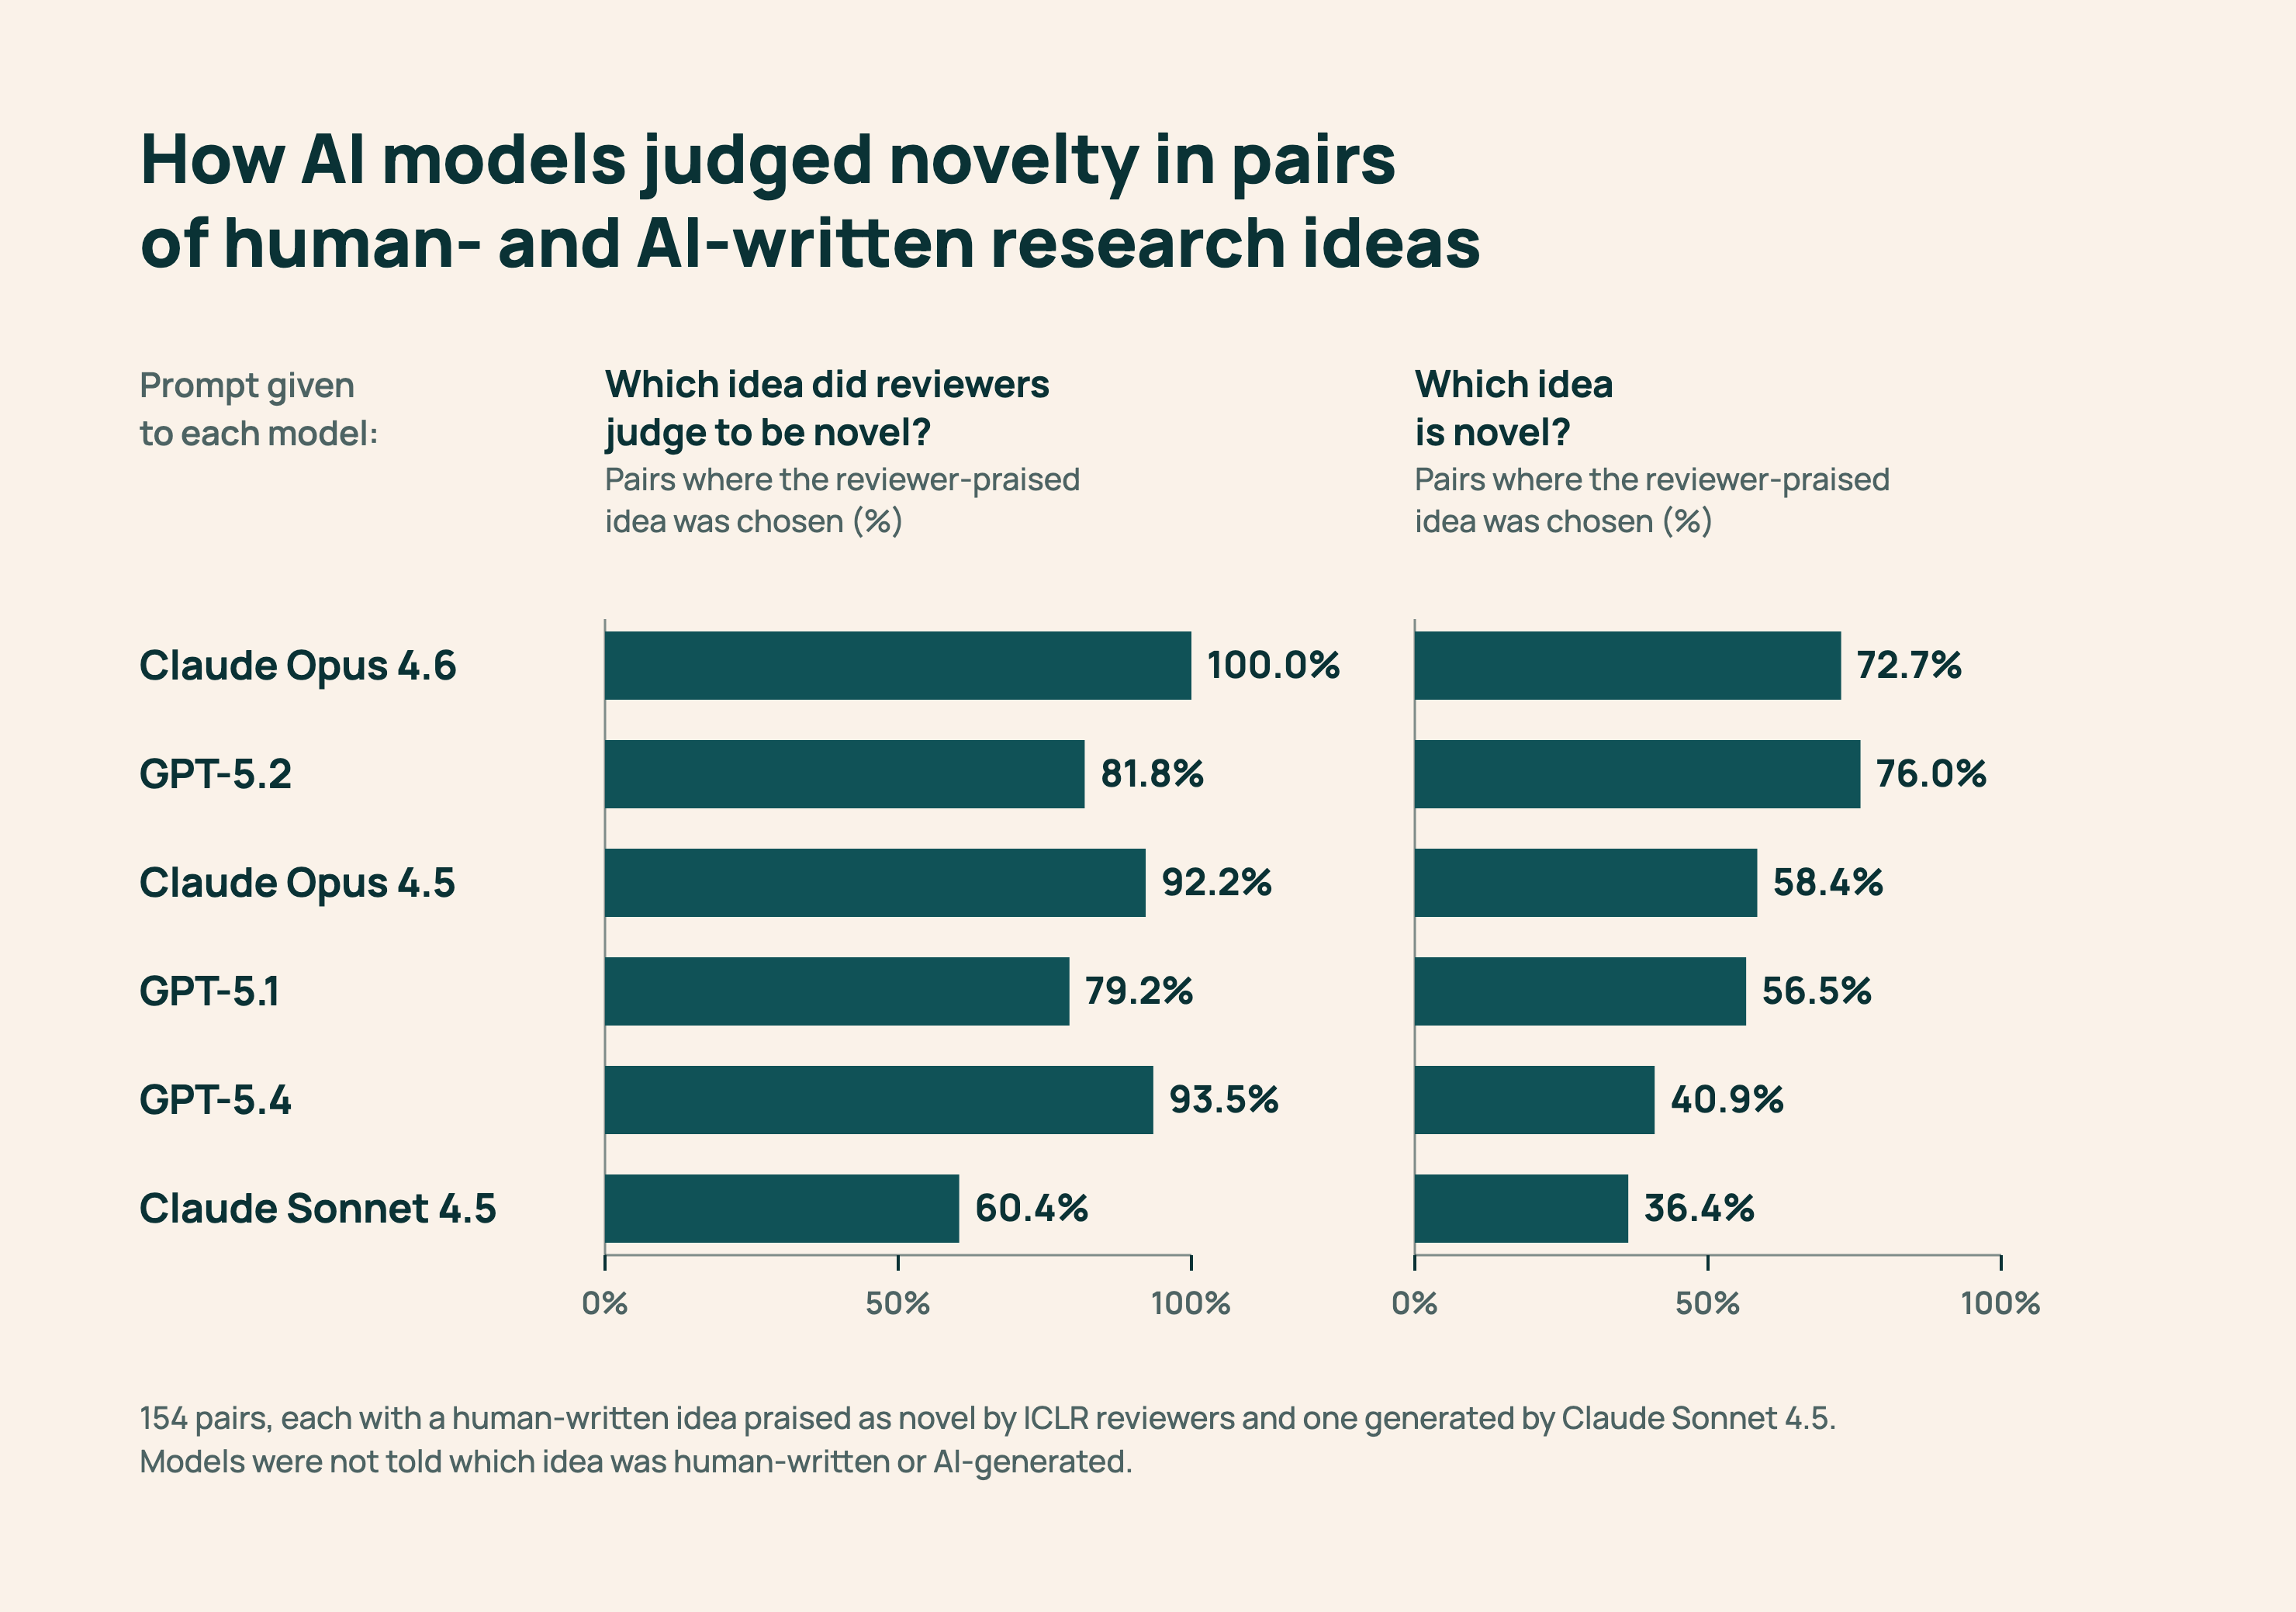
Напротив, на наборе данных Human-Only, где человеческие идеи сопоставлялись с более сильными и более слабыми свидетельствами новизны, то же изменение промпта изменило точность всего примерно на семь процентных пунктов. Это позволяет предположить, что судья новизны может выглядеть относительно стабильным на написанных людьми исследованиях, но вести себя совершенно иначе на идеях, сгенерированных ИИ.
При этом идеи, написанные людьми, не были полностью защищены от такого эффекта. Мы также наблюдали значительные изменения на наборе Human-Only: то же изменение изменило точность Claude Opus 4.6 на 21 пункт. Просто эти изменения были менее серьёзными, чем для идей, сгенерированных ИИ.
Универсально лучшего промпта также не оказалось. Например, при индивидуальной оценке идей удаление инструкции, предупреждавшей судей не считать тривиальные или инкрементальные вклады новыми, повысило точность одних судей и снизило её у других. Иными словами, промпт, хорошо работающий для одной модели, может не подойти другой.
Мы также проверили распространённое применение судей новизны: сравнение идей двух генераторов ИИ. Мы сопоставили идеи Claude Opus 4.5 с Claude Sonnet 4.5, а GPT-5.4 с GPT-5.1. При протестированных изменениях промпта в среднем для шести судей изменялись примерно от четверти до трети вердиктов. Это расхождение можно измерить, не предполагая, какой генератор создаёт более новые идеи, и тем самым показать, как выбор промпта судьи может влиять на сравнение систем генерации идей.
Более активный поиск и рассуждения не обязательно приводили к лучшим оценкам новизны. Мы предоставили GPT-5.6 Sol сверхвысокий бюджет рассуждений и живой итеративный поиск, ограниченный arXiv, а затем сравнили его со стандартными судьями с поиском, каждому из которых показывали пять предварительно найденных аннотаций. (Все судьи в этом сравнении запускались один раз для каждой идеи на наборе Human+Generated.) Агентный судья получил 0,78 macro-F1 — на 11 пунктов меньше, чем Claude Opus 4.6 с результатом 0,89, и примерно столько же, сколько более простые настройки Claude Opus 4.5 и GPT-5.4, — при этом его стоимость на одно решение по текущим ценам API была примерно в 10 раз выше. (В данном контексте macro-F1 измеряет, насколько хорошо судья выявляет новые и неновые идеи; чем выше показатель, тем лучше.)
Специально созданные оценщики также не оказались точнее, несмотря на существенно более высокую стоимость. На наборе Human+Generated простой промпт для Claude Opus 4.6 с низким уровнем рассуждений и мажоритарным голосованием по трём вызовам достиг macro-F1 0,854 при общей стоимости оценки $2,59. Для сравнения, Idea Novelty Checker — конвейер поиска и ранжирования на основе литературы — получил 0,642 при стоимости $30,66, а AI Scientist от Sakana AI, чей оценщик новизны итеративно ищет в Semantic Scholar, получил 0,772 при стоимости $82,05. (Оба специализированных оценщика использовали Claude Opus 4.6, по одному вызову на решение.)
Иными словами, простой базовый вариант с промптом был одновременно точнее и значительно дешевле обеих специально созданных систем.
В совокупности эти результаты показывают, что оценка новизны особенно хрупка применительно к идеям, сгенерированным ИИ, которые всё чаще поручают оценивать таким системам.
К более надёжной оценке новых исследований
Наши результаты показывают, что оценка новизны на базе LLM остаётся важной нерешённой проблемой. Судьи, которые кажутся надёжными при работе с исследованиями, написанными людьми, могут вести себя иначе на идеях, сгенерированных ИИ; промпты, помогающие одной модели, могут навредить другой; а более активный поиск или большие вычислительные ресурсы не обязательно обеспечивают более согласованные суждения.
В будущих исследованиях следует проверять судей на тех типах идей, которые им действительно предстоит оценивать, измерять чувствительность к промптам и моделям, улучшать интеграцию предыдущей литературы и создавать бенчмарки, способные развиваться вместе с ростом научной литературы и совершенствованием систем ИИ. Наш бенчмарк и многоразовый конвейер обработки данных — лишь отправная точка: исследователи могут применять их к новым рецензиям, другим научным сообществам и будущим поколениям судей новизны.
Автоматизированная генерация идей требует большего, чем создание правдоподобных исследовательских направлений; нам также нужны способы определить, когда эти идеи действительно новы. Сделав недостатки современных судей новизны более измеримыми, мы надеемся, что этот релиз поможет исследователям создавать более надёжные способы оценки исследовательских идей, сгенерированных ИИ.
Наборы данных, упомянутые в этой статье 1


Сообщество
· Зарегистрируйтесь или войдите, чтобы оставить комментарий
Наборы данных, упомянутые в этой статье 1
Переведено автоматически с английского. Оригинал статьи — по ссылке ниже.