Чи можемо ми довіряти LLM в оцінюванні новизни дослідницької ідеї?




Сьогодні ми публікуємо Старі ідеї, нові проблеми — нове дослідження того, наскільки надійно великі мовні моделі можуть оцінювати новизну ідей наукових досліджень. Разом зі статтею ми публікуємо бенчмарк, дані та код для тестування оцінювачів новизни, а також автоматизований конвеєр, який дослідники можуть використовувати для створення нових наборів оцінювання.
В Ai2 ми розробляємо системи штучного інтелекту, які підтримують різні етапи наукових відкриттів. DataVoyager допомагає дослідникам досліджувати й аналізувати структуровані дані, AutoDiscovery генерує та перевіряє гіпотези, а Theorizer синтезує докази з великих масивів наукової літератури в потенційні наукові теорії. Разом із Asta ці проєкти вказують на можливість створення систем, які допомагатимуть дослідникам переходити від розуміння попередніх робіт до висунення, перевірки та вдосконалення нових ідей.
Але генерування дослідницьких ідей — лише частина виклику автоматизації наукових відкриттів. Ці ідеї також мають робити справді новий внесок, а це означає, що таким системам потрібен спосіб відрізняти новий напрям від того, який переважно переупаковує вже наявні роботи.
Це завдання часто доручають іншій LLM — тому, що ми називаємо оцінювачем новизни. Оцінювачі новизни визначають, чи є дослідницька ідея новою порівняно з попередніми роботами, самостійно або в порівнянні з іншою ідеєю. Стандартного способу створення такого оцінювача не існує; дослідницькі команди обирають модель, промпт, формат оцінювання, бюджет міркувань, а іноді й систему пошуку літератури. Ці рішення можуть суттєво впливати на вердикт. Водночас таких оцінювачів часто перевіряють лише на написаних людьми статтях, а не на згенерованих ШІ ідеях, які вони насправді мають оцінювати.
Результати нашого нового бенчмарку свідчать, що саме оцінювання новизни далеко не є надійним. Для шести оцінювачів LLM — GPT-5.1, GPT-5.2, GPT-5.4, Claude Sonnet 4.5, Claude Opus 4.5 і Claude Opus 4.6 — здавалося б, незначні зміни в налаштуванні оцінювання призводять до кардинально різних оцінок тих самих ідей. В одному експерименті зміна лише кількох слів у промпті змінила точність моделі у визначенні того, яка з двох ідей є новішою, більш ніж на 50 відсоткових пунктів. Пошук і додаткове міркування не дають стабільного покращення оцінок, а дві спеціально створені системи оцінювання новизни працюють гірше за простий базовий варіант із промптом для Claude Opus 4.6.
Якщо ШІ відіграватиме більшу роль у наукових відкриттях, нам потрібні надійніші способи визначати, чи справді він пропонує щось нове. Наша робота надає інструменти для вивчення цієї проблеми, водночас показуючи, наскільки багато питань залишається невирішеними.
Створення бенчмарку для оцінювачів новизни
Щоб перевірити, наскільки надійно оцінювачі новизни можуть відрізняти більш нові дослідницькі ідеї від менш нових, нам спочатку були потрібні приклади, щодо яких існували вагомі докази оригінальності відповідного наукового внеску.
Тому ми створили автоматизований конвеєр на основі експертних оцінок ICLR 2026. Замість того щоб вважати прийняття статті непрямим показником новизни, ми проаналізували самі рецензії в пошуках уривків, де рецензенти прямо обговорювали оригінальність внеску. Ця відмінність є важливою: статтю можуть прийняти без особливої новизни, якщо вона достатньо сильна в інших аспектах. Так само відхилена стаття з оригінальним внеском може мати інші недоліки.
Ми створили пул високої новизни зі 154 написаних людьми дослідницьких ідей, відібравши прийняті статті з верхніх 10% у своїй дослідницькій категорії ICLR, рецензенти яких позитивно відзначили новизну і жоден із рецензентів не заперечив цього. Для створення пулу нижчої новизни ми застосували зворотні критерії: 145 ідей із відхилених статей із нижніх 10%, рецензенти яких висловили занепокоєння щодо оригінальності, і жоден рецензент позитивно не відзначив новизну. Під час окремої перевірки процесу аналізу рецензій анотатор погодився з визначеною полярністю сигналу новизни у 47 із 50 випадків; жодна з розбіжностей не змінила б того, чи вважався рецензент таким, що схвалює або заперечує новизну статті.
Разом ці два пули формують наше перше середовище оцінювання, Human-Only, яке перевіряє, чи можуть оцінювачі новизни відрізняти написані людьми ідеї з переконливими доказами вищої або нижчої новизни. Але на практиці оцінювачі новизни дедалі частіше використовуються для оцінювання ідей, згенерованих ШІ. Тому ми створили друге середовище — Human+Generated.
Для цього пулу ми поєднали ті самі 154 перевірені людські ідеї зі 154 ідеями, створеними простим генератором LLM. Ми припустили, що згенеровані ідеї є менш новими, ніж їхні написані людьми відповідники; це слабкі мітки, а не перевірені оцінки для кожної ідеї. Генератор отримував лише дослідницьку категорію та інструкцію запропонувати нову ідею — без пошуку літератури, інструментів, ітерацій чи зворотного зв’язку. Це дало нам консервативне порівняння між ідеями базового генератора та внесками зі статей ICLR із верхніх 10%, рецензенти яких прямо схвалили їхню оригінальність.
Для додаткової перевірки експерт незалежно розглянув 30 пар із набору Human+Generated, значною мірою зосередившись на випадках, де наш найсильніший оцінювач помилився, а також ми переписали людські та згенеровані ШІ ідеї в єдиній структурі, щоб перевірити, чи не реагували оцінювачі просто на відмінності у стилі написання. Експерт віддав перевагу людській ідеї в усіх 30 парах і не визнав новою жодну зі згенерованих ідей.
Важливо, що багато наших основних висновків взагалі не залежать від міток. Якщо два обґрунтовані налаштування оцінювання дають протилежні відповіді для тієї самої пари ідей, сама ця розбіжність виявляє нестабільність.
Незначні зміни можуть призводити до дуже різних вердиктів
Використовуючи наші набори написаних людьми та згенерованих ШІ дослідницьких ідей, ми перевірили, наскільки добре шість оцінювачів LLM — GPT-5.1, GPT-5.2, GPT-5.4, Claude Sonnet 4.5, Claude Opus 4.5 і Claude Opus 4.6 — можуть оцінювати новизну за допомогою поточкових (тобто абсолютних оцінок новизни) та попарних (тобто порівняння двох ідей для визначення новішої) порівнянь. Ми змінювали один фактор за раз: промпт, бюджет міркувань, доступ оцінювача до пов’язаних статей, форматування ідей, кількість об’єднаних оцінок для фінального вердикту та — для згенерованих ШІ ідей — модель, яка їх генерувала.
Найбільші зміни в результативності були пов’язані зі способом формулювання промпту для оцінювання новизни.
Наприклад, ми показали GPT-5.4 ті самі пари Human+Generated — кожна з яких містила одну перевірену написану людиною ідею та одну згенеровану ШІ ідею — з двома промптами. Один промпт повідомляв моделі, що рецензенти визнали новою рівно одну ідею в кожній парі, і просив визначити яку; інший просто запитував, яка ідея є новою. Після переходу до простішого промпту точність знизилася з 93,5% до 40,9% — нижче за випадковий рівень, — а модель змінила свій вердикт більш ніж для половини тих самих пар.
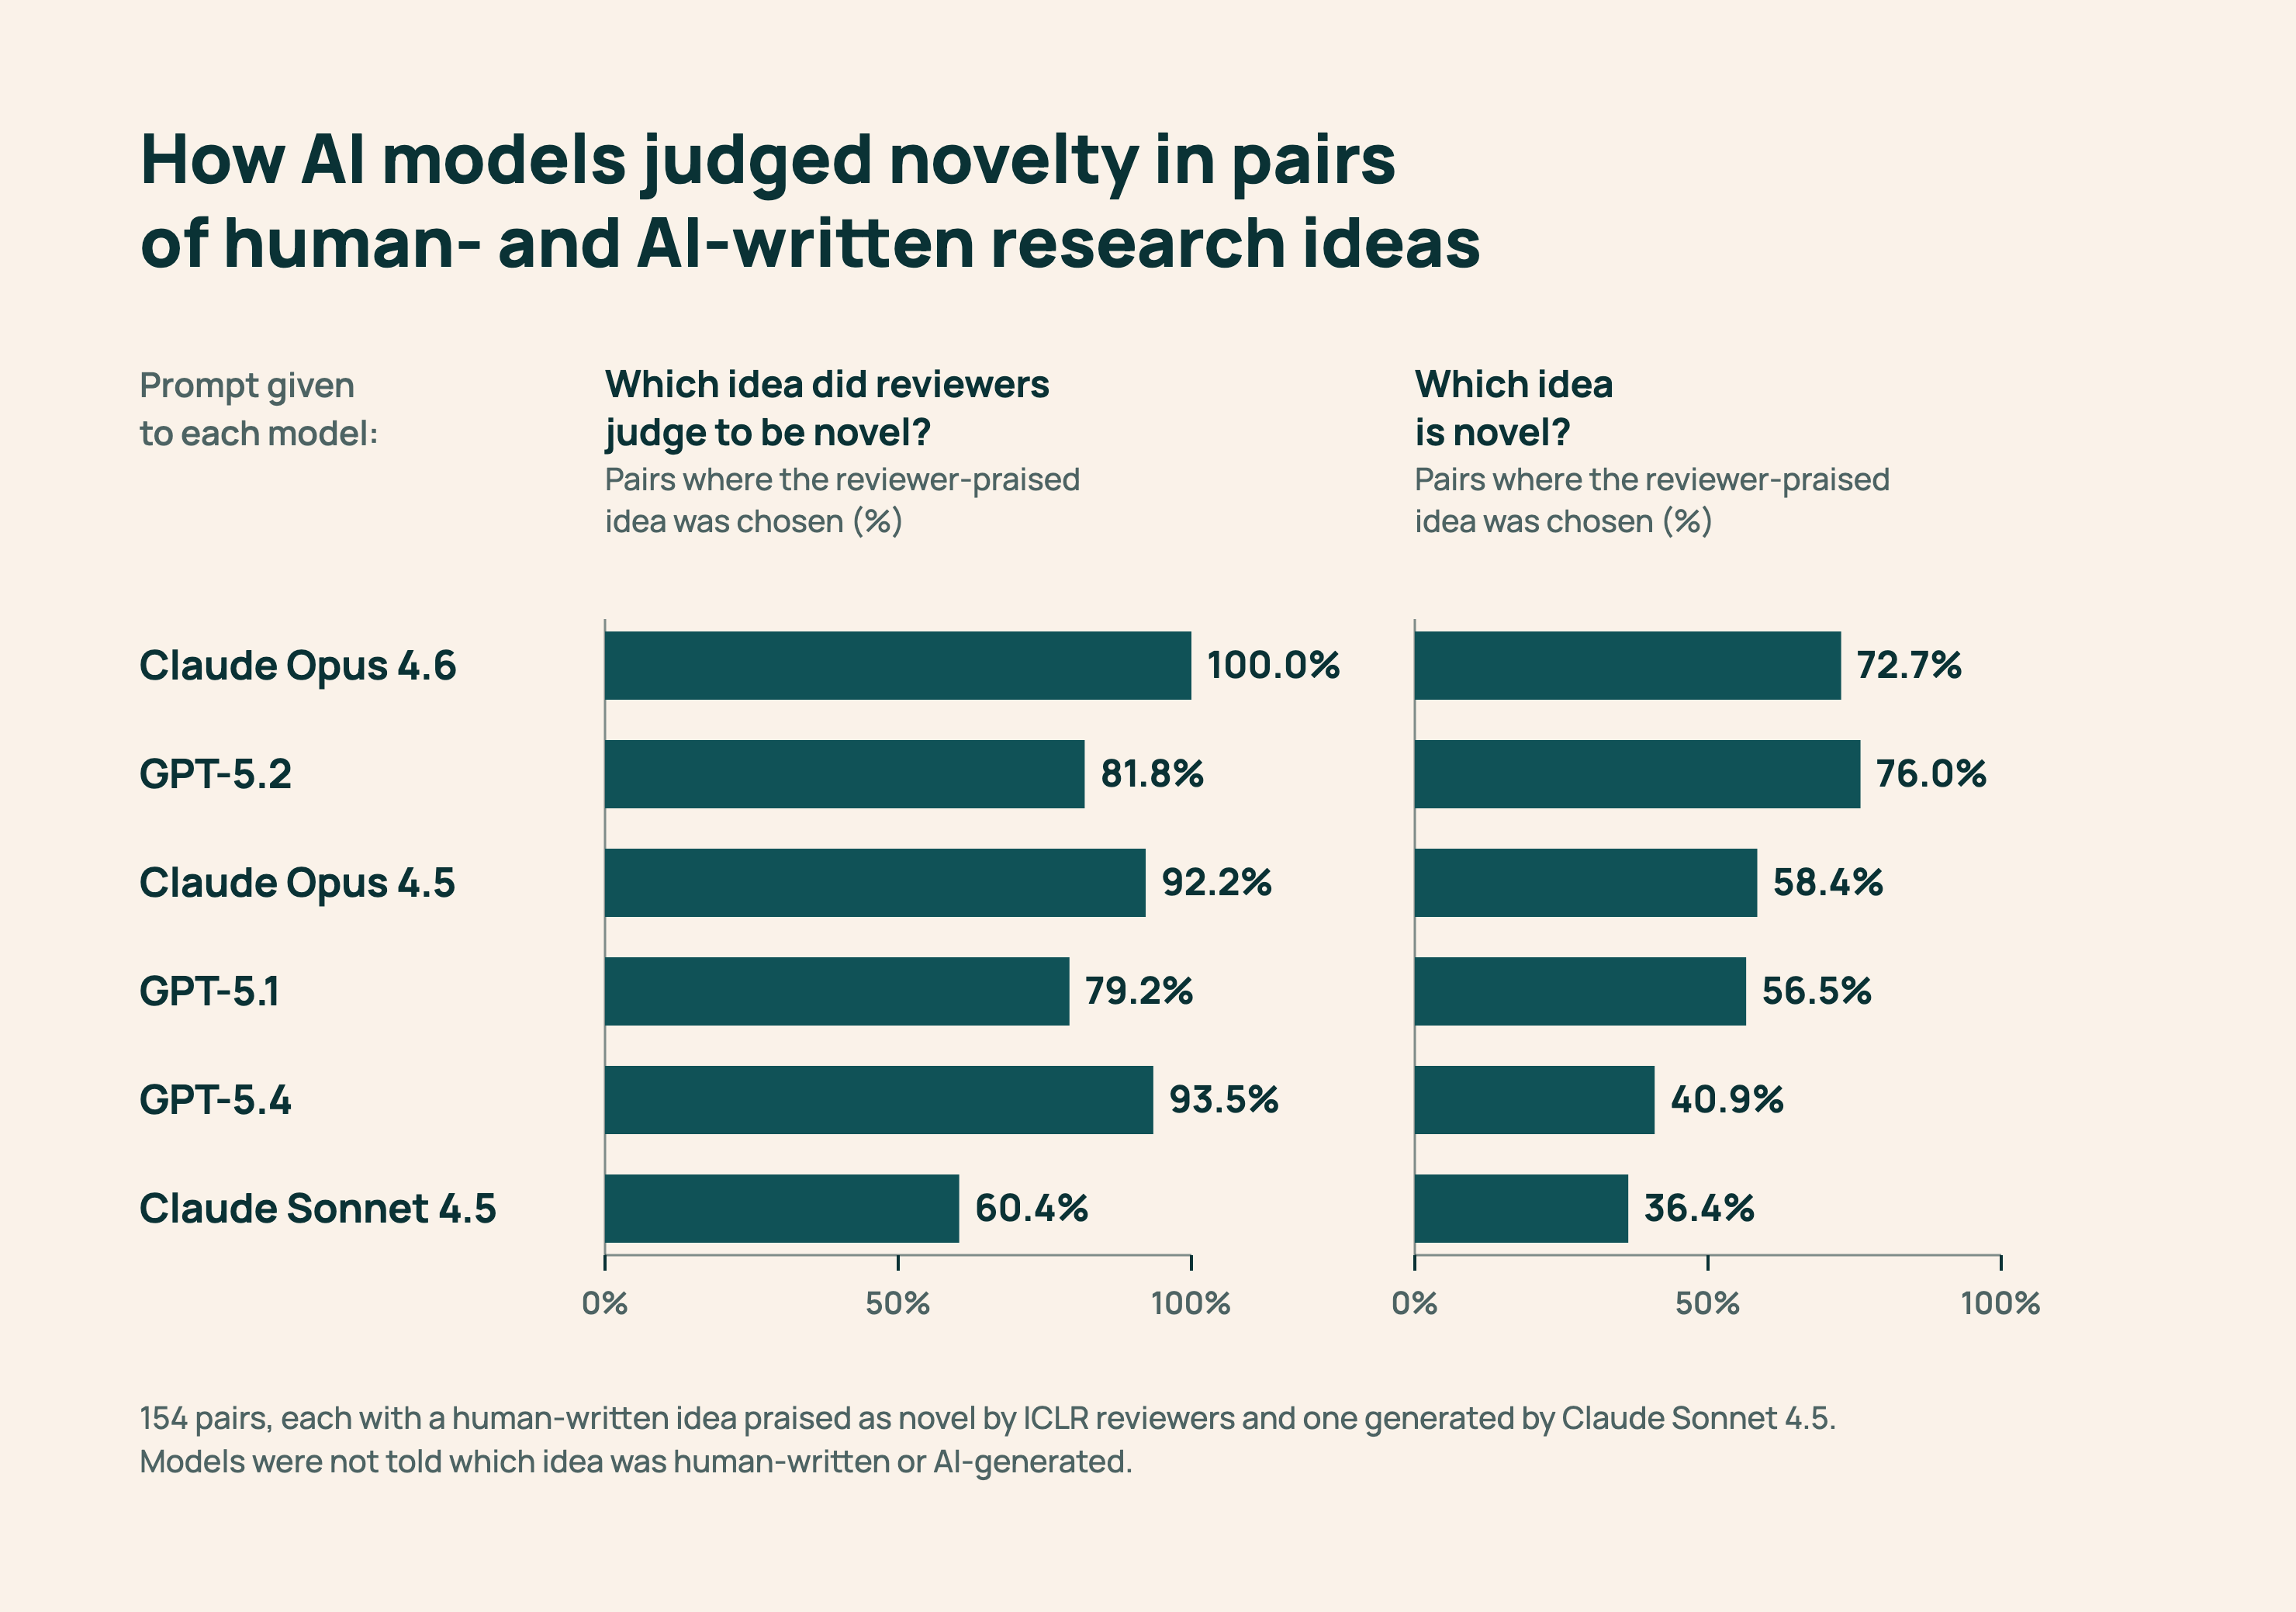
Натомість на наборі даних Human-Only, де людські ідеї поєднувалися з сильнішими та слабшими доказами новизни, та сама зміна промпту змістила точність лише приблизно на сім відсоткових пунктів. Це свідчить, що оцінювач новизни може здаватися відносно стабільним на написаних людьми дослідженнях, але поводитися зовсім інакше зі згенерованими ШІ ідеями.
Втім, написані людьми ідеї також не були захищені від цього. Ми побачили суттєві зміни і на наборі Human-Only; та сама зміна знизила точність Claude Opus 4.6 на 21 пункт. Просто ці зміни були менш значними, ніж для згенерованих ШІ ідей.
Також не існувало універсально кращого промпту. Наприклад, під час індивідуального оцінювання ідей вилучення інструкції, яка попереджала оцінювачів не вважати тривіальні або інкрементальні внески новими, підвищило точність для одних оцінювачів, водночас знизивши її для інших. Іншими словами, промпт, який добре працює для однієї моделі, може не переноситися на іншу.
Ми також протестували поширене застосування оцінювачів новизни: порівняння ідей від двох генераторів ШІ. Ми поєднали ідеї Claude Opus 4.5 із Claude Sonnet 4.5, а GPT-5.4 — із GPT-5.1. За протестованих змін промпту в середньому для шести оцінювачів змінювалася приблизно чверть або третина вердиктів. Цю розбіжність можна виміряти без припущення, який генератор створює новіші ідеї, що демонструє, як вибір промпту оцінювача може впливати на порівняння між системами генерування ідей.
Більший обсяг пошуку й міркувань не обов’язково приводив до кращих оцінок новизни. Ми надали GPT-5.6 Sol надзвичайно великий бюджет міркувань і можливість здійснювати живий ітеративний пошук, обмежений arXiv, а потім порівняли його зі стандартними оцінювачами з пошуком, кожен із яких бачив п’ять попередньо знайдених анотацій. (Усі оцінювачі в цьому порівнянні запускалися один раз для кожної ідеї з набору Human+Generated.) Агентний оцінювач отримав macro-F1 на рівні 0,78 — на 11 пунктів нижче за Claude Opus 4.6 із показником 0,89 і приблизно на тому самому рівні, що й простіші налаштування Claude Opus 4.5 та GPT-5.4, — водночас за поточними цінами API він коштував приблизно в 10 разів дорожче за одне рішення. (У цьому контексті macro-F1 вимірює, наскільки добре оцінювач визначає нові та ненові ідеї; що вище, то краще.)
Спеціально створені оцінювачі також не були точнішими, попри істотно вищу вартість. На наборі Human+Generated простий промпт Claude Opus 4.6 із низьким рівнем міркувань і голосуванням більшості за трьома викликами досяг macro-F1 0,854 за загальної вартості оцінювання 2,59 долара. Для порівняння, Idea Novelty Checker — конвеєр пошуку та повторного ранжування на основі літератури — отримав 0,642 за вартості 30,66 долара, тоді як AI Scientist від Sakana AI, чий оцінювач новизни ітеративно здійснює пошук у Semantic Scholar, отримав 0,772 за вартості 82,05 долара. (Обидва спеціалізовані оцінювачі використовували Claude Opus 4.6, по одному виклику на рішення.)
Іншими словами, простий базовий варіант із промптом був і точнішим, і значно дешевшим за обидві спеціально створені системи.
У сукупності ці результати свідчать, що оцінювання новизни є особливо нестійким щодо згенерованих ШІ ідей, які цим системам дедалі частіше доручають оцінювати.
До надійнішого оцінювання нових досліджень
Наші результати свідчать, що оцінювання новизни на основі LLM залишається важливою невирішеною проблемою. Оцінювачі, які здаються надійними для написаних людьми досліджень, можуть поводитися інакше зі згенерованими ШІ ідеями; промпти, що допомагають одній моделі, можуть шкодити іншій; а більший обсяг пошуку чи обчислень не обов’язково забезпечує стабільніші оцінки.
У майбутніх дослідженнях слід тестувати оцінювачів на тих типах ідей, які вони насправді оцінюватимуть, вимірювати чутливість до промптів і моделей, покращувати залучення попередньої літератури та створювати бенчмарки, здатні розвиватися разом зі зростанням наукової літератури й удосконаленням систем ШІ. Наш бенчмарк і багаторазово використовуваний конвеєр даних є відправною точкою — дослідники можуть застосовувати їх до нових експертних оцінок, інших наукових спільнот і майбутніх поколінь оцінювачів новизни.
Автоматизоване генерування ідей залежить не лише від створення правдоподібних напрямів досліджень; нам також потрібні способи визначати, коли ці ідеї справді є новими. Спрощуючи вимірювання недоліків сучасних оцінювачів новизни, ми сподіваємося, що цей реліз допоможе дослідникам створювати надійніші способи оцінювання дослідницьких ідей, згенерованих ШІ.
Набори даних, згадані в цій статті 1


Спільнота
· Зареєструйтеся або увійдіть, щоб прокоментувати
Набори даних, згадані в цій статті 1
Перекладено автоматично з англійської. Оригінал статті — за посиланням нижче.