Можем ли да се доверим на LLM за преценка дали дадена научна идея е новаторска?




Днес публикуваме Стари идеи, нови проблеми — ново изследване на това доколко надеждно големите езикови модели могат да оценяват новаторството на идеи за научни изследвания. Заедно със статията публикуваме бенчмарк, данни и код за тестване на оценители на новаторство, както и автоматизиран конвейер, който изследователите могат да използват за създаване на нови набори за оценяване.
В Ai2 разработваме AI системи, които подпомагат различни части от научното откривателство. DataVoyager помага на изследователите да изследват и анализират структурирани данни, AutoDiscovery генерира и проверява хипотези, а Theorizer синтезира доказателства от обширни научни публикации в потенциални научни теории. Заедно с Asta тези проекти сочат към системи, които могат да помогнат на изследователите да преминат от разбирането на предишни изследвания към предлагането, тестването и усъвършенстването на нови идеи.
Но генерирането на изследователски идеи е само част от предизвикателството при автоматизирането на научното откривателство. Тези идеи също трябва да допринасят с нещо действително ново, което означава, че системите се нуждаят от начин да различават новаторска посока от такава, която основно преопакова вече съществуваща работа.
Тази преценка често се поверява на друг LLM — това, което наричаме оценител на новаторството. Оценителите на новаторството преценяват дали дадена изследователска идея е нова спрямо предишни разработки, самостоятелно или в сравнение с друга идея. Няма стандартен начин за създаването им; изследователските екипи избират модел, подсказка, формат за оценяване, бюджет за разсъждение и понякога система за извличане на научна литература. Тези избори могат съществено да повлияят на заключението. Въпреки това оценителите често се валидират само върху статии, написани от хора, а не върху генерираните от AI идеи, които всъщност трябва да оценяват.
Резултатите от новия ни бенчмарк показват, че самото оценяване на новаторството далеч не е надеждно. При шест LLM оценители — GPT-5.1, GPT-5.2, GPT-5.4, Claude Sonnet 4.5, Claude Opus 4.5 и Claude Opus 4.6 — на пръв поглед малки промени в настройката за оценяване водят до драстично различни преценки за едни и същи идеи. В един експеримент промяната само на няколко думи в подсказката променя с над 50 процентни пункта точността на модела при определянето коя от две идеи е по-новаторска. Извличането на информация и допълнителното разсъждение не подобряват последователно преценките, а две специално създадени системи за оценяване на новаторството се представят по-зле от проста базова конфигурация с подсказка към Claude Opus 4.6.
Ако AI ще играе по-голяма роля в научното откривателство, се нуждаем от по-надеждни начини да установяваме дали той действително предлага нещо ново. Нашата работа предоставя инструменти за изследване на този проблем, като същевременно показва колко много остава нерешено.
Създаване на бенчмарк за оценители на новаторството
За да проверим доколко надеждно оценителите на новаторството могат да различават по-новаторски от по-малко новаторски изследователски идеи, първо се нуждаехме от примери, за които има силни доказателства за оригиналността на заложения научен принос.
Затова създадохме автоматизиран конвейер около рецензиите на ICLR 2026. Вместо да приемаме одобряването на статията като показател за новаторство, извлякохме от самите рецензии пасажи, в които рецензентите изрично обсъждат оригиналността на даден принос. Това разграничение е ключово: една статия може да бъде приета, без да е особено новаторска, ако е достатъчно силна в други аспекти. Също така отхвърлена статия с оригинален принос може да има други слабости.
Създадохме набор с високо новаторство от 154 изследователски идеи, написани от хора, като избрахме приети статии от най-високо оценените 10% в съответната изследователска област на ICLR, чиито рецензенти положително са установили новаторство и никой рецензент не го е оспорил. Приложихме обратните критерии, за да създадем набор с по-ниско новаторство: 145 идеи от отхвърлени статии в долните 10%, чиито рецензенти са изразили опасения относно оригиналността, без нито един рецензент да е посочил положително новаторство. При отделна проверка на процеса по извличане от рецензиите анотатор се съгласи с извлечената полярност на сигнала за новаторство в 47 от 50 случая; нито едно от несъгласията не би променило това дали даден рецензент се счита за хвалещ или оспорващ новаторството на статията.
Заедно тези два набора образуват първата ни среда за оценяване, Само от хора, която проверява дали оценителите на новаторството могат да различават идеи, написани от хора, за които има силни доказателства за по-високо или по-ниско новаторство. На практика обаче оценителите на новаторството все по-често се използват за оценяване на генерирани от AI идеи. Затова създадохме втора среда, Хора+генерирани.
За този набор сдвоихме същите 154 валидирани човешки идеи със 154 идеи, произведени от прост LLM генератор. Приемаме, че генерираните идеи са по-малко новаторски от съответстващите им идеи, написани от хора; това са слаби етикети, а не проверени преценки за всяка отделна идея. Генераторът получаваше само научна област и инструкция да предложи новаторска идея, без търсене в литературата, инструменти, итерации или обратна връзка. Така получихме консервативно сравнение между идеи от базов генератор и приноси от статии на ICLR в най-високите 10%, чиито рецензенти изрично са потвърдили оригиналността им.
Като допълнителни проверки експерт независимо прегледа 30 двойки от набора Хора+генерирани, с голям превес на случаите, в които най-силният ни оценител е допуснал грешка, а идеите, генерирани от хора и AI, бяха преформулирани в обща структура, за да проверим дали оценителите просто реагират на различия в стила на писане. Експертът предпочете човешката идея и в 30-те двойки и не определи нито една от генерираните идеи като новаторска.
Важно е, че много от основните ни констатации не зависят изобщо от етикетите. Ако две разумни настройки за оценяване дадат противоположни отговори за една и съща двойка идеи, самото несъгласие разкрива нестабилност.
Малките промени могат да доведат до много различни заключения
Използвайки колекциите си от изследователски идеи, написани от хора и генерирани от AI, проверихме доколко шест LLM оценители — GPT-5.1, GPT-5.2, GPT-5.4, Claude Sonnet 4.5, Claude Opus 4.5 и Claude Opus 4.6 — могат да оценяват новаторството чрез сравнения поотделно (т.е. абсолютни оценки за новаторство) и по двойки (т.е. сравняване на две идеи, за да се открие по-новаторската). Променяхме по един фактор: подсказката, бюджета за разсъждение, това дали оценителят може да вижда свързани статии, формата на идеите, броя на оценките, обединени в окончателно заключение, и — при генерираните от AI идеи — кой модел ги е генерирал.
Най-големите промени в представянето произтичаха от начина, по който подканвахме модела да оценява новаторството.
Например показахме на GPT-5.4 същите двойки от набора Хора+генерирани — всяка съдържаща една валидирана идея, написана от човек, и една, генерирана от AI — с две подсказки. Едната подсказка казваше на модела, че рецензентите са установили, че точно една идея във всяка двойка е новаторска, и го молеше да посочи коя; другата просто питаше коя идея е новаторска. Когато преминахме към по-простата подсказка, точността спадна от 93,5% на 40,9% — под нивото на случайния избор — а моделът промени заключението си за повече от половината от същите двойки.
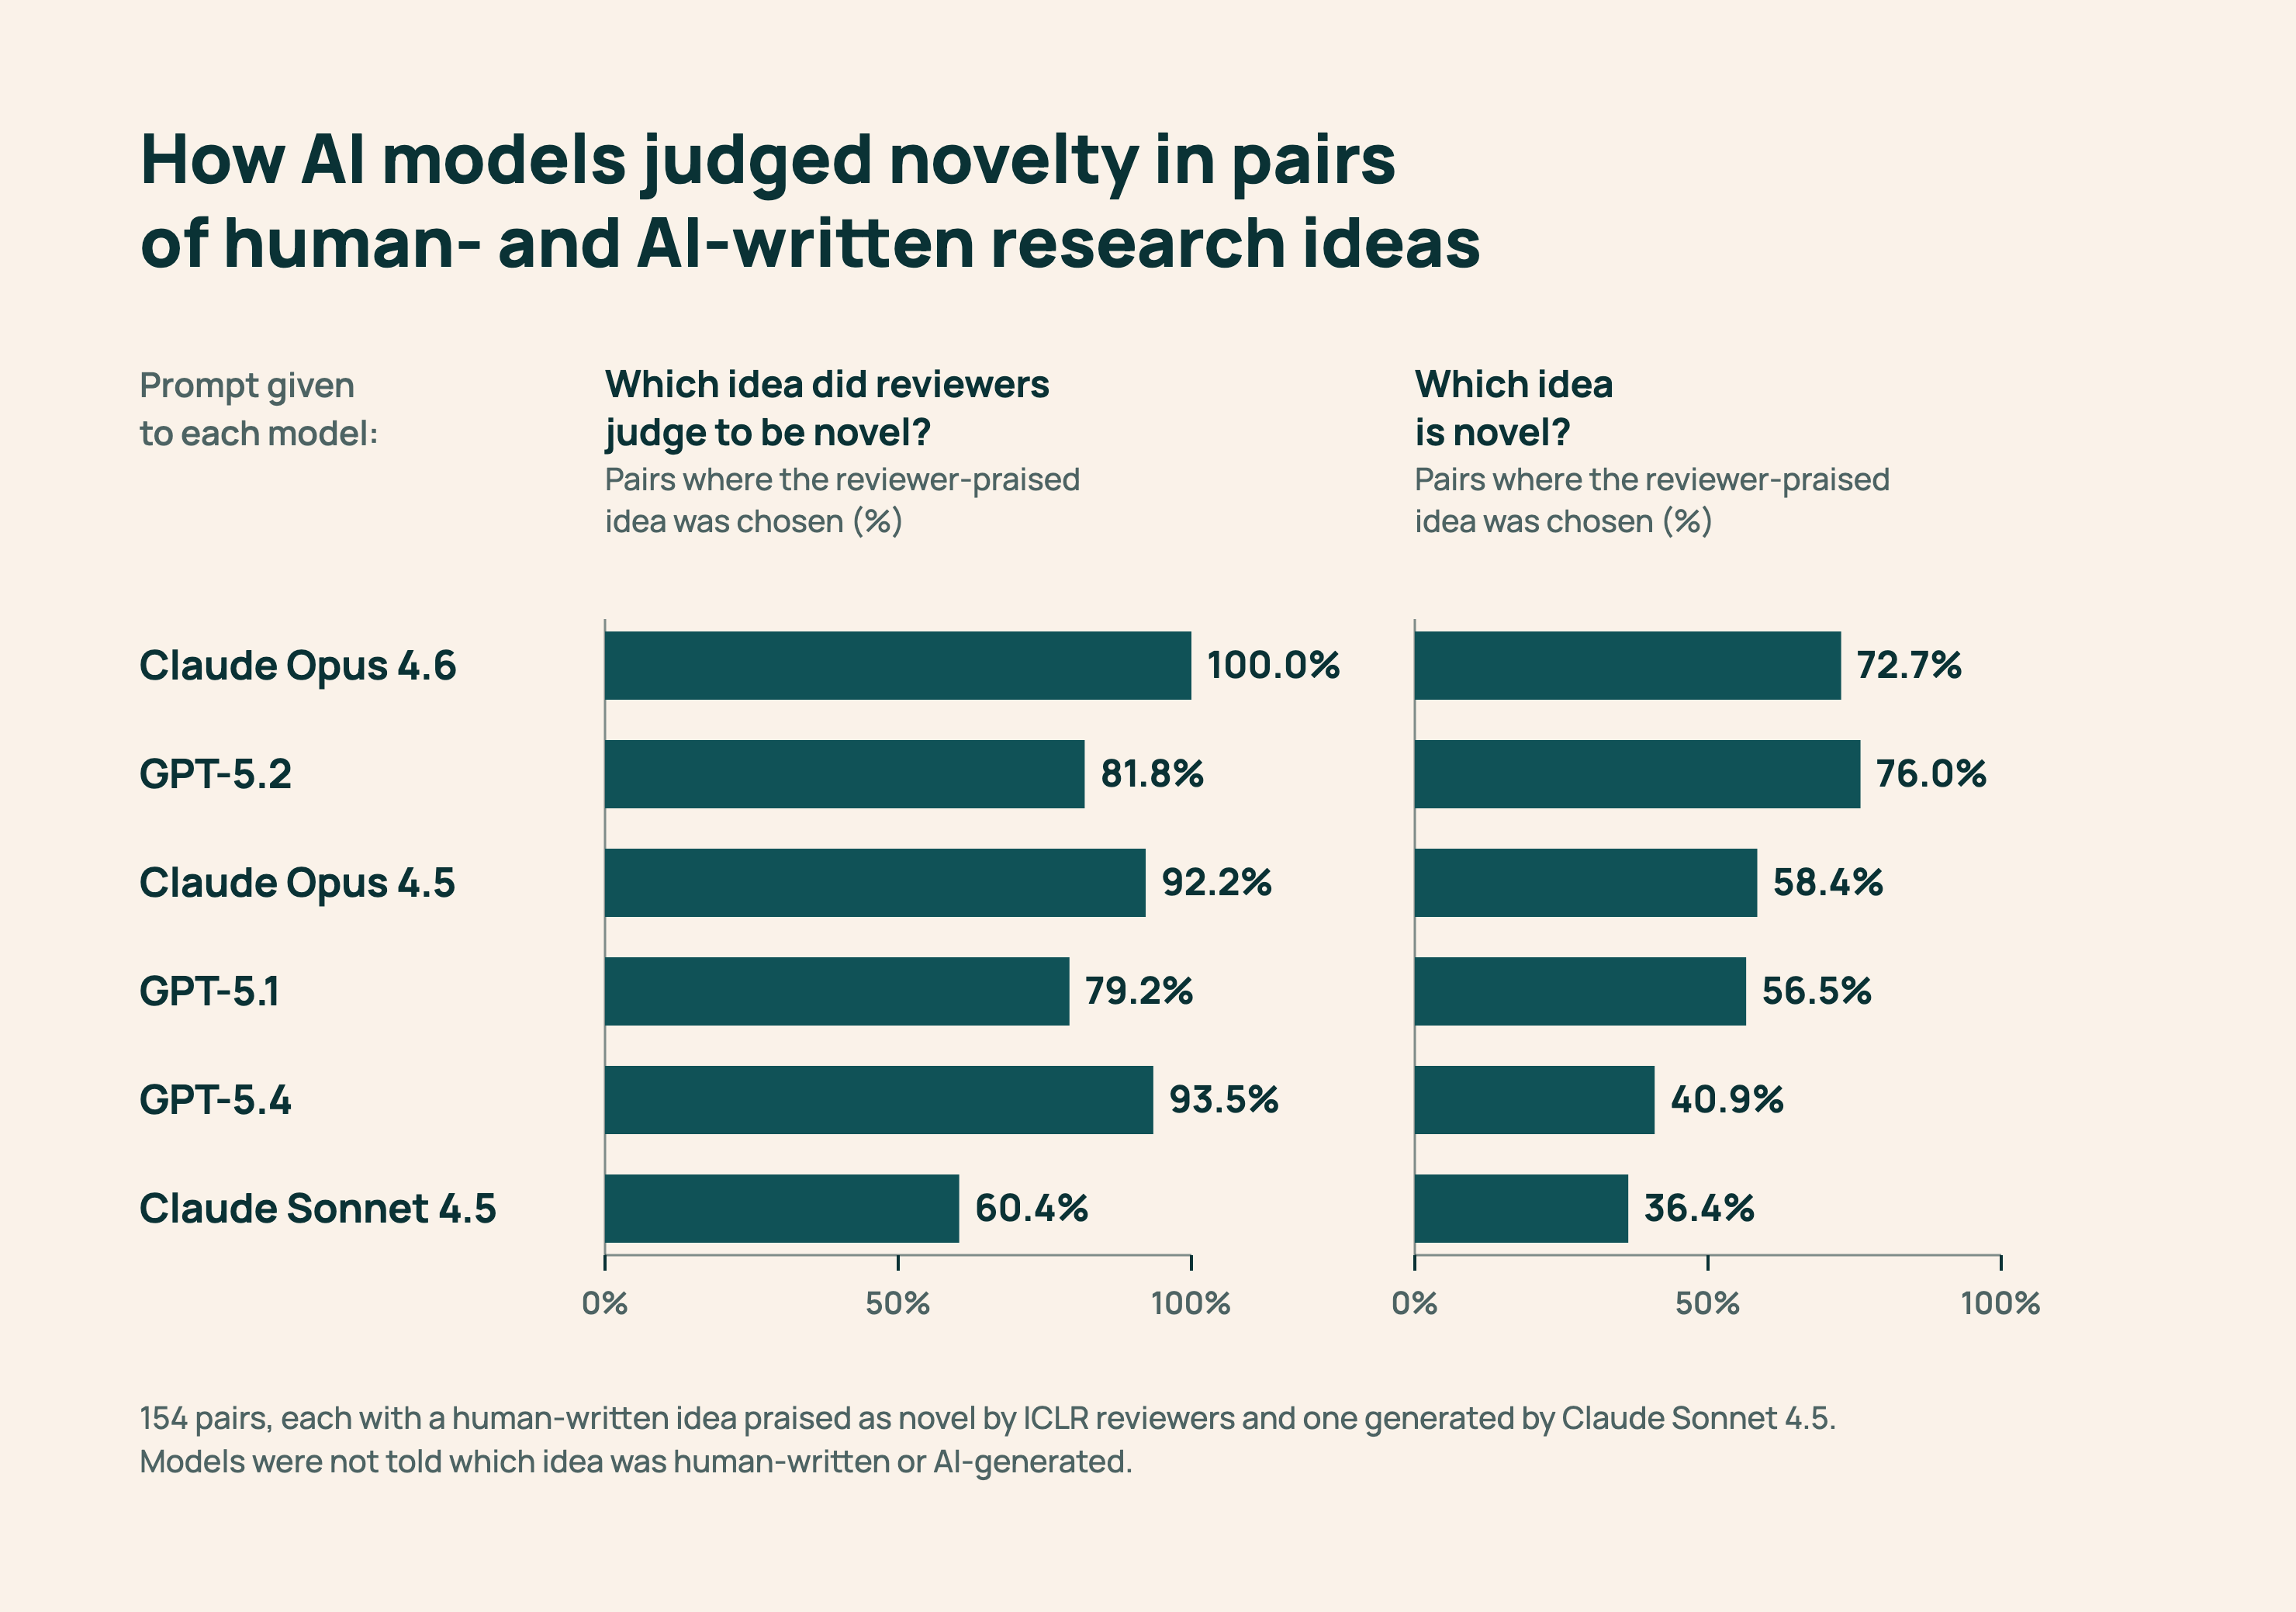
За разлика от това, същата промяна в подсказката промени точността само с около седем процентни пункта в набора Само от хора, който съпоставя идеи, написани от хора, с по-силни и по-слаби доказателства за новаторство. Това подсказва, че оценителят на новаторството може да изглежда сравнително стабилен при човешки изследвания, но да се държи много различно при генерирани от AI идеи.
Това не означава, че човешките идеи са били имунизирани. Наблюдавахме значителни промени и в набора Само от хора; същата промяна повиши точността на Claude Opus 4.6 с 21 пункта. Промените просто бяха по-малко драстични от тези при генерираните от AI идеи.
Освен това нямаше универсално по-добра подсказка. Например при индивидуално оценяване на идеи премахването на инструкцията, която предупреждаваше оценителите да не приемат тривиалните или постепенните приноси за новаторски, подобри точността при някои оценители, но я понижи при други. С други думи, подсказка, която работи добре за един модел, може да не се пренесе към друг.
Проверихме и често срещана употреба на оценителите на новаторството: сравняване на идеи от два AI генератора. Сдвоихме идеи от Claude Opus 4.5 с такива от Claude Sonnet 4.5, както и GPT-5.4 с GPT-5.1. При тестваните промени в подсказките средно между около една четвърт и една трета от заключенията се промениха при шестте оценители. Това несъгласие може да се измери, без да приемаме кой генератор създава по-новаторски идеи, което показва как изборът на подсказка за оценителя може да повлияе на сравненията между системите за генериране на идеи.
Повече търсене и разсъждение не доведоха непременно до по-добри преценки за новаторство. Дадохме на GPT-5.6 Sol изключително голям бюджет за разсъждение и достъп до живо, итеративно търсене, ограничено до arXiv, след което го сравнихме със стандартни оценители с извличане, всеки от които виждаше пет предварително извлечени резюмета. (Всички оценители в това сравнение бяха изпълнени по веднъж за всяка идея от набора Хора+генерирани.) Агентният оценител постигна 0,78 macro-F1 — с 11 пункта по-малко от Claude Opus 4.6 с 0,89 и приблизително на същото ниво като по-простите конфигурации с Claude Opus 4.5 и GPT-5.4 — като при текущите цени на API струваше приблизително 10 пъти повече за едно решение. (В този контекст macro-F1 измерва доколко добре оценителят идентифицира новаторски и неноваторски идеи; по-високата стойност е по-добра.)
Специално създадените оценители също не бяха по-точни, въпреки че струваха значително повече. В набора Хора+генерирани проста подсказка към Claude Opus 4.6 с ниско ниво на разсъждение и гласуване с мнозинство между три извиквания постигна 0,854 macro-F1 при обща цена за оценяването от 2,59 долара. За сравнение, Idea Novelty Checker — конвейер за извличане и повторно подреждане, основан на научна литература — постигна 0,642 при цена от 30,66 долара, докато AI Scientist на Sakana AI, чийто оценител на новаторството итеративно търси в Semantic Scholar, постигна 0,772 при цена от 82,05 долара. (И двата специализирани оценителя използваха Claude Opus 4.6 с едно извикване за всяко решение.)
С други думи, базовата конфигурация с проста подсказка беше едновременно по-точна и значително по-евтина от двете специално създадени системи.
Взети заедно, тези резултати показват, че оценяването на новаторството е особено нестабилно при генерираните от AI идеи, които все по-често се възлагат на тези системи да оценяват.
Към по-надеждно оценяване на новаторски изследвания
Резултатите ни показват, че оценяването на новаторството с LLM остава голям нерешен проблем. Оценители, които изглеждат надеждни при изследвания, написани от хора, могат да се държат различно при генерирани от AI идеи; подсказки, които помагат на един модел, могат да навредят на друг; а повече търсене или изчислителни ресурси не водят непременно до по-последователни преценки.
Бъдещите изследвания трябва да тестват оценителите върху същите видове идеи, които действително ще оценяват, да измерват чувствителността към различни подсказки и модели, да подобрят начина, по който се включва предишната литература, и да създават бенчмаркове, които се развиват с разрастването на научната литература и усъвършенстването на AI системите. Нашият бенчмарк и повторно използваемият конвейер за данни са отправна точка — изследователите могат да ги прилагат към нови рецензии, други научни общности и бъдещи поколения оценители на новаторството.
Автоматизираното генериране на идеи зависи от повече от създаването на правдоподобни изследователски посоки; нуждаем се и от начини да установяваме кога тези идеи са действително нови. Като правим слабостите на настоящите оценители на новаторството по-лесни за измерване, се надяваме това публикуване да помогне на изследователите да изградят по-надеждни начини за оценяване на генерирани от AI изследователски идеи.
Набори от данни, споменати в тази статия 1


Общност
· Регистрирайте се или влезте в профила си, за да коментирате
Набори от данни, споменати в тази статия 1
Преведено автоматично от английски. Оригиналната статия е на връзката по-долу.