EmbeddingGemma 2: відкрита легка мультимодальна модель для створення ембедингів

06 жовтня 2026 р.
|EmbeddingGemma 2 — це найпотужніша модель для мультимодальних векторних представлень на пристрої, яка нативно відображає комбінації тексту, зображень, аудіо та відео в єдиний простір векторних представлень.
Sahil Dua
Інженер-дослідник, Google DeepMind
Henrique Schechter Vera
Інженер-дослідник, Google DeepMind
Минулого року ми представили EmbeddingGemma, щоб запропонувати легке рішення для високоякісних текстових векторних представлень і допомогти вашим застосункам упорядковувати, знаходити та пов’язувати інформацію безпосередньо на споживчих пристроях. Реакція спільноти розробників значно перевершила наші очікування. Понад 20 мільйонів завантажень свідчать про те, що розробники використовують модель для створення розумніших інструментів пошуку на пристрої та конвеєрів генерації з доповненням пошуку (RAG), орієнтованих на конфіденційність.
Сьогодні ми запускаємо EmbeddingGemma 2, яка виходить за межі тексту, об’єднуючи код, зображення, відео й аудіо в спільному просторі векторних представлень. Створена на основі архітектури Gemma 4 і випущена за комерційно ліберальною ліцензією Apache 2.0, EmbeddingGemma 2 має 740 мільйонів параметрів, що робить її оптимальною для виконання на пристрої. Вона може допомогти знайти конкретний відеофрагмент за голосовою нотаткою або здійснити пошук у багатогодинних аудіозаписах за текстовим запитом — усе це обробляється однією нативно мультимодальною моделлю.
Створена на основі тієї самої технології, що й моделі Gemini Embedding, EmbeddingGemma 2:
- Найкраща у своєму класі для свого розміру: Демонструє провідні результати серед мультимодальних моделей векторних представлень із менш ніж 1 мільярдом параметрів у таких тестах, як MTEB (Massive Text Embedding Benchmark) Code і MAEB (Massive Audio Embedding Benchmark), водночас відповідаючи результатам або перевершуючи багато більших моделей у завданнях роботи з текстом, зображеннями та аудіо.
- Модульна за задумом: Для текстових завдань потрібно лише 270 мільйонів параметрів, а для повної мультимодальної підтримки можна додатково використовувати кодери зображень (170 мільйонів) і аудіо (300 мільйонів).
- Ефективна щодо сховища: Завдяки навчанню матрьошкових представлень (MRL) розробники можуть динамічно скорочувати вихідні вектори з 768 до 512, 256 або 128 вимірів. Це забезпечує до 6-кратного зменшення обсягу локальних векторних баз даних і використання пам’яті.
- Оптимізована для продуктивності на пристрої: Ефективно працює в умовах суворих ресурсних обмежень. Після квантування на Google Pixel 11 Pro EmbeddingGemma 2 потребує лише близько 191 МБ активної оперативної пам’яті для текстових ваг і близько 567 МБ для повної мультимодальної моделі.
- Готова до розширеного контексту: Має контекстне вікно на 8 тисяч токенів (у 4 рази більше, ніж EmbeddingGemma 1), що дає змогу обробляти до 5,5 хвилини аудіо, 29 зображень, 58 відеокадрів або їхні черговані комбінації безпосередньо на локальному обладнанні.
Досягнення найвищої якості для коду, зображень і аудіо
EmbeddingGemma 2 зберігає високі багатомовні результати EmbeddingGemma у роботі з текстом і водночас забезпечує значне покращення результатів для коду на 9,92 бала (у MTEB Code — з 68,76 до 78,68), що робить її добре придатною для локального індексування кодових баз, семантичного пошуку коду та пошуку інформації агентами програмування. У роботі із зображеннями, відео, документами й аудіо вона встановлює новий стандарт якості на один параметр для моделей із менш ніж 1 мільярдом параметрів і навіть перевершує деякі спеціалізовані моделі, які більш ніж удвічі більші за неї.
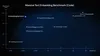
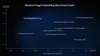
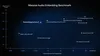
Повні показники оцінювання та інформацію про модель дивіться в картці моделі EmbeddingGemma 2.
Семантичний пошук, маршрутизація та пошук інформації повністю на пристрої
EmbeddingGemma 2 забезпечує надійні можливості безпосередньо на периферійному обладнанні. Локальне створення векторних представлень допомагає забезпечити конфіденційність даних, зменшує затримку конвеєра та дає розробникам змогу створювати крос-модальний пошук і пошук інформації, які повністю працюють офлайн.
У поєднанні з генеративними моделями, такими як Gemma 4, EmbeddingGemma 2 забезпечує роботу конвеєрів RAG на пристрої, здатних розуміти складні мультимодальні дані. Оскільки EmbeddingGemma 2 створена на основі Gemma 4 і використовує її токенізатор тексту та аудіокодер, розробники можуть запускати обидві моделі разом у єдиному конвеєрі з меншим сумарним обсягом використовуваної пам’яті.
Використовуйте текст або зображення, щоб знаходити найбільш відповідні об’єкти у своїй медіатеці на основі семантичної схожості. Спробуйте цю функцію в Instant Media Search у Google AI Edge Gallery.
Знаходьте конкретні моменти у відео за допомогою текстових або аудіозапитів. Спробуйте цю функцію у Video Moments Finder у Google AI Edge Gallery.
Поєднайте EmbeddingGemma 2 для локального пошуку файлів із Gemma 4 для контекстного міркування. Спробуйте це в застосунку Google AI Edge Foresight.
Створюйте механізми ухвалення рішень у реальному часі, використовуючи мультимодальний контекст для класифікації, маршрутизації та прогнозування через MediaPipe Decision Task API.
Щоб дізнатися, як створювати системи пошуку та RAG на пристрої за допомогою LiteRT, прочитайте допис у блозі Google AI Edge.
Початок роботи з EmbeddingGemma 2
Ми тісно співпрацювали з такими партнерами, щоб EmbeddingGemma 2 одразу працювала там, де ви розробляєте:
- Завантаження моделей: Знайдіть ваги моделі на Hugging Face і Kaggle; доступність у каталозі моделей Gemini Enterprise Agent Platform з’явиться незабаром. Відвідайте LiteRT Community на Hugging Face, щоб знайти моделі, оптимізовані для роботи на пристрої.
- Розгортання на пристрої: Розробляйте кросплатформні застосунки за допомогою Google AI Edge MediaPipe для готових до використання завдань векторизації, пошуку та ухвалення рішень або LiteRT для інтеграції власних моделей. Створюйте застосунки для браузера за допомогою transformers.js або WebGPU.
- Використання улюблених інструментів розробки: Ефективно обслуговуйте модель за допомогою transformers, sentence-transformers, MLX, vLLM, llama.cpp, SGLang, Ollama і LMStudio. Зберігайте свої вектори векторних представлень за допомогою Qdrant.
- Дообучення: Скористайтеся рекомендаціями Unsloth щодо дообучення EmbeddingGemma 2 для ваших сценаріїв використання.
Ознайомтеся з нашим посібником для розробників, документацією, а також посібниками з виконання висновків і дообучення.
Перекладено автоматично з англійської. Оригінал статті — за посиланням нижче.