EmbeddingGemma 2: отворен, лек мултимодален модел за ембединг

6 октомври 2026 г.
|EmbeddingGemma 2 е най-способният модел за мултимодални вграждания на устройството, който естествено преобразува комбинации от текст, изображения, аудио и видео в единно пространство за вграждане.
Sahil Dua
Изследователски инженер, Google DeepMind
Henrique Schechter Vera
Изследователски инженер, Google DeepMind
Миналата година представихме EmbeddingGemma, за да предложим лек вариант за висококачествени текстови вграждания, който да помогне на приложенията ви да организират, търсят и свързват информация директно на потребителски устройства. Реакцията на общността от разработчици надмина очакванията ни. С над 20 милиона изтегляния създателите го използваха за по-интелигентни инструменти за търсене на устройството и базирани на поверителността конвейери за генериране с разширено извличане (RAG).
Днес представяме EmbeddingGemma 2, който разширява обхвата отвъд текста, за да обедини код, изображения, видео и аудио в споделено пространство за вграждане. Създаден на базата на архитектурата Gemma 4 и разпространяван под търговски либералния лиценз Apache 2.0, EmbeddingGemma 2 има 740 милиона параметъра, което го прави оптимален за инференция на устройството. Той може да помогне да намерите конкретен видеоклип от гласова бележка или да търсите в часове аудиозаписи по текстова заявка — всичко това се обработва от един естествено мултимодален модел.
Създаден със същата технология като моделите Gemini Embedding, EmbeddingGemma 2 е:
- Най-добрият в класа си за своя размер: Постига водещи резултати сред мултимодалните модели за вграждане с под 1 милиард параметъра, като показва силни резултати в бенчмаркове като MTEB (Massive Text Embedding Benchmark) Code и MAEB (Massive Audio Embedding Benchmark), като същевременно се изравнява с или надминава много по-големи модели при задачи с текст, изображения и аудио.
- Модулен по замисъл: Изисква едва 270 милиона параметъра за задачи само с текст, с опционални енкодери за изображения (170 милиона) и аудио (300 милиона) за пълна мултимодална поддръжка.
- Ефективен по отношение на съхранението: С помощта на Matryoshka Representation Learning (MRL) разработчиците могат динамично да съкращават изходните вектори от 768 до 512, 256 или 128 измерения. Това осигурява до 6 пъти по-малко място за локални векторни бази данни и използване на памет.
- Оптимизиран за производителност на устройството: Работи ефективно при строги ресурсни ограничения. При квантуване на Google Pixel 11 Pro EmbeddingGemma 2 изисква едва около 191 MB активна RAM за теглата само за текст и около 567 MB за пълния мултимодален модел.
- Готов за разширен контекст: Разполага с контекстен прозорец от 8K токена (4 пъти по-голям от този на EmbeddingGemma 1), което му позволява да обработва до 5,5 минути аудио, 29 изображения, 58 видеокадъра или комбинации от тях директно на локалния хардуер.
Постигане на водещо качество за код, изображения и аудио
EmbeddingGemma 2 се изравнява със силната многоезична производителност на EmbeddingGemma при текст, като същевременно осигурява значително подобрение от 9,92 точки при кода (в MTEB Code — от 68,76 до 78,68), което го прави подходящ за локално индексиране на кодови бази, семантично търсене в код и извличане за агенти за програмиране. При изображения, видео, документи и аудио той поставя нов стандарт за качество на параметър при модели с под 1 милиард параметъра и дори надминава някои специализирани модели, които са повече от два пъти по-големи.
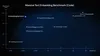
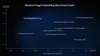
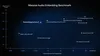
Пълните показатели от оценяването и информация за модела можете да намерите в картата на модела EmbeddingGemma 2.
Активиране на семантично търсене, маршрутизиране и извличане изцяло на устройството
EmbeddingGemma 2 предоставя стабилни възможности директно на периферния хардуер. Локалното генериране на вграждания помага да се гарантира поверителността на данните, намалява латентността на конвейера и дава възможност на разработчиците да създават междумодално търсене и извличане, които работят изцяло офлайн.
В комбинация с генеративни модели като Gemma 4 EmbeddingGemma 2 позволява RAG конвейери на устройството, които разбират сложни мултимодални данни. Тъй като EmbeddingGemma 2 е изграден върху Gemma 4 и споделя неговия токенизатор за текст и аудио енкодер, разработчиците могат да изпълняват двата модела заедно в единен конвейер с по-малък общ отпечатък върху паметта.
Използвайте текст или изображение, за да намерите най-подходящите съвпадения във вашата медиатека въз основа на семантично сходство. Изпробвайте го в Instant Media Search на Google AI Edge Gallery.
Намирайте конкретни моменти във видео чрез текстови или аудиозаявки. Изпробвайте го във Video Moments Finder на Google AI Edge Gallery.
Комбинирайте EmbeddingGemma 2 за локално извличане на файлове с Gemma 4 за контекстуално разсъждение. Изпробвайте го в приложението Google AI Edge Foresight.
Създавайте механизми за вземане на решения в реално време, използващи мултимодален контекст за класификация, маршрутизиране и прогнозни възможности чрез MediaPipe Decision Task API.
За да научите как да създавате системи за търсене и RAG на устройството с LiteRT, прочетете публикацията в блога на Google AI Edge.
Първи стъпки с EmbeddingGemma 2
Работихме в тясно сътрудничество със следните партньори, за да гарантираме, че EmbeddingGemma 2 работи веднага там, където разработвате:
- Изтеглете моделите: Намерете теглата на модела в Hugging Face и Kaggle, като достъпността в Model Garden на Gemini Enterprise Agent Platform предстои скоро. Посетете LiteRT Community в Hugging Face за модели, оптимизирани за работа на устройството.
- Внедряване на устройството: Разработвайте междуплатформени приложения с Google AI Edge MediaPipe за готови за употреба задачи за вграждане, извличане и вземане на решения или с LiteRT за интегриране на персонализирани модели. Създавайте приложения за браузъра с transformers.js или WebGPU.
- Използвайте любимите си инструменти за разработка: Обслужвайте модела ефективно чрез transformers, sentence-transformers, MLX, vLLM, llama.cpp, SGLang, Ollama и LMStudio. Съхранявайте векторите на вгражданията си с Qdrant.
- Фино настройване: Следвайте указанията на Unsloth за това как да настроите фино EmbeddingGemma 2 за своите случаи на употреба.
Разгледайте нашето ръководство за разработчици, документацията и ръководствата за инференция и фино настройване.
Преведено автоматично от английски. Оригиналната статия е на връзката по-долу.