EmbeddingGemma 2: открытая облегчённая мультимодальная модель эмбеддингов

06 окт. 2026 г.
|EmbeddingGemma 2 — самая функциональная модель для мультимодальных эмбеддингов на устройствах, которая изначально отображает сочетания текста, изображений, аудио и видео в единое пространство эмбеддингов.
Sahil Dua
Инженер-исследователь, Google DeepMind
Henrique Schechter Vera
Инженер-исследователь, Google DeepMind
В прошлом году мы представили EmbeddingGemma, чтобы предложить лёгкий вариант для высококачественных текстовых эмбеддингов, помогающих вашим приложениям организовывать, искать и связывать информацию непосредственно на потребительских устройствах. Отклик сообщества разработчиков превзошёл все наши ожидания. Более 20 миллионов загрузок — разработчики используют модель для создания более интеллектуальных инструментов поиска на устройствах и ориентированных на конфиденциальность конвейеров генерации с дополнением поиска (RAG).
Сегодня мы запускаем EmbeddingGemma 2, выходя за пределы текста и объединяя код, изображения, видео и аудио в общем пространстве эмбеддингов. Созданная на основе архитектуры Gemma 4 и выпущенная по коммерчески разрешительной лицензии Apache 2.0, EmbeddingGemma 2 содержит 740 миллионов параметров, что делает её оптимальной для вывода на устройствах. Она может помочь найти конкретный видеоклип по голосовой заметке или выполнить поиск по часам аудиозаписей на основе текстового запроса — всё это обрабатывается одной нативно мультимодальной моделью.
Созданная на основе той же технологии, что и модели Gemini Embedding, EmbeddingGemma 2:
- Лучшая в своём классе для своего размера: Показывает лидирующие результаты среди мультимодальных моделей эмбеддингов размером менее 1 млрд параметров в таких тестах, как MTEB (Massive Text Embedding Benchmark) Code и MAEB (Massive Audio Embedding Benchmark), одновременно соответствуя результатам или превосходя многие более крупные модели в задачах работы с текстом, изображениями и аудио.
- Модульная по замыслу: Для задач, связанных только с текстом, требуется всего 270 млн параметров, а для полной мультимодальной поддержки доступны дополнительные кодировщики изображений (170 млн) и аудио (300 млн).
- Эффективная с точки зрения хранения: Благодаря обучению матрёшечных представлений (MRL) разработчики могут динамически сокращать выходные векторы с 768 до 512, 256 или 128 измерений. Это обеспечивает до 6-кратного сокращения объёма хранения локальных векторных баз данных и использования памяти.
- Оптимизирована для работы на устройствах: Эффективно работает при жёстких ограничениях ресурсов. При квантовании на Google Pixel 11 Pro EmbeddingGemma 2 требует всего около 191 МБ активной оперативной памяти для текстовых весов и около 567 МБ для полной мультимодальной модели.
- Готова к работе с расширенным контекстом: Поддерживает контекстное окно на 8 тыс. токенов (в 4 раза больше, чем у EmbeddingGemma 1), что позволяет обрабатывать непосредственно на локальном оборудовании до 5,5 минут аудио, 29 изображений, 58 видеокадров или их перемежающиеся комбинации.
Высочайшее качество для кода, изображений и аудио
EmbeddingGemma 2 сохраняет высокую производительность EmbeddingGemma в работе с многоязычным текстом и при этом обеспечивает значительное улучшение результатов для кода на 9,92 пункта (в MTEB Code — с 68,76 до 78,68), что делает модель хорошо подходящей для локальной индексации кодовых баз, семантического поиска по коду и извлечения данных агентами программирования. В работе с изображениями, видео, документами и аудио она устанавливает новый стандарт качества на параметр для моделей размером менее 1 млрд параметров и даже превосходит некоторые специализированные модели, которые более чем вдвое крупнее.
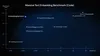
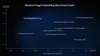
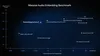
Полные показатели оценки и сведения о модели представлены в карточке модели EmbeddingGemma 2.
Семантический поиск, маршрутизация и извлечение данных полностью на устройстве
EmbeddingGemma 2 предоставляет широкие возможности непосредственно на периферийном оборудовании. Генерация эмбеддингов локально помогает обеспечивать конфиденциальность данных, сокращает задержку конвейера и позволяет разработчикам создавать кросс-модальный поиск и извлечение данных, полностью работающие в автономном режиме.
В сочетании с генеративными моделями, такими как Gemma 4, EmbeddingGemma 2 позволяет создавать RAG-конвейеры на устройствах, понимающие сложные мультимодальные данные. Поскольку EmbeddingGemma 2 создана на основе Gemma 4 и использует общий с ней токенизатор текста и аудиокодировщик, разработчики могут запускать обе модели вместе в едином конвейере с меньшим общим объёмом занимаемой памяти.
Используйте текст или изображение, чтобы найти наиболее подходящие объекты в медиатеке на основе семантического сходства. Попробуйте эту функцию в Instant Media Search приложения Google AI Edge Gallery.
Находите конкретные моменты в видео с помощью текстовых или аудиозапросов. Попробуйте эту функцию в Video Moments Finder приложения Google AI Edge Gallery.
Используйте EmbeddingGemma 2 для локального извлечения файлов вместе с Gemma 4 для контекстного рассуждения. Попробуйте это в приложении Google AI Edge Foresight.
Создавайте системы принятия решений в реальном времени, использующие мультимодальный контекст для классификации, маршрутизации и прогнозирования, с помощью MediaPipe Decision Task API.
Чтобы узнать, как создавать системы поиска и RAG на устройствах с помощью LiteRT, прочитайте публикацию в блоге Google AI Edge.
Начало работы с EmbeddingGemma 2
Мы тесно сотрудничали со следующими партнёрами, чтобы EmbeddingGemma 2 сразу работала там, где вы разрабатываете:
- Загрузите модели: Найдите веса моделей на Hugging Face и Kaggle; вскоре модели станут доступны в Model Garden платформы Gemini Enterprise Agent Platform. Посетите LiteRT Community на Hugging Face, чтобы получить модели, оптимизированные для работы на устройствах.
- Развёртывание на устройствах: Создавайте кроссплатформенные приложения с помощью Google AI Edge MediaPipe для готовых задач эмбеддингов, извлечения данных и принятия решений или LiteRT для интеграции пользовательских моделей. Создавайте приложения для браузера с помощью transformers.js или WebGPU.
- Используйте привычные инструменты разработки: Эффективно запускайте модель с помощью transformers, sentence-transformers, MLX, vLLM, llama.cpp, SGLang, Ollama и LMStudio. Храните векторы эмбеддингов с помощью Qdrant.
- Дообучение: Следуйте рекомендациям Unsloth, чтобы дообучить EmbeddingGemma 2 для своих задач.
Изучите наше руководство для разработчиков, документацию, а также руководства по выводу и дообучению.
Переведено автоматически с английского. Оригинал статьи — по ссылке ниже.