Yandex представя Sona: единен генеративен препоръчващ модел, който заменя цялата каскада за препоръки
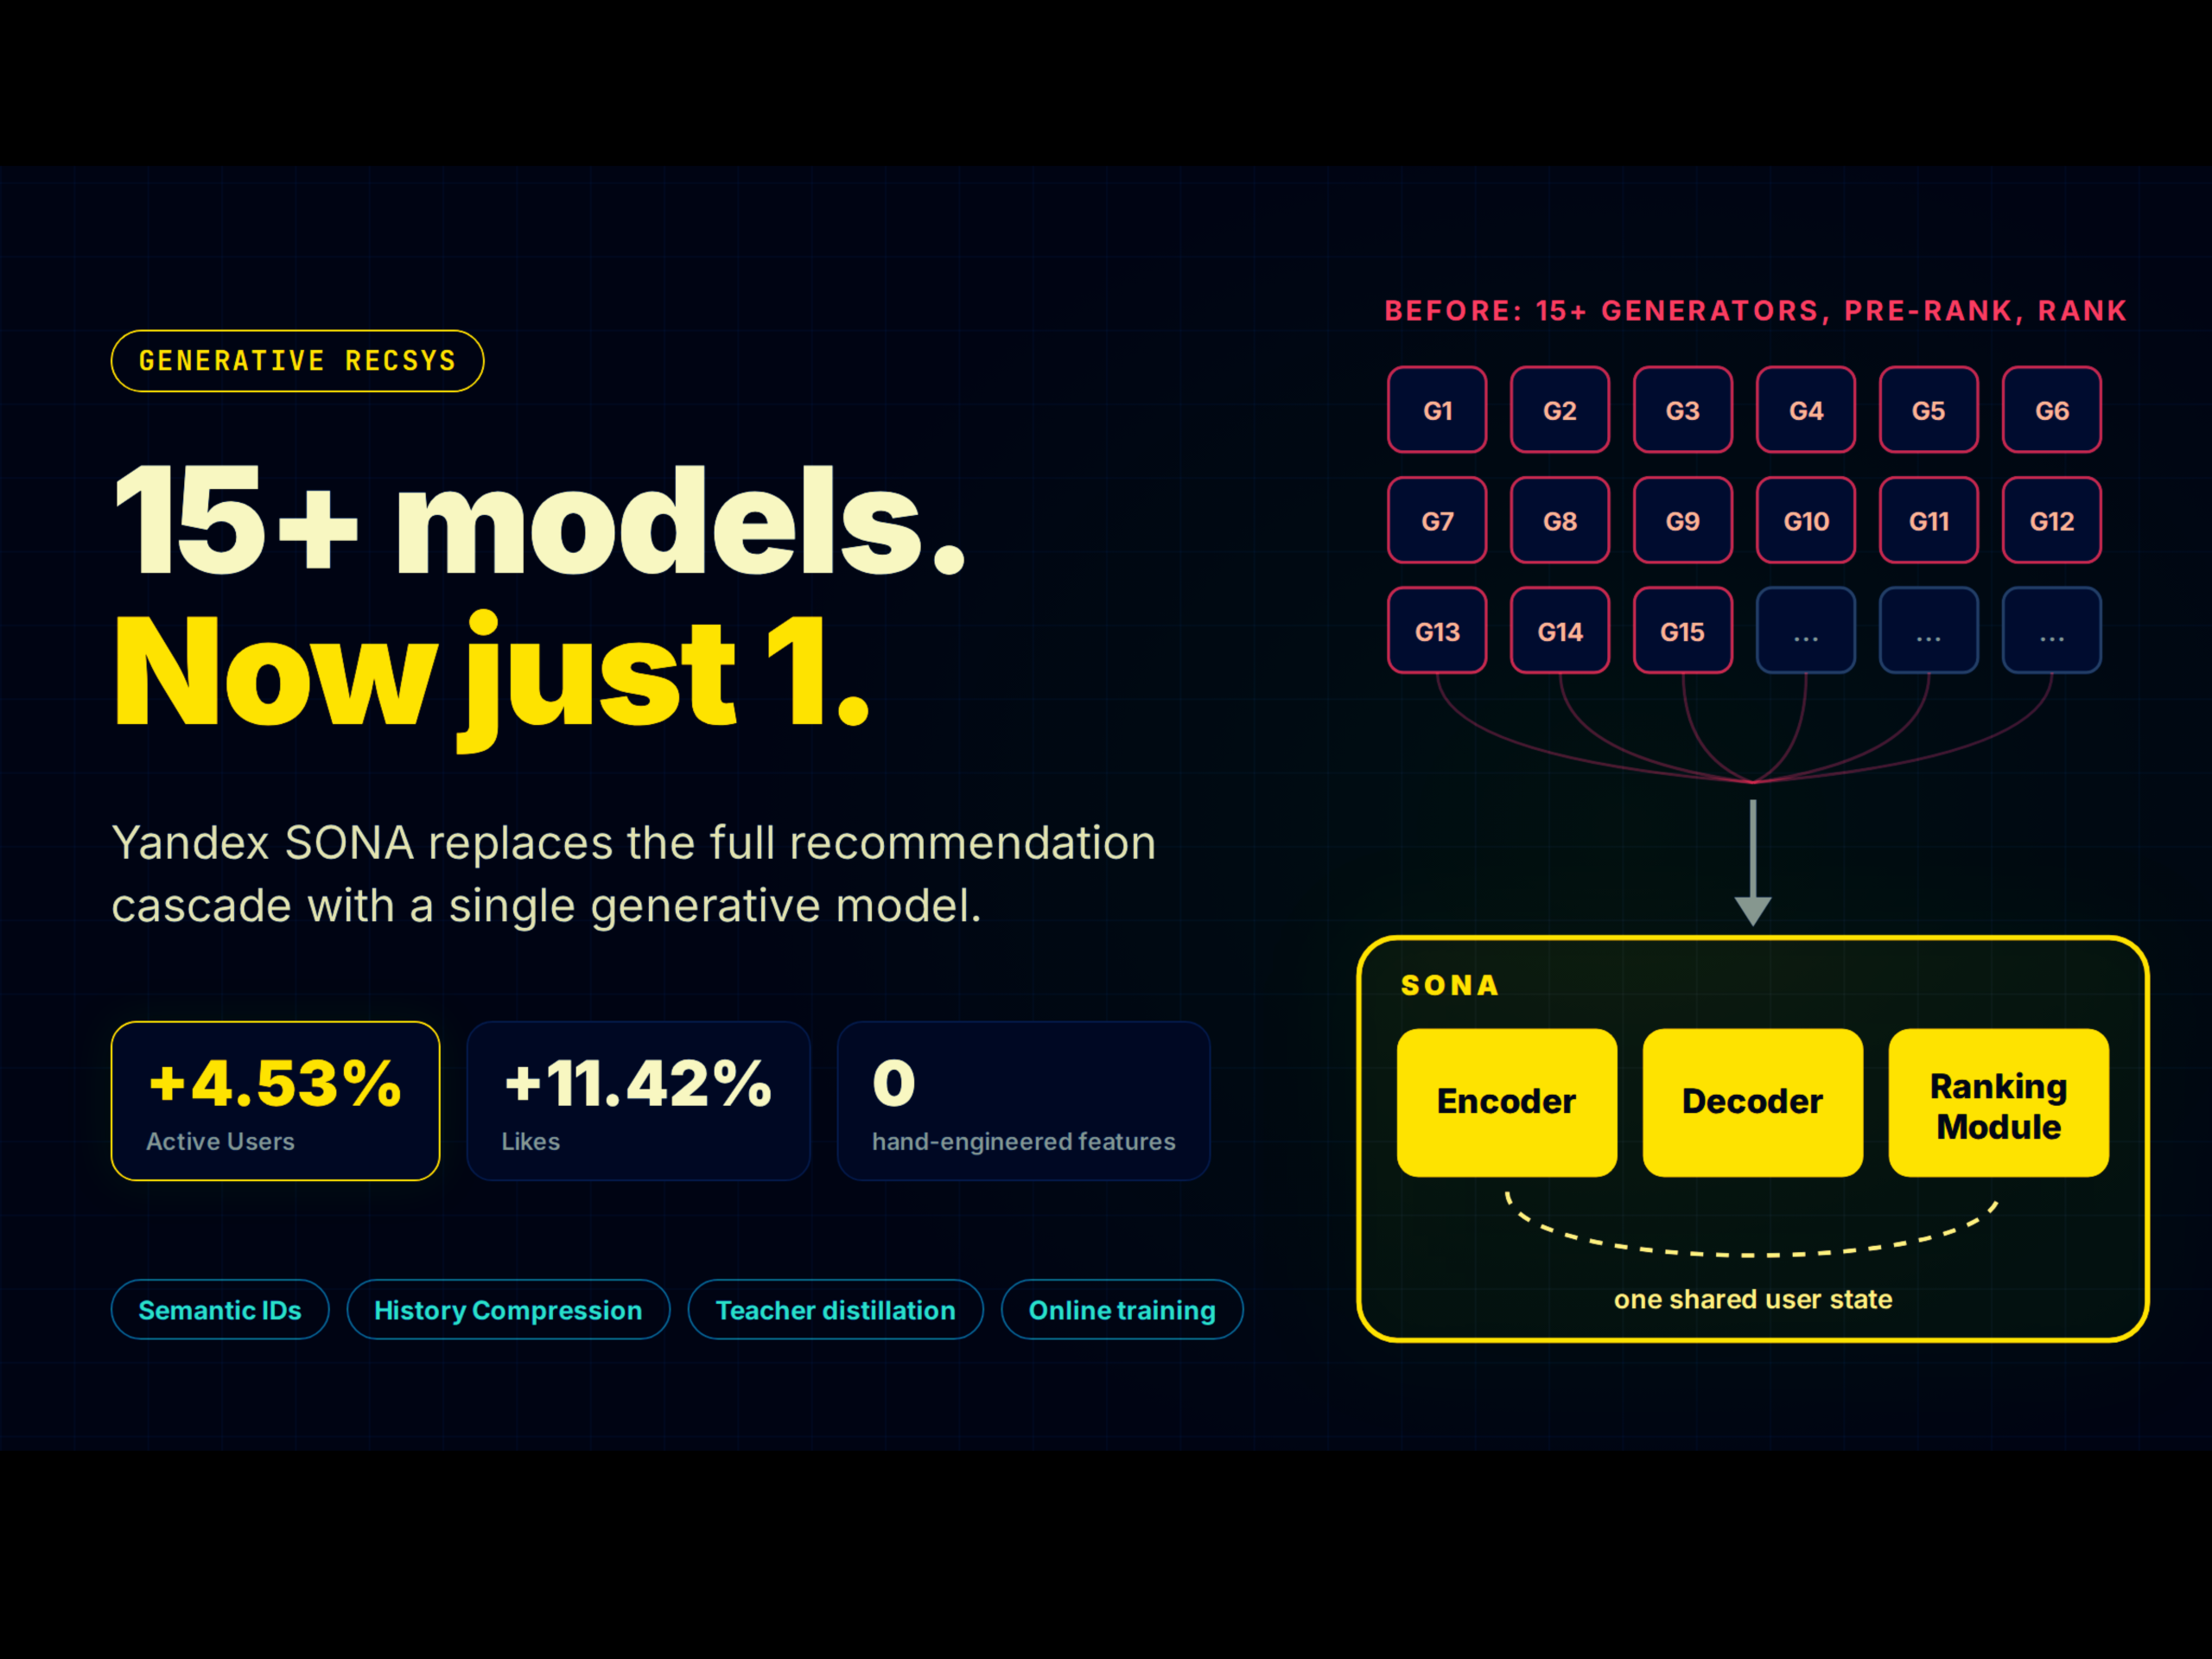
Повечето препоръчващи системи в продукция са каскадни. Генераторите на кандидати подават резултатите си към предварителен ранкер, който от своя страна подава към тежък ранкер, изграден върху стотици проектирани характеристики. Техническият доклад за Sona на Yandex описва различен дизайн. Sona е генеративен AI модел, който обединява генерирането на кандидати и класирането в една система, заменяйки множеството етапи, използвани обичайно в препоръчващите конвейери. Yandex тества модела в седемдневен експеримент в реална продукционна среда със своите умни колонки. В онлайн A/B тест той замени повече от 15 генератора на кандидати, етапа на предварително класиране и етапа на класиране с един трансформър, използван в продукция.
Какъв проблем решава Sona?
Каскадните системи разделят едно решение между модели, обучавани поотделно. Всеки етап оптимизира собствена цел, а ранкерът вижда само това, което предходните етапи са пропуснали. Предишният стек на Yandex за повърхността Yandex Music използваше стотици характеристики, включително сигнали от Argus — по-ранния трансформър за препоръки на Yandex. Sona изгражда генерирането на кандидати и класирането около едно общо представяне на потребителя. Енкодерът прочита историята на слушателя веднъж за всяка заявка. Декодерът генерира кандидати. Модулът за класиране ги оценява спрямо същите състояния на енкодера. Нито един компонент не използва ръчно проектирани характеристики. Входовете са регистрирани полета на събитията (ID на песента, ID на изпълнителя, продължителност, харесвания, време на възпроизвеждане, флагове на повърхността) и научени семантични ID.
При умните колонки на Yandex възпроизвеждането може да започне, без потребителят първо да избере изпълнител, жанр или настроение. Изследователският екип описва това като среда за чисти препоръки.
Как работи архитектурата на Sona
1. Семантичен токенизатор
Следвайки формулировката за семантични ID на Rajput и съавтори, всяка песен се превръща в кортеж от 3 дискретни кода. Замразен мултимодален LLM прочита мел-спектрограмата на първите 90 секунди заедно със заглавието, изпълнителите и таговете. Той работи само в режим prefill. След това 4-слоен трансформър за уточняване подравнява тези характеристики с поведението при слушане, като използва InfoNCE върху двойки колаборативни песни. Остатъчното K-means квантуване преобразува резултата в 3 кодови книги с по 32 000 записа всяка. Това превъзхожда базовия аудио модел CLMR: Recall@1000 нараства от 0.8111 до 0.8524.
2. Енкодер с компресиране на историята
Sona използва 8 192 минали събития. Пълното внимание върху такава дължина е скъпо, затова енкодерът разпределя неравномерно дълбочината си. Най-скорошните 2 048 събития преминават през 7-слоен стек за само-внимание. По-старите събития преминават през кръстосано внимание и само през 1 слой с пълна история. В статията се посочва, че така се запазва по-голямата част от качеството на пълното внимание при приблизително наполовина по-ниска цена на инференцията.
3. Декодер и модул за класиране
2-слоен декодер извежда кортежи от семантични ID чрез ограничено търсене по лъча с ширина 1 024. Trie структура на каталога блокира невалидните префикси. Всеки кортеж се разширява до всички песни, които го споделят. След това модулът за класиране, състоящ се от четири слоя за кръстосано внимание, оценява тези песни спрямо общата памет на енкодера.
Обучение: учител, който никога не стига до продукция
Модулът за класиране се обучава от замразен учител-ранкер. Учителят е трансформър с 0,6 млрд. параметъра, също без ръчно проектирани характеристики. Той се обучава върху една година събития, свързани с ангажираността, на 2 етапа: предварително обучение за предсказване на следващия елемент, последвано от дообучаване за класиране с множество глави. Премахването на предварителното обучение понижава претеглената точност на двойките от 0.6215 до 0.6153.
Екипът нарича метода си за дистилация Rollout Distillation. По време на обучението текущият декодер генерира кандидати чрез търсене по лъча. Учителят ги оценява заедно с регистрираните импресии. Модулът за класиране регресира към тези оценки със средна абсолютна грешка. Съвместната загуба е L = L_NTP + L_rollout + L_impression. И двете загуби актуализират общия енкодер. При обслужване на заявките учителят се премахва.
Обучението остава онлайн. Събитията се обединяват в сесии в рамките на 15-минутен прозорец, подават се към GPU обучител, а новите тегла достигат до системата за обслужване на всеки 10 минути. Крайната латентност е 45 минути при медианата и 60 минути при p99. Обслужването работи върху NVIDIA Triton Inference Server с CUDA графи и достига 41% използване на FLOPs на модела.
Резултати: онлайн A/B тест върху реален трафик
Финалният експеримент продължи 7 дни с 15% от случайно избраните потребители във всеки вариант. Всяка от промените по-долу е статистически значима и е спрямо продукционната контролна група:
- Активни потребители (основен показател): +4.53%
- Общо време на слушане: +6.30%
- Харесвания: +11.42%
- Команди „Повтори“: +17.99%
- Потребители с дълбока ангажираност: +7.37%
Тези подобрения се натрупват върху ефектите, запазени от по-ранни внедрявания. При активните потребители увеличението на Sona е 2.35 пъти по-голямо от приноса от +1.93%, който Argus е постигнал по-рано на тази повърхност.
Sona срещу OneRec и HSTU: сравнение на характеристиките
Sona не е първият генеративен препоръчващ модел от край до край в продукция. OneRec на Kuaishou вече обслужва единен модел енкодер-декодер. Генеративните препоръчващи модели HSTU на Meta преосмислят препоръките през 2024 г. като последователна трансдукция върху действията на потребителя. Това, което Sona обединява, е пълна замяна на каскадата, липса на ръчно проектирани характеристики и дистилиран ранкер, валидиран онлайн.
| Характеристика | Sona (Yandex) | OneRec (Kuaishou) | HSTU GR (Meta) |
| Област | Стрийминг на музика | Кратки видеоклипове | Голяма интернет платформа, множество повърхности |
| Един обслужван модел заменя каскадата | Да, в A/B тест | Да, около 25% от общия QPS | Не, представено като нова архитектура за препоръчващи модели |
| Входове от потребителя | Само регистрирани полета на събитията, без ръчно проектирани характеристики | Пътища за „многостепенно проектиране на характеристики“, включително uid, възраст и пол | Последователности от действията на потребителя (последователна трансдукция) |
| Изход за елемента | 3-степенни семантични ID, 3 x 32 000 | 3-степенни семантични ID чрез RQ-Kmeans | ID на елементи |
| Сигнал за класиране | Генериран от замразен учител-ранкер с 0,6 млрд. параметъра | Подсилващо обучение с модел за награда P-Score (ECPO) | Модел за класиране HSTU |
| Подсилващо обучение | Не, изцяло контролирано | Да (ECPO) | Не е посочено |
| Посочен мащаб | История от 8 192 събития, учител с 0,6 млрд. параметъра | 10 пъти повече FLOPs от предишния модел за класиране | 1,5 трилиона параметъра |
| Отчетено онлайн подобрение | +4.53% активни потребители, +6.30% време на слушане, +11.42% харесвания | +0.54% и +1.24% време в приложението | +12.4% в онлайн A/B тестове |
| Публичен код или тегла | Не | Не са включени в доклада | Да, GitHub |
Източници: Sona, OneRec, HSTU. Онлайн подобренията произлизат от различни платформи и показатели, затова не са пряко сравними.
Основни изводи
- Sona замени над 15 генератора, предварителното класиране и класирането с 1 обслужван модел.
- Без ръчно проектирани характеристики: само регистрирани събития и научени семантични ID.
- Учител с 0,6 млрд. параметъра обучава ранкера, след което не участва в обслужването.
- A/B тест: +4.53% активни потребители, 2.35 пъти повече от предишното подобрение на Argus.
- Не може да бъде внедрен външно: няма код или тегла и не работи върху целия трафик.
Често задавани въпроси
Какво представлява Sona на Yandex?
Sona е генеративен AI модел, който обединява генерирането на кандидати и класирането в една система. Yandex го тества в седемдневен експеримент в реална продукционна среда със своите умни колонки, където той замени съществуващия многоетапен конвейер за препоръки в тестовата група.
По какво Sona се различава от OneRec?
OneRec използва проектирани пътища за характеристиките на потребителя и подсилващо обучение с модел за награда. Sona използва само регистрирани полета на събитията и дистилира класирането от замразен учител.
Вижте статията за пълни подробности.
Преведено автоматично от английски. Оригиналната статия е на връзката по-долу.