Yandex представляє Sona: єдина генеративна рекомендаційна модель, що замінює всю каскаду рекомендацій
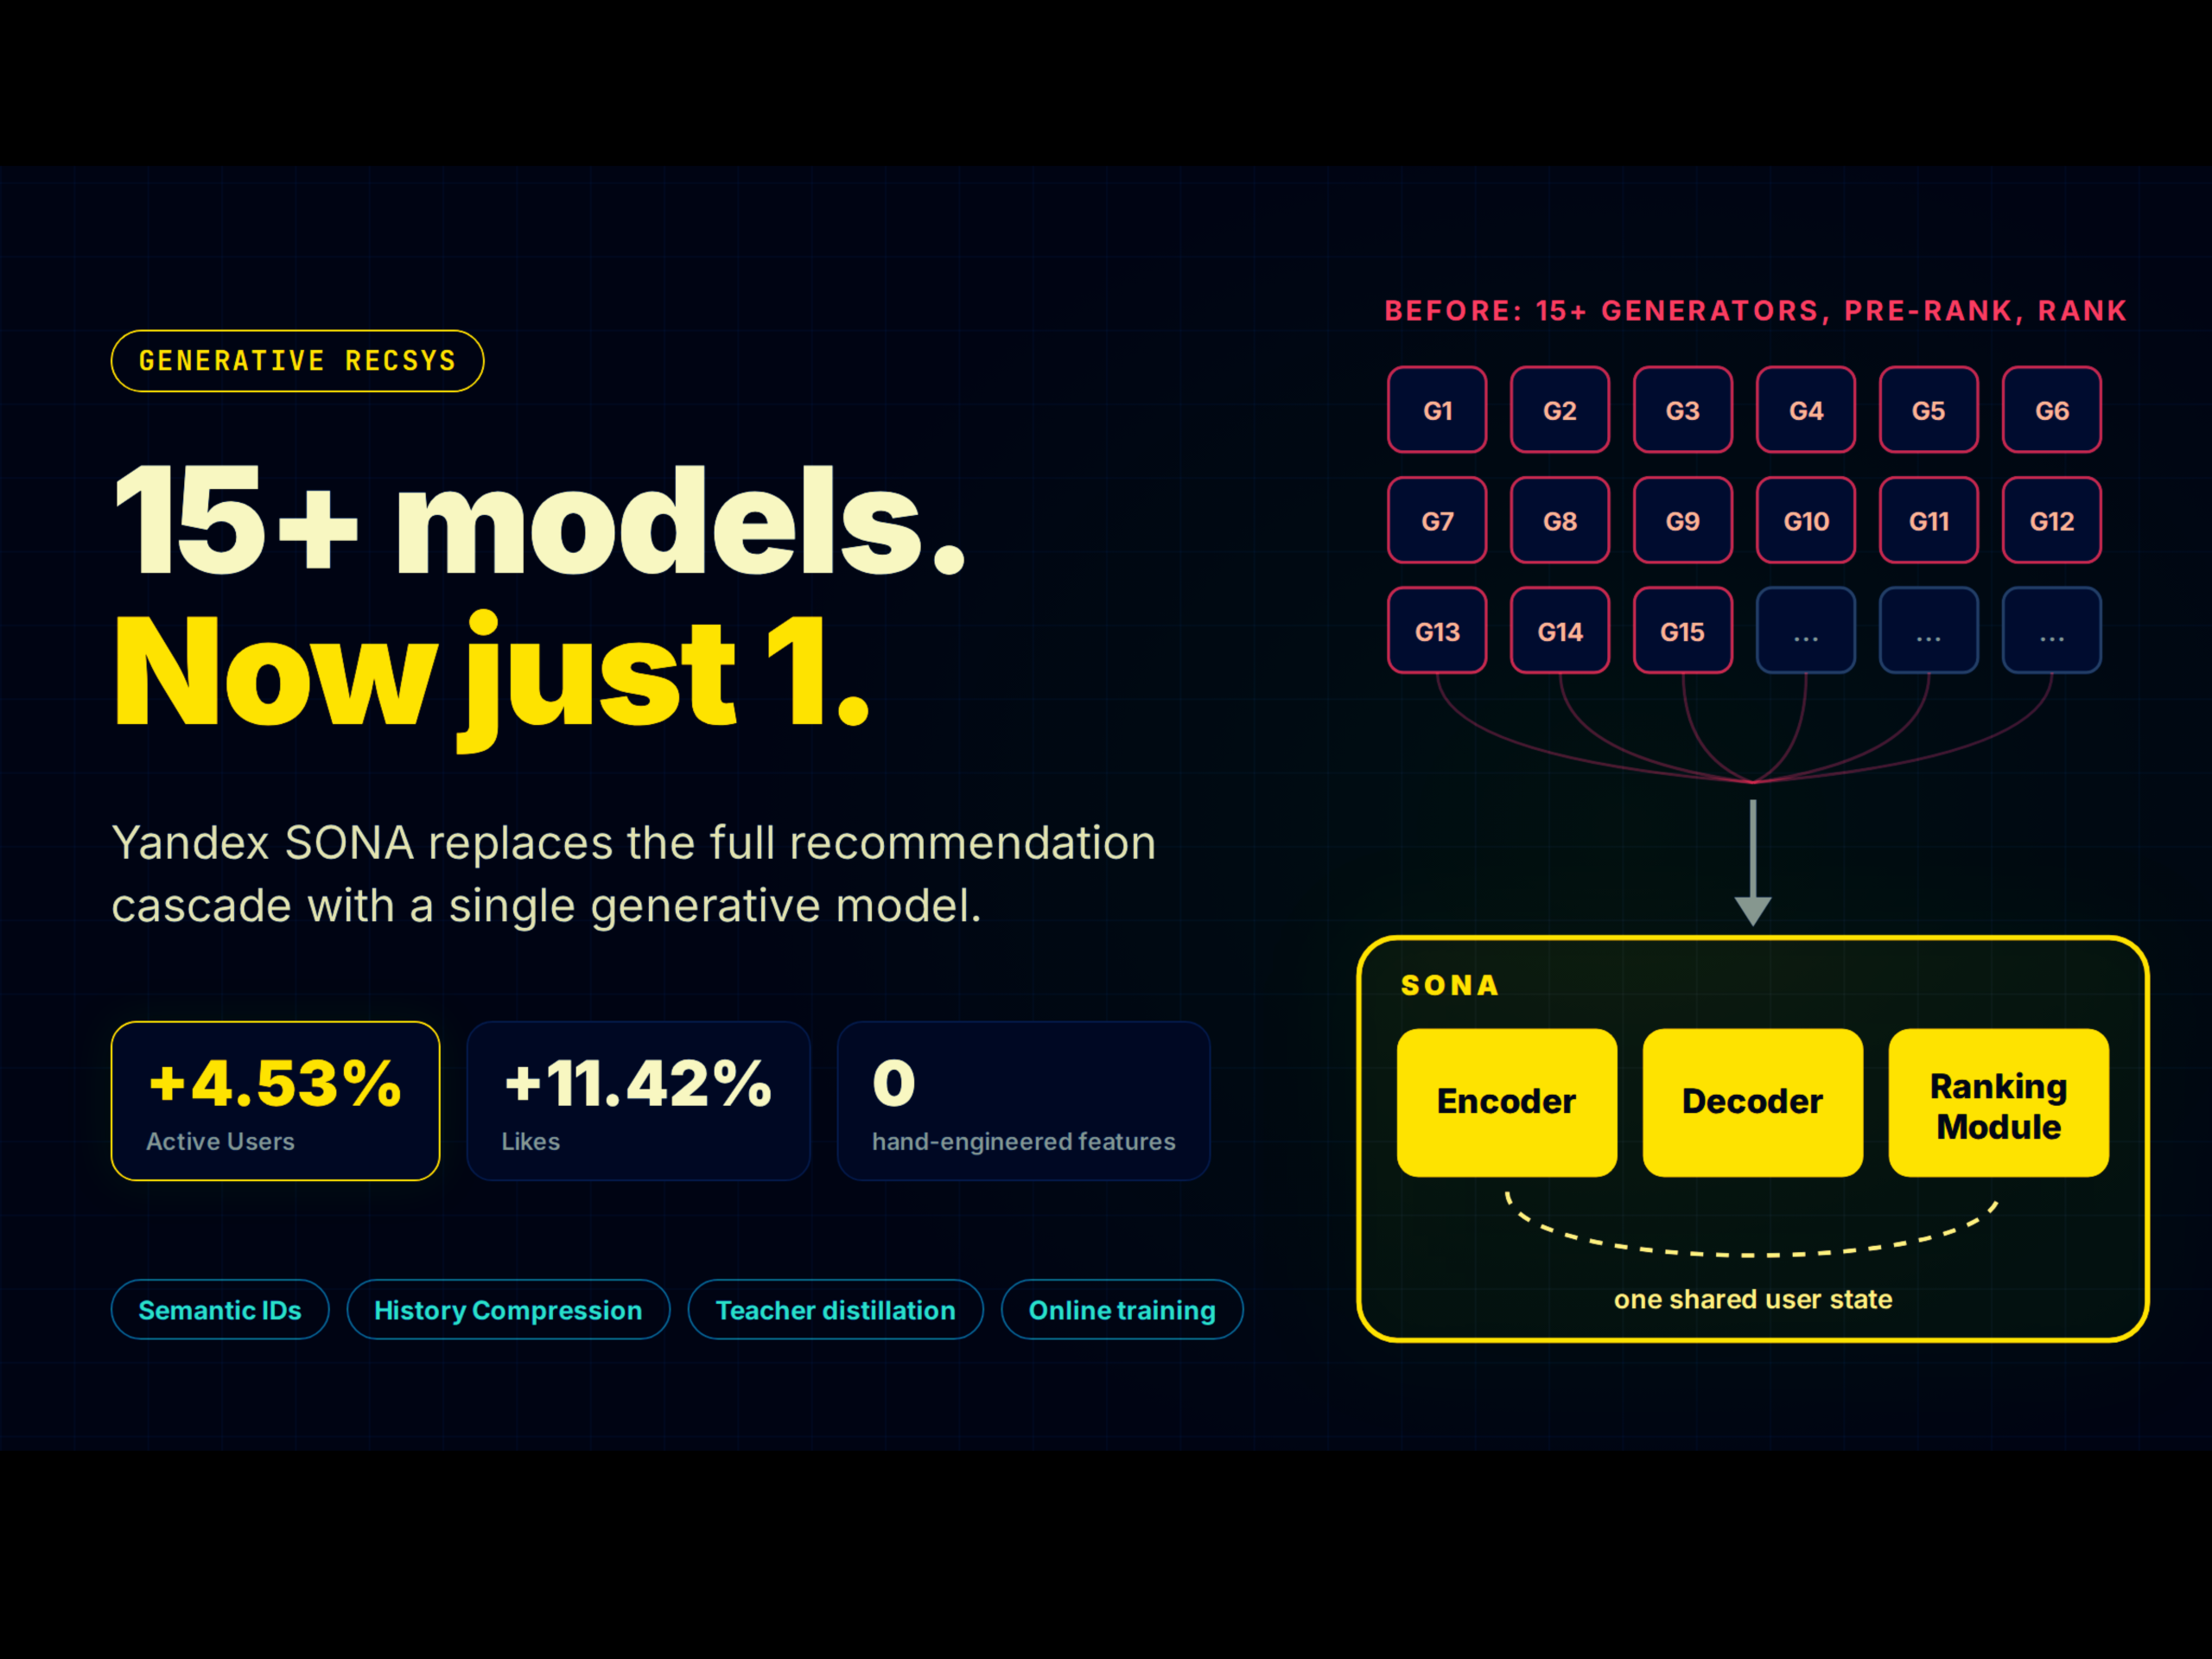
Більшість рекомендаційних систем у продакшені є каскадними. Генератори кандидатів передають результати моделі попереднього ранжування, яка, своєю чергою, передає їх потужній моделі ранжування, побудованій на сотнях інженерно розроблених ознак. Технічний звіт Yandex про Sona описує інший підхід. Sona — це генеративна модель штучного інтелекту, яка об’єднує генерацію кандидатів і ранжування в єдину систему, замінюючи кілька етапів, що зазвичай використовуються в рекомендаційних конвеєрах. Yandex протестував модель у семиденному експерименті в реальному продакшені на своїх розумних колонках. В онлайн A/B-тесті вона замінила понад 15 генераторів кандидатів, етап попереднього ранжування та етап ранжування однією трансформерною моделлю, що обслуговує запити.
Яку проблему вирішує Sona?
Каскадні системи розподіляють одне рішення між окремо навченими моделями. Кожен етап оптимізує власну ціль, а модель ранжування бачить лише те, що пропустили попередні етапи. Попередній стек Yandex на музичній поверхні Yandex використовував сотні ознак, зокрема сигнали від Argus — попереднього рекомендаційного трансформера Yandex. Sona об’єднує генерацію кандидатів і ранжування навколо єдиного спільного представлення користувача. Енкодер зчитує історію слухача один раз на кожен запит. Декодер генерує кандидатів. Модуль ранжування оцінює їх щодо тих самих станів енкодера. Жоден компонент не використовує інженерно розроблених ознак. Вхідними даними є поля журналу подій (ID треку, ID виконавця, тривалість, вподобання, час відтворення, прапорці поверхні) і вивчені семантичні ID.
На розумних колонках Yandex відтворення може розпочатися без того, щоб користувач спочатку вибрав виконавця, жанр або настрій. Дослідницька команда описує це як сценарій суто рекомендаційного використання.
Як працює архітектура Sona
1. Семантичний токенізатор
Відповідно до формулювання семантичних ID, запропонованого Rajput та ін., кожен трек перетворюється на кортеж із 3 дискретних кодів. Заморожена мультимодальна LLM зчитує мел-спектрограму перших 90 секунд разом із назвою, виконавцями та тегами. Вона працює лише в режимі попереднього заповнення. Потім 4-шаровий трансформер уточнення узгоджує ці ознаки з поведінкою слухачів, використовуючи InfoNCE на колаборативних парах треків. Залишкове квантування K-means перетворює результат на 3 кодбуки, кожен із 32 000 елементів. Це перевершило аудіобазову модель CLMR: Recall@1000 зріс із 0.8111 до 0.8524.
2. Енкодер зі стисненням історії
Sona працює з 8 192 минулими подіями. Повна увага на такій довжині є ресурсоємною, тому енкодер нерівномірно розподіляє обчислювальну глибину. Для 2 048 найновіших подій використовується 7-шаровий стек self-attention. Старіші події проходять через cross-attention і лише 1 шар для всієї історії. У статті зазначено, що це зберігає більшу частину якості повної уваги приблизно за половини вартості інференсу.
3. Декодер і модуль ранжування
Декодер із 2 шарів генерує кортежі семантичних ID за допомогою пошуку в пучку з обмеженнями та шириною 1 024. Каталожне trie-дерево блокує недійсні префікси. Кожен кортеж розгортається в усі треки, які його поділяють. Потім модуль ранжування, що складається з чотирьох cross-attention-шарів, оцінює ці треки щодо спільної пам’яті енкодера.
Навчання: учитель, який ніколи не потрапляє в продакшен
Модуль ранжування навчається на основі замороженої моделі-учителя ранжування. Учитель — це трансформер із 0,6 млрд параметрів, який також не використовує інженерно розроблених ознак. Його навчають на подіях взаємодії за рік у 2 етапи: попереднє навчання для прогнозування наступного елемента, а потім донавчання для багатоголового ранжування. Відмова від попереднього навчання знизила зважену точність пар із 0.6215 до 0.6153.
Команда називає свій метод дистиляції Rollout Distillation. Під час навчання поточний декодер генерує кандидатів у пучку. Учитель оцінює їх разом із зафіксованими показами. Модуль ранжування регресує до цих оцінок за допомогою середньої абсолютної помилки. Спільна функція втрат має вигляд L = L_NTP + L_rollout + L_impression. Обидві втрати оновлюють спільний енкодер. Під час обслуговування запитів учитель видаляється.
Навчання відбувається онлайн. Події агрегуються в сесії протягом 15-хвилинного вікна, передаються тренеру на GPU, а нові ваги надходять у систему обслуговування кожні 10 хвилин. Наскрізна затримка становить 45 хвилин за медіанним значенням і 60 хвилин на p99. Обслуговування працює на NVIDIA Triton Inference Server із графами CUDA та досягає 41% використання FLOPs моделі.
Результати: онлайн A/B-тест на реальному трафіку
Фінальний експеримент тривав 7 днів і охоплював 15% випадково вибраних користувачів у кожній групі. Усі наведені нижче зміни є статистично значущими порівняно з продакшен-контролем:
- Активні користувачі (основна метрика): +4.53%
- Загальний час прослуховування: +6.30%
- Вподобання: +11.42%
- Команди «Повторити»: +17.99%
- Користувачі з високою залученістю: +7.37%
Ці результати додаються до покращень, збережених після попередніх розгортань. Для активних користувачів приріст Sona у 2.35 раза перевищує приріст +1.93%, який раніше забезпечив Argus на цій поверхні.
Sona проти OneRec і HSTU: порівняння характеристик
Sona не є першою наскрізною генеративною рекомендаційною системою в продакшені. OneRec від Kuaishou уже обслуговує запити за допомогою єдиної моделі енкодер-декодер. HSTU Generative Recommenders від Meta у 2024 році переосмислила рекомендації як послідовне перетворення дій користувача. Sona поєднує повну заміну каскаду, відсутність інженерно розроблених ознак і дистильовану модель ранжування, перевірену онлайн.
| Характеристика | Sona (Yandex) | OneRec (Kuaishou) | HSTU GR (Meta) |
| Домен | Потокове передавання музики | Короткі відео | Велика інтернет-платформа, кілька поверхонь |
| Одна модель, що обслуговує запити, замінює каскад | Так, в A/B-тесті | Так, приблизно 25% загального QPS | Ні, описана як нова архітектура для рекомендаційних моделей |
| Вхідні дані користувача | Лише поля журналу подій, без інженерно розроблених ознак | Шляхи «багатомасштабної інженерії ознак», зокрема uid, вік, стать | Послідовності дій користувача (послідовне перетворення) |
| Вихідні дані про елемент | Семантичні ID 3 рівнів, 3 x 32 000 | Семантичні ID 3 рівнів через RQ-Kmeans | ID елементів |
| Сигнал ранжування | Отримується від замороженої моделі-учителя з 0,6 млрд параметрів | Підкріплювальне навчання з моделлю винагороди P-Score (ECPO) | Модель ранжування HSTU |
| Підкріплювальне навчання | Ні, повністю контрольоване навчання | Так (ECPO) | Не повідомлялося |
| Заявлений масштаб | Історія з 8 192 подій, учитель із 0,6 млрд параметрів | У 10 разів більше FLOPs, ніж у попередньої моделі ранжування | 1,5 трлн параметрів |
| Заявлений онлайн-приріст | +4.53% активних користувачів, +6.30% часу прослуховування, +11.42% вподобань | +0.54% і +1.24% часу перебування в застосунку | +12.4% в онлайн A/B-тестах |
| Публічний код або ваги | Ні | У звіті не зазначено | Так, GitHub |
Джерела: Sona, OneRec, HSTU. Онлайн-результати отримано на різних платформах і за різними метриками, тому їх не можна безпосередньо порівнювати.
Основні висновки
- Sona замінила понад 15 генераторів, попереднє ранжування та ранжування однією моделлю, що обслуговує запити.
- Жодних інженерно розроблених ознак: лише зареєстровані події та вивчені семантичні ID.
- Учитель із 0,6 млрд параметрів навчає модель ранжування, а потім не використовується під час обслуговування.
- A/B-тест: +4.53% активних користувачів, у 2.35 раза більше, ніж попередній приріст Argus.
- Зовнішнє розгортання неможливе: немає коду чи ваг, модель не працювала на всьому трафіку.
Поширені запитання
Що таке Yandex Sona?
Sona — це генеративна модель штучного інтелекту, яка поєднує генерацію кандидатів і ранжування в єдиній системі. Yandex протестував її в семиденному експерименті в реальному продакшені на своїх розумних колонках, де вона замінила наявний багатоступеневий рекомендаційний конвеєр для тестової групи.
Чим Sona відрізняється від OneRec?
OneRec використовує інженерно розроблені шляхи ознак користувача та підкріплювальне навчання з моделлю винагороди. Sona використовує лише поля журналу подій і дистилює ранжування із замороженої моделі-учителя.
Докладніше дивіться в статті.
Перекладено автоматично з англійської. Оригінал статті — за посиланням нижче.