Yandex представляет Sona: единая генеративная модель рекомендаций, заменяющая всю каскаду рекомендаций
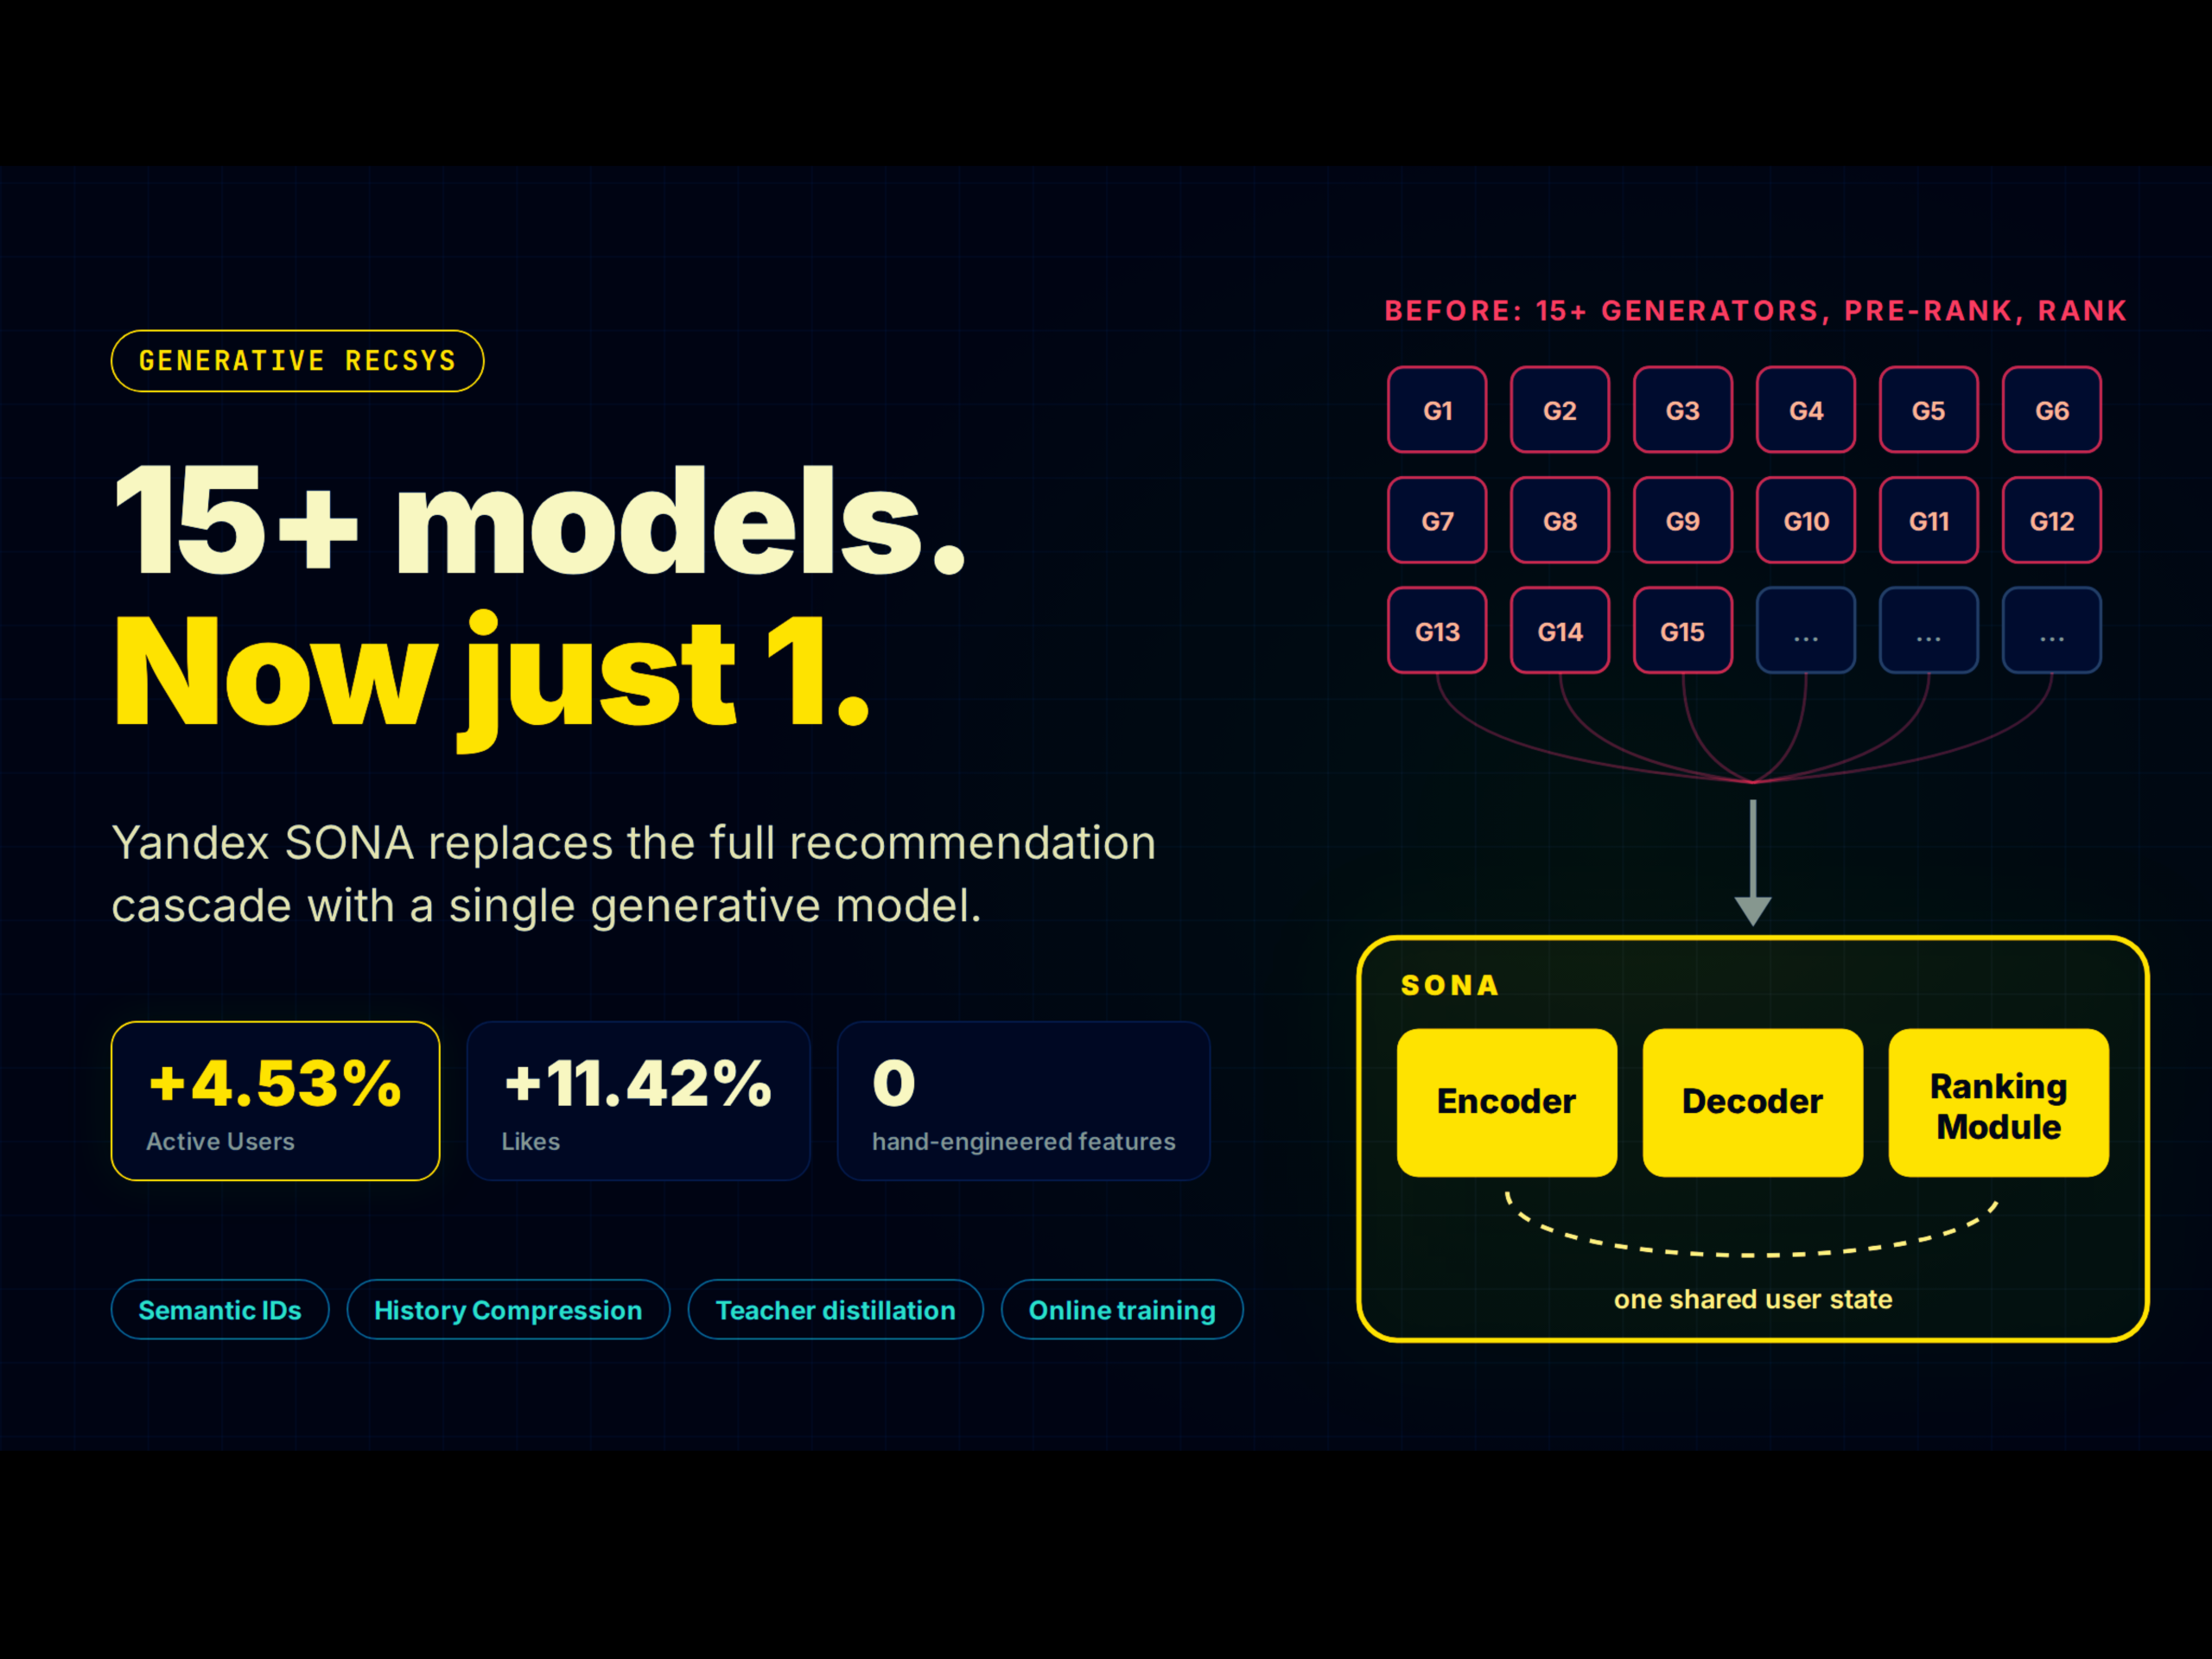
Большинство рекомендательных систем, работающих в продакшене, представляют собой каскады. Генераторы кандидатов передают результаты на этап предварительного ранжирования, который, в свою очередь, передаёт их тяжёлому ранжировщику, построенному на сотнях инженерных признаков. В техническом отчёте Yandex о Sona описывается другая архитектура. Sona — это генеративная ИИ-модель, которая объединяет генерацию кандидатов и ранжирование в единую систему, заменяя несколько этапов, обычно используемых в рекомендательных конвейерах. Yandex протестировал модель в ходе семидневного эксперимента в реальном продакшене на своих умных колонках. В онлайн A/B-тесте одна обслуживаемая трансформерная модель заменила более 15 генераторов кандидатов, этап предварительного ранжирования и этап ранжирования.
Какую проблему решает Sona?
Каскадные системы распределяют одно решение между отдельно обученными моделями. Каждый этап оптимизирует собственную целевую функцию, а ранжировщик видит только те объекты, которые пропустили предыдущие этапы. Предыдущий стек Yandex на поверхности Yandex Music использовал сотни признаков, включая сигналы от Argus — более раннего рекомендательного трансформера Yandex. Sona объединяет генерацию кандидатов и ранжирование вокруг единого представления пользователя. Энкодер считывает историю слушателя один раз за запрос. Декодер генерирует кандидатов. Модуль ранжирования оценивает их на основе тех же состояний энкодера. Ни один компонент не использует разработанные вручную признаки. Входные данные — это поля зарегистрированных событий (идентификатор трека, идентификатор исполнителя, длительность, отметки «Нравится», время воспроизведения, флаги поверхности) и выученные семантические идентификаторы.
На умных колонках Yandex воспроизведение может начаться без предварительного выбора пользователем исполнителя, жанра или настроения. Исследовательская команда описывает это как сценарий чистой рекомендации.
Как устроена архитектура Sona
1. Семантический токенизатор
Следуя формулировке семантических идентификаторов Rajput и соавторов, каждый трек преобразуется в кортеж из 3 дискретных кодов. Замороженная мультимодальная LLM считывает мел-спектрограмму первых 90 секунд вместе с названием, исполнителями и тегами. Она работает только в режиме предварительного заполнения. Затем 4-слойный трансформер уточнения сопоставляет эти признаки с поведением слушателей, используя InfoNCE на коллаборативных парах треков. Остаточная кластеризация K-средних квантует результат в 3 кодовые книги по 32 000 элементов в каждой. Этот подход превзошёл аудиобазовый метод CLMR: Recall@1000 вырос с 0.8111 до 0.8524.
2. Энкодер со сжатием истории
Sona обращается к 8 192 прошлым событиям. Полное внимание на такой длине обходится дорого, поэтому энкодер неравномерно распределяет глубину. Для последних 2 048 событий используется 7-слойный стек самовнимания. Более старые события проходят через перекрёстное внимание и только 1 слой, охватывающий всю историю. Согласно статье, это позволяет сохранить большую часть качества полного внимания примерно при вдвое меньшей стоимости инференса.
3. Декодер и модуль ранжирования
2-слойный декодер выдаёт кортежи семантических идентификаторов с помощью поиска по ограниченному лучу шириной 1 024. Каталожное префиксное дерево блокирует недопустимые префиксы. Каждый кортеж разворачивается во все треки, которые ему соответствуют. Затем модуль ранжирования, состоящий из четырёх слоёв перекрёстного внимания, оценивает эти треки относительно общей памяти энкодера.
Обучение: учитель, который никогда не попадает в продакшен
Модуль ранжирования обучается на замороженном ранжировщике-учителе. Учитель — это трансформер с 0,6 млрд параметров, также не использующий разработанные вручную признаки. Он обучается на событиях взаимодействия за год в 2 этапа: предварительное обучение на предсказании следующего объекта, затем дообучение для многоголового ранжирования. Удаление предварительного обучения снизило взвешенную точность по парам с 0.6215 до 0.6153.
Команда называет свой метод дистилляции дистилляцией развёртки. Во время обучения текущий декодер генерирует кандидатов лучевого поиска. Учитель оценивает их вместе с зарегистрированными показами. Модуль ранжирования регрессирует к этим оценкам, минимизируя среднюю абсолютную ошибку. Совместная функция потерь имеет вид L = L_NTP + L_rollout + L_impression. Обе функции потерь обновляют общий энкодер. Во время обслуживания учитель удаляется.
Обучение продолжается онлайн. События объединяются в сессии в течение 15-минутного окна, передаются GPU-тренировщику, а новые веса поступают в систему обслуживания каждые 10 минут. Сквозная задержка составляет 45 минут по медиане и 60 минут на уровне p99. Обслуживание выполняется с помощью NVIDIA Triton Inference Server с графами CUDA; утилизация FLOPs модели достигает 41%.
Результаты: онлайн A/B-тест на реальном трафике
Финальный эксперимент длился 7 дней и проводился на 15% случайно выбранных пользователей в каждом варианте. Все приведённые ниже изменения статистически значимы и указаны относительно контрольной группы в продакшене:
- Активные пользователи (основная метрика): +4.53%
- Общее время прослушивания: +6.30%
- Отметки «Нравится»: +11.42%
- Команды «Повторить»: +17.99%
- Пользователи с высокой вовлечённостью: +7.37%
Эти результаты дополняют улучшения, сохранившиеся после предыдущих внедрений. По метрике активных пользователей прирост Sona в 2,35 раза превышает прирост +1,93%, ранее обеспеченный Argus на этой поверхности.
Sona против OneRec и HSTU: сравнение характеристик
Sona — не первая сквозная генеративная рекомендательная система в продакшене. OneRec компании Kuaishou уже использует единую модель энкодер–декодер. Генеративные рекомендательные системы HSTU компании Meta в 2024 году переосмыслили рекомендации как последовательное преобразование действий пользователя. Sona объединяет полную замену каскада, отсутствие разработанных вручную признаков и ранжировщик, обученный методом дистилляции, — и всё это подтверждено онлайн.
| Характеристика | Sona (Yandex) | OneRec (Kuaishou) | HSTU GR (Meta) |
| Домен | Стриминг музыки | Короткие видео | Крупная интернет-платформа, несколько поверхностей |
| Одна обслуживаемая модель заменяет каскад | Да, в A/B-тесте | Да, около 25% общего QPS | Нет, представлена как новая архитектура рекомендательных моделей |
| Входные данные пользователя | Только поля зарегистрированных событий, без разработанных вручную признаков | Пути «многоуровневого конструирования признаков», включая uid, возраст, пол | Последовательности действий пользователя (последовательное преобразование) |
| Выходные данные об объектах | Семантические идентификаторы 3 уровней, 3 x 32 000 | Семантические идентификаторы 3 уровней через RQ-Kmeans | Идентификаторы объектов |
| Сигнал ранжирования | Формируется замороженным учителем-ранжировщиком с 0,6 млрд параметров | Обучение с подкреплением с моделью награды P-Score (ECPO) | Модель ранжирования HSTU |
| Обучение с подкреплением | Нет, полностью контролируемое обучение | Да (ECPO) | Не сообщается |
| Заявленный масштаб | История из 8 192 событий, учитель с 0,6 млрд параметров | В 10 раз больше FLOPs, чем у предыдущей модели ранжирования | 1,5 трлн параметров |
| Заявленный онлайн-прирост | +4.53% активных пользователей, +6.30% времени прослушивания, +11.42% отметок «Нравится» | +0.54% и +1.24% времени в приложении | +12.4% в онлайн A/B-тестах |
| Открытый код или веса | Нет | В отчёте не указаны | Да, GitHub |
Источники: Sona, OneRec, HSTU. Онлайн-результаты получены на разных платформах и по разным метрикам, поэтому напрямую сравнивать их нельзя.
Основные выводы
- Sona заменила более 15 генераторов, этапы предварительного ранжирования и ранжирования одной обслуживаемой моделью.
- Разработанные вручную признаки не используются: только зарегистрированные события и выученные семантические идентификаторы.
- Ранжировщик обучается с помощью учителя с 0,6 млрд параметров, который затем не участвует в обслуживании.
- A/B-тест: +4.53% активных пользователей, что в 2,35 раза превышает предыдущий прирост Argus.
- Внешнее развёртывание невозможно: код и веса не опубликованы, модель не работает на всём трафике.
FAQ
Что такое Yandex Sona?
Sona — это генеративная ИИ-модель, которая объединяет генерацию кандидатов и ранжирование в единой системе. Yandex протестировал её в ходе семидневного эксперимента в реальном продакшене на своих умных колонках, где она заменила существующий многоэтапный рекомендательный конвейер для тестовой группы.
Чем Sona отличается от OneRec?
OneRec использует пути с инженерными признаками пользователя и обучение с подкреплением с моделью награды. Sona использует только поля зарегистрированных событий и выполняет дистилляцию ранжирования из замороженной модели-учителя.
Подробнее см. в статье.
Переведено автоматически с английского. Оригинал статьи — по ссылке ниже.