Задържането на данни за AI зависи от крайната точка
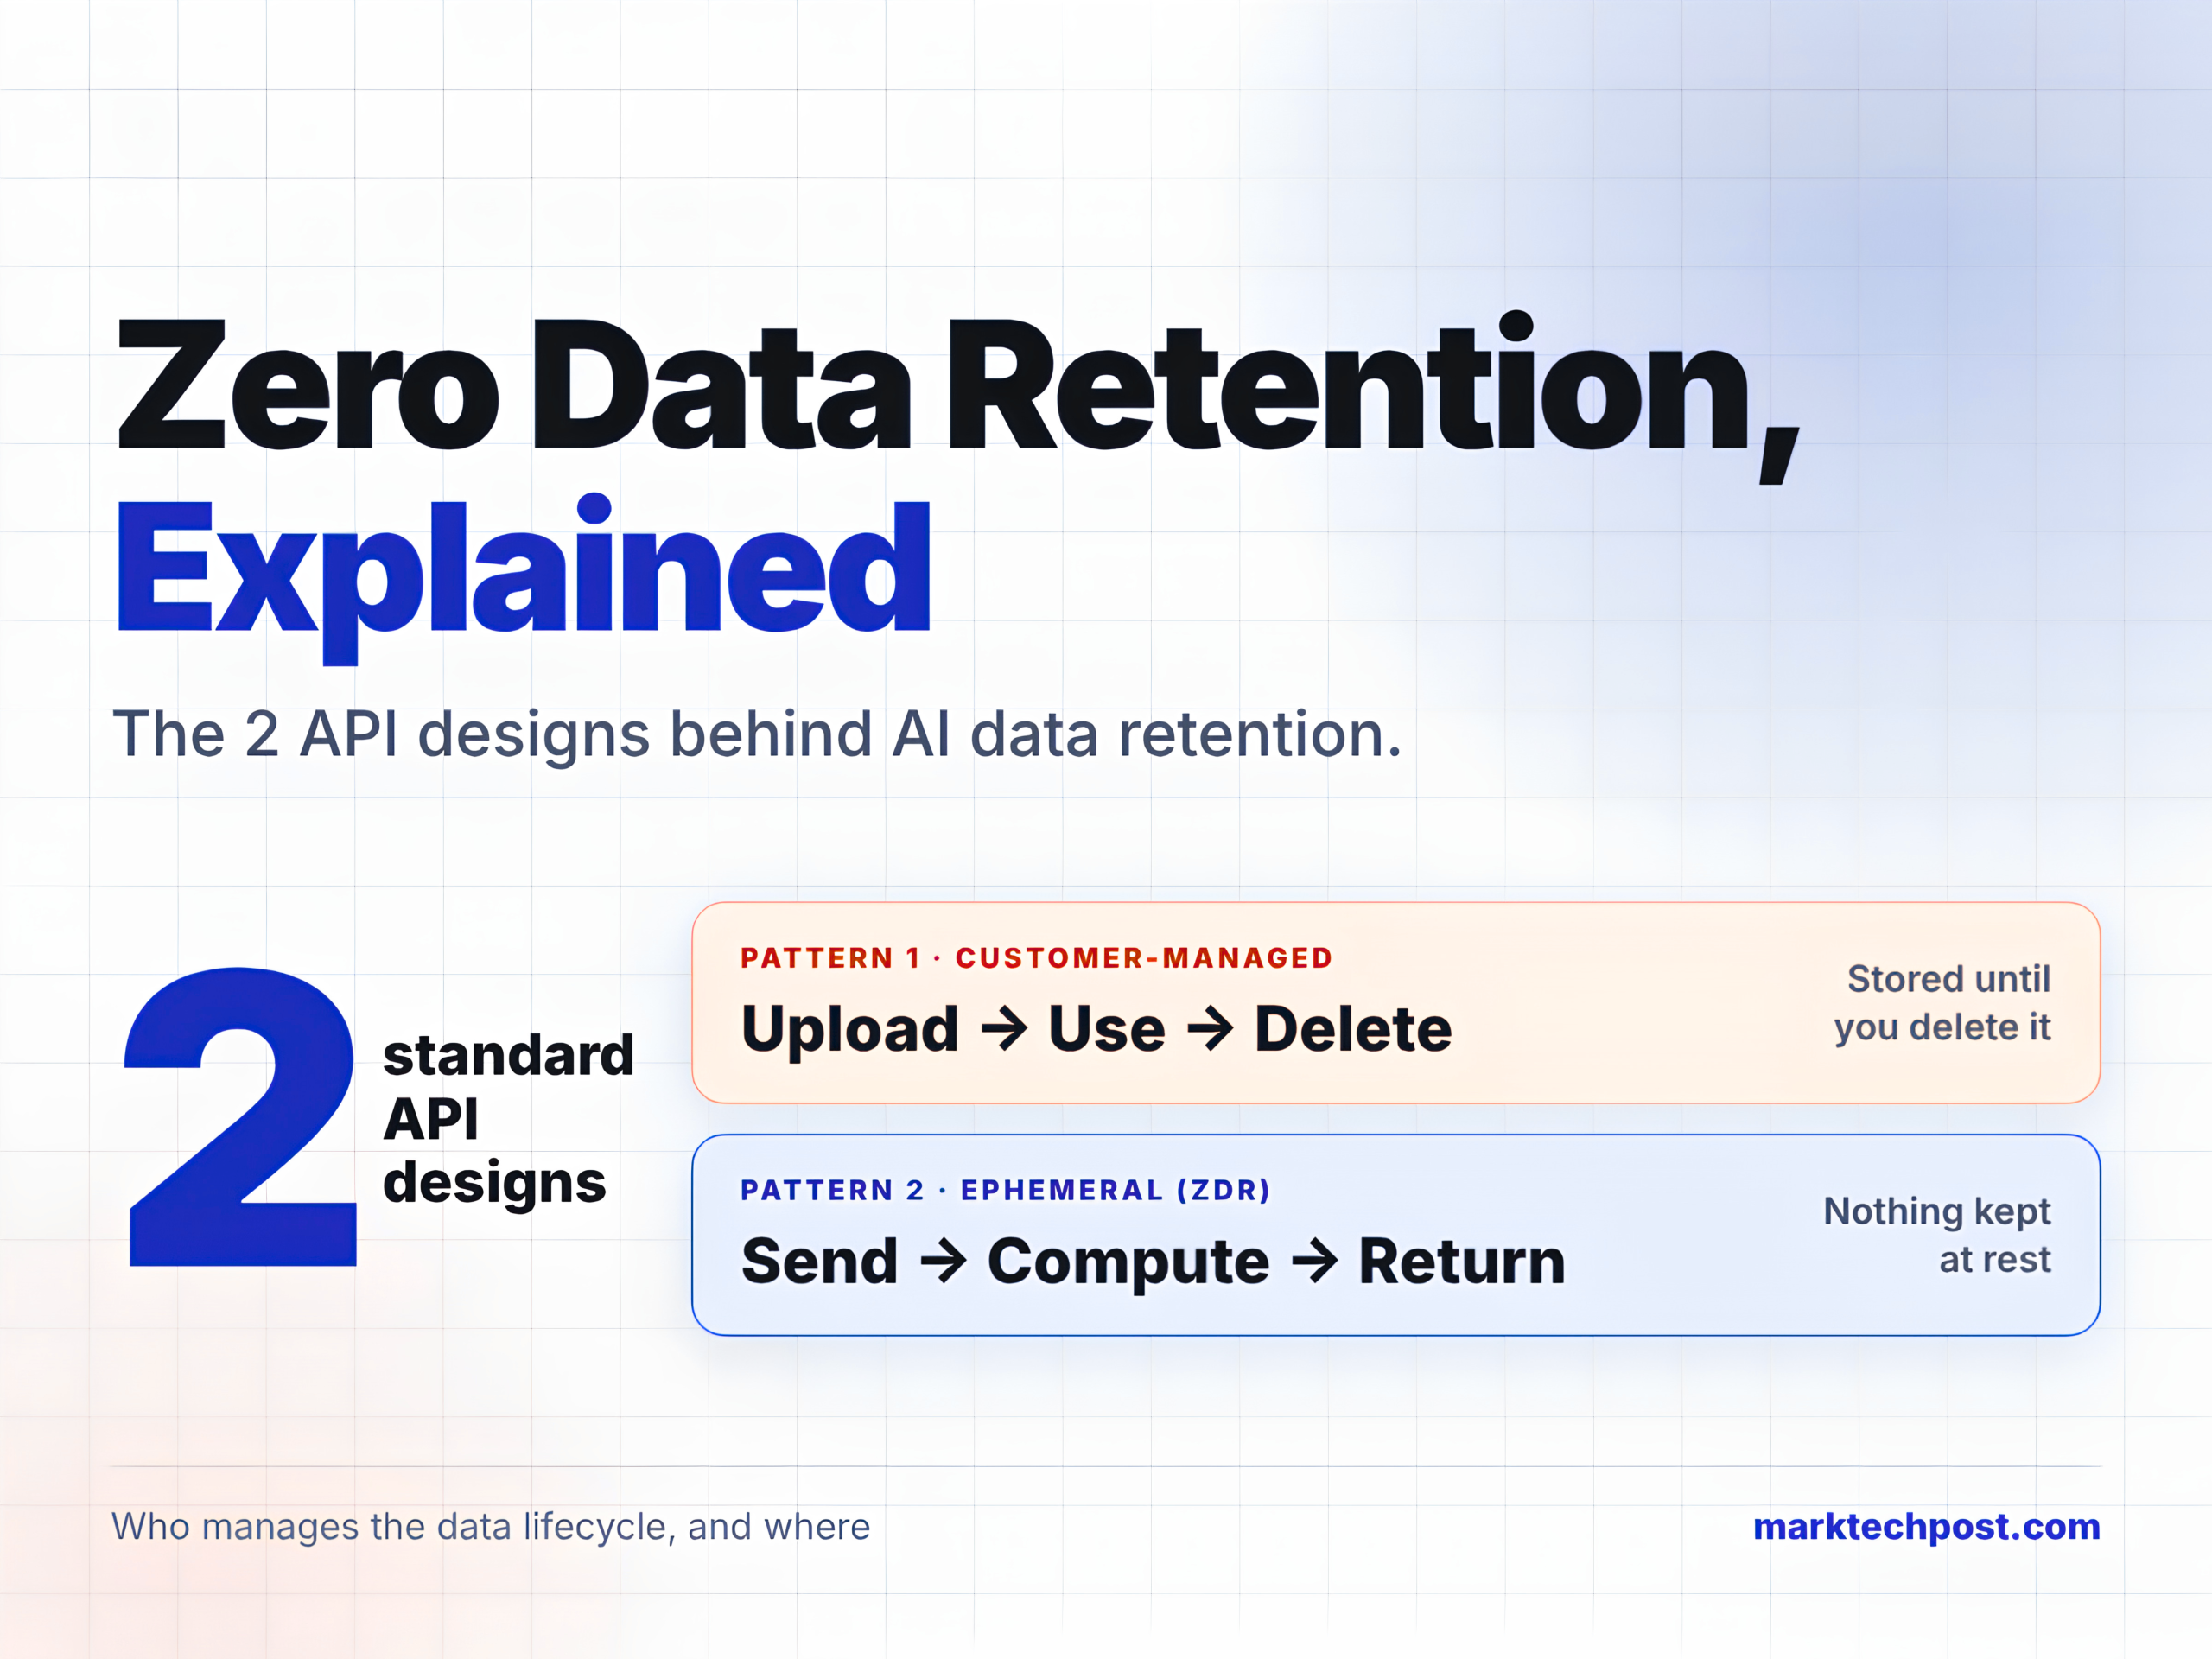
Задържането на данни при AI обикновено следва един от два API модела. При управлявано от клиента съхранение разработчикът качва файл или набор от данни, използва го за задачи и после го изтрива чрез платформата. Услугата запазва материала достъпен до изтриване или до изрично описан срок. Типичен пример са пакетните операции на OpenAI, Amazon Bedrock, Gemini и Fireworks AI, които работят с качени входни файлове или набори от данни.
При ефимерна обработка приложението изпраща данните, платформата изчислява резултат и го връща, без да запазва състояние на приложението. Именно с този модел се свързва нулевото задържане на данни (ZDR), но ZDR е ангажимент за конкретна крайна точка, а не за целия доставчик. Прилагането му може да зависи от параметри на заявката, настройки на акаунта и предварително одобрение. Отделни журнали за наблюдение срещу злоупотреби и кеширани функции могат да имат други правила.
Препоръката към разработчиците е да отнесат всяка използвана крайна точка към един от двата модела, да проверят настройки като store и да не приемат автоматично изтичане на срока. При всяко качване трябва да е ясен процесът за изтриване и описаният период на съхранение. Ефимерната обработка намалява броя на копията за защита, но съхраняваните набори остават нужни за пакетни задачи и обучение.
Текстът е изготвен от ИИ на Sakhanda Wire по материал на MarkTechPost. Фактите, цитатите и пълният контекст са в оригиналната статия по-долу.