Зберігання даних ШІ залежить від кінцевої точки API
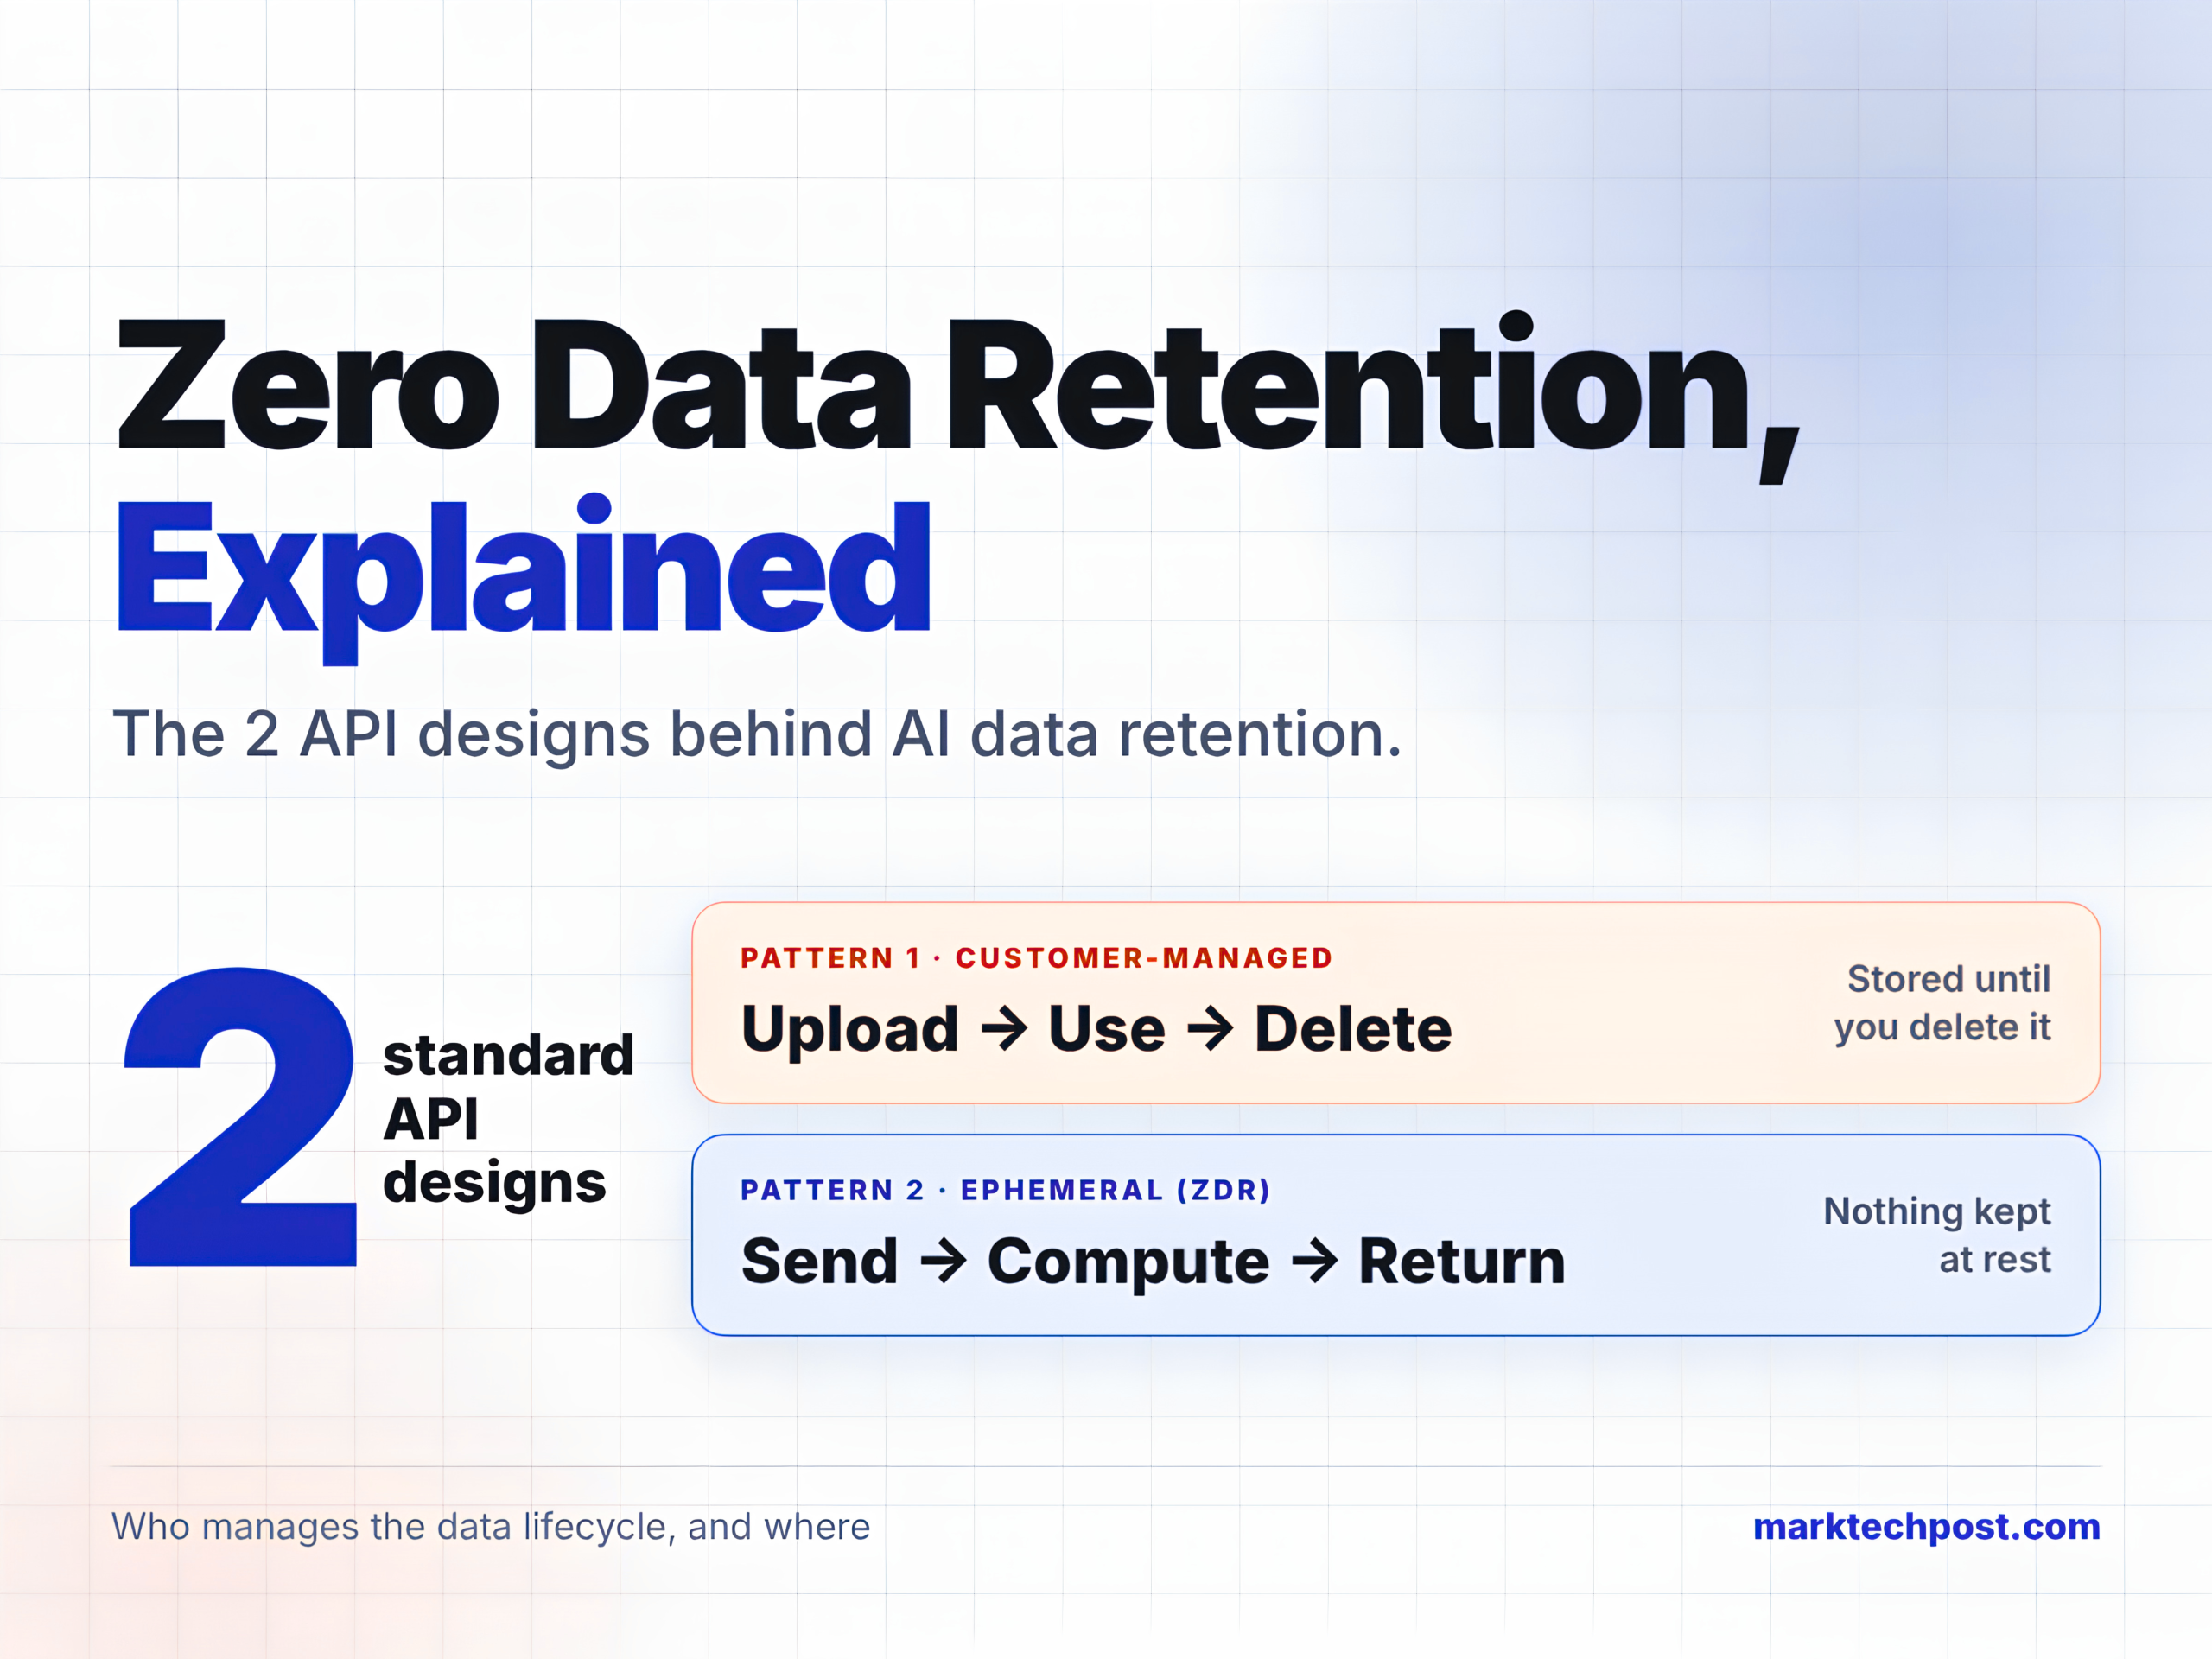
Зберігання даних у системах ШІ зазвичай працює за однією з двох моделей API. За моделі, де зберігання контролює клієнт, розробник завантажує файл або набір даних, запускає завдання, а потім видаляє об’єкт через платформу. Сервіс зберігає його доступним до видалення або до визначеного строку. Типовими прикладами є пакетні процеси OpenAI, Amazon Bedrock, Gemini та Fireworks AI, що використовують завантажені вхідні файли або набори даних.
За ефемерної обробки застосунок надсилає дані, платформа виконує обчислення й повертає результат, не зберігаючи стан застосунку. Із цією схемою пов’язане нульове зберігання даних (ZDR), але ZDR є властивістю конкретної кінцевої точки, а не всього постачальника. Застосування режиму може залежати від параметрів запиту, налаштувань облікового запису та попереднього схвалення. Журнали моніторингу зловживань, кеш і функції збереження можуть мати окремі правила.
Розробникам радять визначити модель для кожної кінцевої точки, перевірити параметри на кшталт store і не припускати автоматичного видалення без підтвердження. Для кожного завантаження слід заздалегідь визначити процедуру видалення та задокументований строк зберігання. Ефемерна обробка зменшує кількість копій, які потрібно захищати, але збережені набори даних залишаються потрібними для пакетних завдань і навчання моделей.
Текст підготовлено ШІ Sakhanda Wire за матеріалом MarkTechPost. Факти, цитати та повний контекст — в оригінальній статті нижче.