Срок хранения данных ИИ зависит от API-эндпоинта
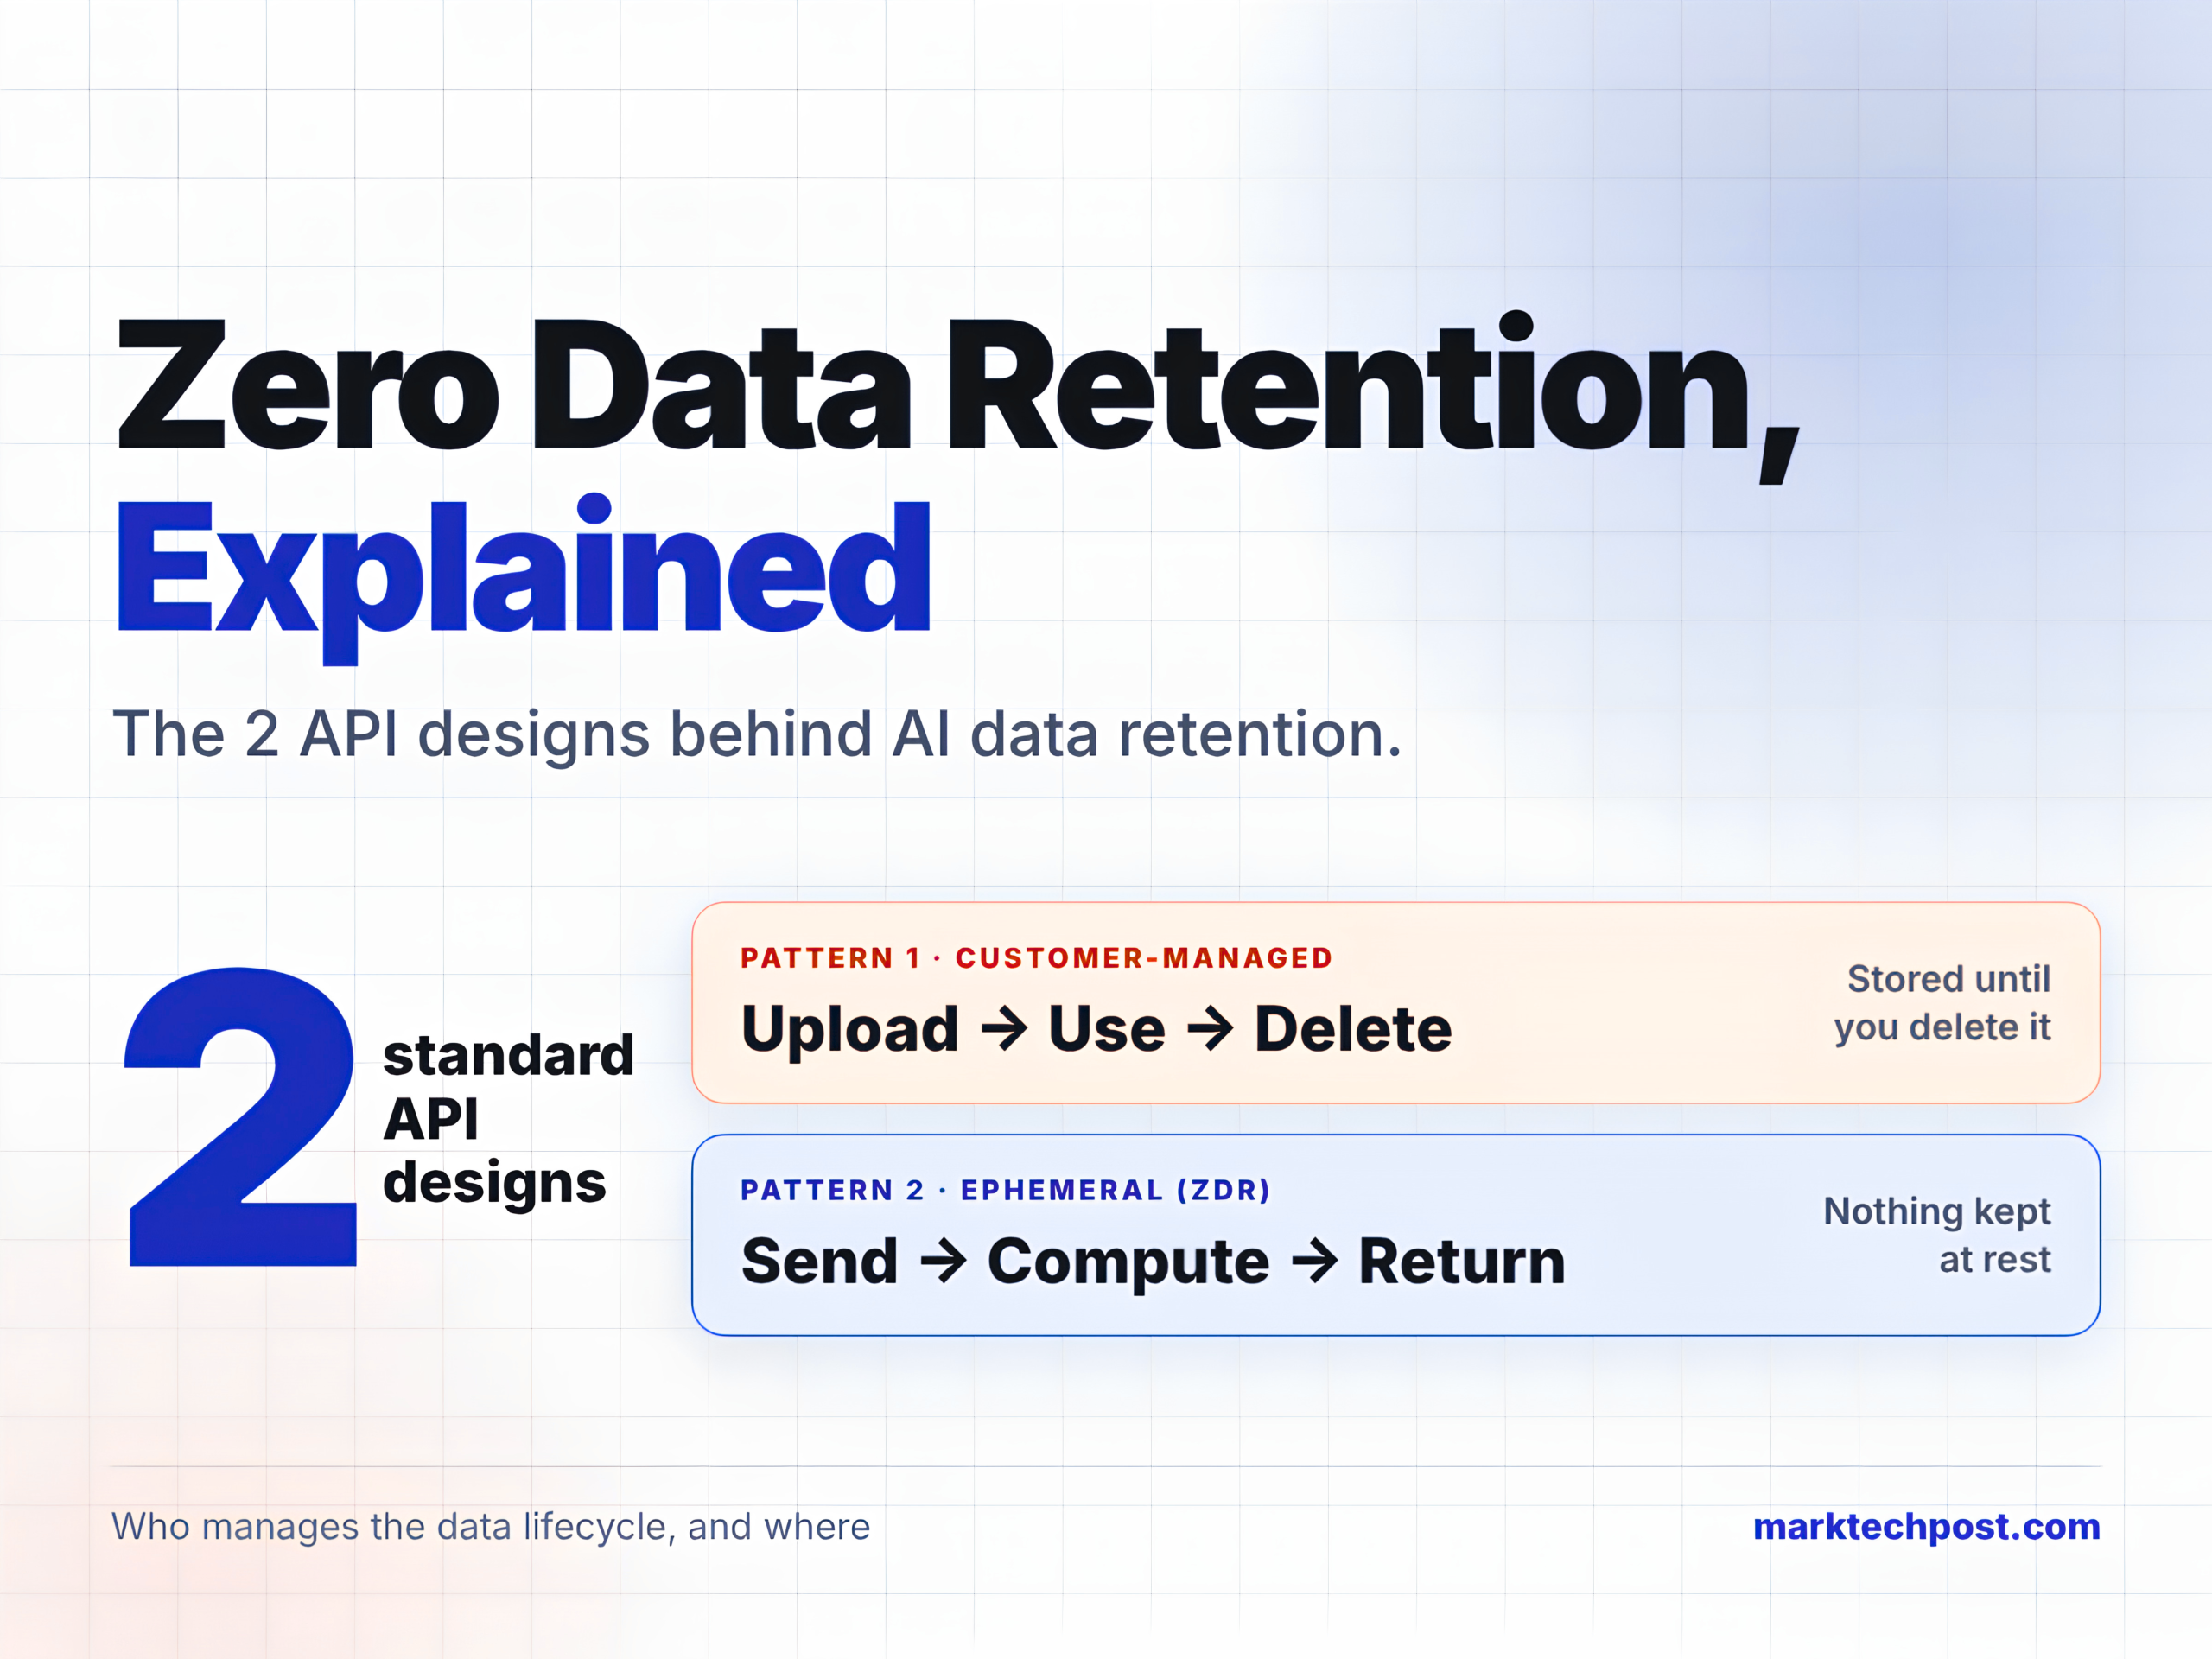
Хранение данных в ИИ-системах обычно организовано по одной из двух моделей API. При хранении под управлением клиента разработчик загружает файл или набор данных, запускает задания, а затем удаляет объект через платформу. Сервис сохраняет его доступным до удаления или до установленного срока. Типичные примеры — пакетные процессы OpenAI, Amazon Bedrock, Gemini и Fireworks AI, использующие загруженные входные файлы или наборы данных.
При эфемерной обработке приложение отправляет данные, платформа выполняет вычисление и возвращает результат, не сохраняя состояние приложения. С этой схемой связано нулевое хранение данных (ZDR), однако ZDR относится к конкретному эндпоинту, а не ко всему поставщику. Применимость может зависеть от параметров запроса, настроек аккаунта и предварительного согласования. Журналы мониторинга злоупотреблений, кэш и другие функции хранения могут регулироваться отдельно.
Разработчикам рекомендуется определить модель для каждого используемого эндпоинта, проверить параметры вроде store и не считать удаление после истечения срока гарантированным без подтверждения. Для каждого загруженного объекта следует заранее установить процедуру удаления и зафиксированный период хранения. Эфемерная обработка сокращает число копий, которые нужно защищать, но постоянное хранение остаётся необходимым для пакетных заданий и обучения моделей.
Текст подготовлен ИИ Sakhanda Wire по материалу MarkTechPost. Факты, цитаты и полный контекст — в оригинальной статье ниже.