NVIDIA обяви DGX Spark 64GB: настолен Grace Blackwell с 1 петафлоп за локални ИИ агенти, дообучаване и инференс
NVIDIA обяви нова конфигурация на DGX Spark с 64 GB — от Acer, ASUS, Dell, Gigabyte, HP и MSI — настолната AI система, задвижвана от GB10. Тя дава на разработчиците възможност да започнат с една система за локални модели и агенти, а след това да свържат в клъстер две устройства с по 64 GB, осигурявайки 128 GB памет в клъстера и повече изчислителна мощ при нарастване на натоварванията.
Директното послание е: стартирайте отворени модели и постоянно активни агенти на собственото си бюро, а след това свържете системи DGX Spark в клъстер с разрастването на работата — вместо да използвате API с таксуване според потреблението.
Моментът не е случаен. Агентите изразходват токени непрекъснато чрез извиквания на инструменти, повторни опити, дълъг контекст и многостъпкови планове. Потреблението на токени е нараснало 14 пъти от началото на 2026 г. При облачен API всеки от тези токени се таксува. При собствен хардуер няма такса за всеки токен.
Моделът с 64 GB запазва същия суперчип GB10 Grace Blackwell, софтуерния стек NVIDIA CUDA за ускорен AI и мрежовата свързаност ConnectX-7 като оригинала — но е оборудван с 64 GB унифицирана LPDDR5x памет вместо 128 GB. Според NVIDIA това е достатъчно за най-способните днешни отворени модели от клас 30–35B. NVIDIA продължава да предлага DGX Spark с 128 GB за по-големи натоварвания в една кутия, а свързването на устройства с 64 GB в клъстер добавя едновременно памет и изчислителна мощ.
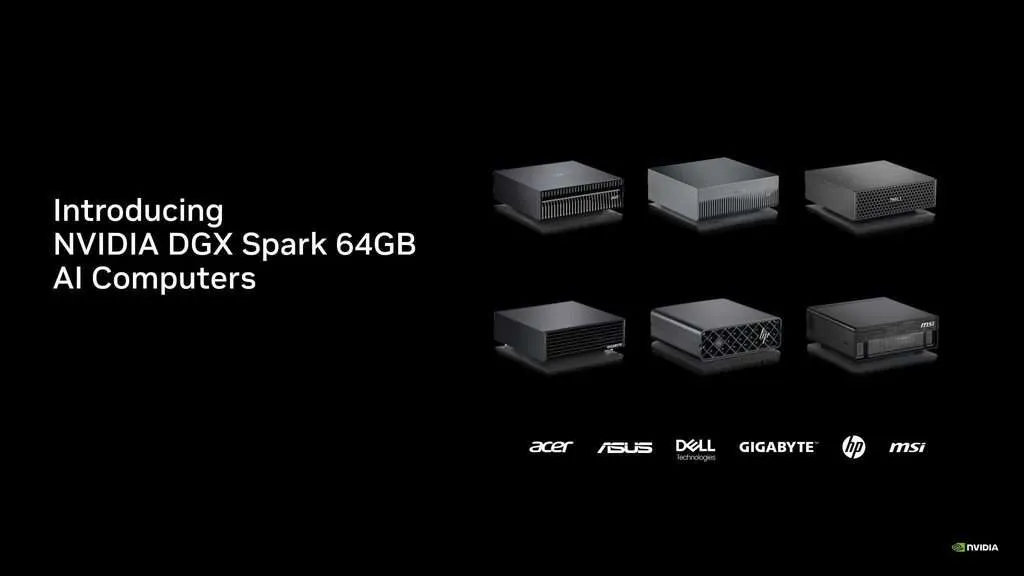
Какво има в кутията
GB10 комбинира графичен процесор Blackwell с Tensor ядра от 5-о поколение и 20-ядрен Arm процесор Grace. Графичният процесор осигурява до 1 петафлоп FP4 изчислителна мощ за AI със структурна разреденост.
| Спецификация | DGX Spark 64GB |
| Суперчип | NVIDIA GB10 Grace Blackwell |
| Процесор | 20-ядрен Arm (10× Cortex-X925 + 10× Cortex-A725) |
| AI изчисления | До 1 петафлоп FP4 (със структурна разреденост) |
| Памет | 64 GB LPDDR5x, кохерентна унифицирана |
| Пропускателна способност на паметта | 273 GB/s |
| Памет за съхранение | 1, 2 или 4 TB NVMe M.2, със самокриптиране |
| Мрежова свързаност | ConnectX-7 NIC, 200GbE; Wi-Fi 7, BT 5.3 |
| Дисплей | 1× HDMI 2.1a |
| Операционна система | NVIDIA DGX OS (базирана на Ubuntu) |
| Размери / тегло | 150 × 150 × 50,5 mm / 1,2 kg |
| Максимален размер на локалния модел | До 100B параметъра |
| Наличност | 23 октомври 2026 г. — NVIDIA Marketplace, OEM партньори, търговската мрежа |
Източник: спецификации на NVIDIA.
Унифицираната памет е ключовият избор в дизайна: Процесорът и графичният процесор споделят един общ пул чрез NVLink-C2C, с 5 пъти по-голяма пропускателна способност от PCIe Gen 5. Не е необходимо теглото на моделите да се копира между системната RAM и VRAM. За агентите това означава, че няколко модела, техните KV кешове и процесите на инструментите могат да работят в едно адресно пространство.
Софтуерът е готов още при първото стартиране: DGX OS се доставя със стека NVIDIA AI, включително PyTorch, Jupyter и Ollama. NVIDIA NemoClaw се инсталира с една команда. Той добавя контроли за поверителност и сигурност към агентите OpenClaw. NVIDIA OpenShellTM, част от NVIDIA Agent ToolkitTM, добавя базирани на политики защитни ограничения отгоре. Моделите NVIDIA NemotronTM са оптимизирани за системата.
Работи от стандартен електрически контакт: Не е необходимо сървърно помещение или специално охлаждане. Това е важно за агент, който трябва да работи денонощно.
Вградена мрежова свързаност за клъстериране: ConnectX-7 позволява две системи DGX Spark с 64 GB да бъдат свързани в клъстер с 128 GB памет и повече изчислителна мощ. NVIDIA Sync Cluster Assistant опростява настройката.
Кои отворени модели се побират в 64 GB
Хардуерът е само половината от историята. Другата половина е, че отворените модели от клас 30B са станали достатъчно добри за работа с агенти.
| Модел | Разработчик | Тип | Обем | Роля в Spark |
| Muse Glimmer | Meta | 29,6B плътен, текст + изображение, Apache 2.0 | ~17 GB (квантизиран) | Основен модел на агента |
| Nemotron 3.5 Lightning | NVIDIA | 30B MoE (30B-A3B) | NVFP4 чекпойнт | Бърз изпълнител за дълго работещи агенти |
| Qwen3.8-27B | Alibaba Qwen | 27B плътен | ~13,5 GB тегла (4-битов) | Общ агент и програмиране |
Посочените обеми са оценки само за теглата; KV кешът и разходите за изпълнение се добавят отделно.
Muse Glimmer е основният модел. Meta го е дистилирала от Muse Spark — моделното семейство зад асистента Meta AI. Той е насочен към локални агенти: надеждни извиквания на инструменти, дълги многостъпкови задачи и възстановяване след грешки. Meta отчита резултат 51,2 в SWE-Bench Pro и 75,5 в MCP Atlas. Контекстът достига 131K токена. Моделът се предлага и като NVIDIA NIM.
Пълната BF16 версия на Glimmer изисква над 55 GB, което оставя почти никакво място за контекст. Квантизираната версия с обем около 17 GB е практичният избор при 64 GB.
По-големи модели като DeepSeek V4 Flash изискват повече от една система. Собствените тестове на NVIDIA го изпълняват на 4 свързани в клъстер системи Spark с по 64 GB.
5 неща, които можете да създадете с една система
1. Постоянно активен личен агент
Инсталирайте Hermes и го насочете към Muse Glimmer или Nemotron 3.5 Lightning. Дайте му инструменти: вашите GitHub хранилища, тестов изпълнител и RSS емисия с категории от arXiv. Оставете го да работи през нощта.
До сутринта той ще е прегледал новите задачи, възпроизвел неуспешен тест и подготвил заявка за промяна за преглед. Освен това ще е обобщил 30-те статии, които иначе никога не бихте отворили. Личните ви бележки, кодът и имейлите ви никога не напускат машината.
2. Фино настройване на модел за програмиране върху собственото ви хранилище
QLoRA върху модел със 70B параметъра се побира в 64 GB. Обучете го върху кодовата си база, вътрешната документация и предишни прегледи на заявки за промяна. След това го предоставете локално като асистент за програмиране, който познава вашите конвенции.
NVIDIA е измерила около 18 400 токена/сек при разпределено фино настройване на nanochat върху един възел.
3. Лаборатория за оценяване на модели още в деня на пускането
Нов модел с отворени тегла се появява в Hugging Face. Изтеглете го чрез Ollama или vLLM още същия ден. Изпълнете собствен набор от въпроси спрямо него.
Оценете точността, след което измерете времето до първия токен (TTFT) и токените в секунда. Сравнете го с текущия си модел. Няма такса за API при повторно изпълнение на оценяването 50 пъти.
4. Екип от агенти с множество модели
Унифицираната памет позволява на няколко модела да споделят един пул. Използвайте Bonsai 2 като маршрутизатор, а Glimmer — като основен агент за разсъждение. Това са приблизително 23 GB тегла.
Останалото покрива KV кеша, операционната система и процесите на инструментите. Когато проблемът надхвърли локалния капацитет, агентът може да изпрати дезинфектирано запитване към по-голям облачен модел.
5. Прототипиране на периферни и роботизирани системи
Фино настройте визуален трансформатор за конкретна задача, например откриване на аномалии от камера на производствен цех. Валидирайте го локално със същия CUDA стек. След това го внедрете в устройство NVIDIA Jetson на периферията.
Когато една система не е достатъчна: клъстериране с NVIDIA Sync
Всеки DGX Spark се доставя с ConnectX-7 и 200GbE. Клъстерирането е вградена функция, а не допълнителна опция.
| Конфигурация | Обща памет | AI изчисления (FP4) | Връзка |
| 1 Spark (64 GB) | 64 GB | До 1 PFLOP | — |
| 2 Spark (по 64 GB) | 128 GB | До 2 PFLOPS | Директен QSFP кабел, без комутатор |
| 2 Spark (по 128 GB) | 256 GB | До 2 PFLOPS | Директен QSFP кабел, без комутатор |
| 3 Spark (по 128 GB) | 384 GB | До 3 PFLOPS | QSFP пръстен, без комутатор |
| 4 Spark (по 128 GB) | 512 GB | До 4 PFLOPS | 200GbE комутатор (QSFP56-DD, RoCE v2) |
Източник: NVIDIA. Изчисленията за 3 възела са извлечени от спецификациите за една система.
NVIDIA посочва, че 2 свързани в клъстер системи с по 64 GB осигуряват до 1,7 пъти по-висока производителност от един DGX Spark с 128 GB. Причината е удвоената изчислителна мощ и пропускателна способност за AI: 2 системи осигуряват общо до 546 GB/s, което е двойно повече от една система.
NVIDIA Sync е слоят за управление. Приложението за Windows и macOS открива Spark системите във вашата мрежа и управлява SSH достъпа. Неговият Cluster Assistant конфигурира мрежовата свързаност ConnectX-7 за до 4 системи. Възлите могат да се свързват и между различни местоположения чрез мрежа Tailscale, без облакът да участва в пътя на данните.
Моделът е съвсем ясен. Клъстерирането приблизително намалява наполовина времето до първия токен при всяко удвояване и мащабира финото настройване почти линейно. Декодирането се подобрява по-умерено — около 1,4 пъти при 4 възела. За агенти, които четат дълги входни данни, подобрението на TTFT е най-важно.
Подробни ръководства за работа с множество възли, включително vLLM върху подредени в клъстер Spark системи, са налични на build.nvidia.com/spark.
Какво представлява и какво не представлява
- Не е чат сървър за 100 потребители: Пропускателната способност от 273 GB/s ограничава едновременната производителност при декодиране.
- Създаден е за работа с дълги входни данни и кратки изходни резултати: Четене на хранилище, голям набор от логове или множество статии, след което генериране на кратък резултат.
- 64 GB ограничават една система до 100B параметъра: За повече параметри свържете 2 системи в клъстер или изберете конфигурацията с 128 GB.
Основни изводи
- DGX Spark 64GB запазва GB10, 1 PFLOP FP4 и пълния стек NVIDIA AI.
- 64 GB поддържат днешните отворени модели от клас 30–35B, като Qwen 3.8 27B и Nemotron 3.5 Lightning.
- Най-добрите приложения са постоянно активни агенти, фино настройване с QLoRA и оценяване на модели още в деня на пускането — без такси за всеки токен.
- 2 системи се свързват в клъстер чрез ConnectX-7 и NVIDIA Sync, осигурявайки 128 GB и до 1,7 пъти производителността на Spark с 128 GB.
- Наличен от 23 октомври; DGX Spark 128GB остава наличен.
Вижте продуктовата страница на DGX Spark, NVIDIA Sync и ръководствата за DGX Spark.
Благодарим на екипа на NVIDIA за експертните материали и ресурсите за тази статия. Тази статия е спонсорирана от NVIDIA.
Преведено автоматично от английски. Оригиналната статия е на връзката по-долу.