NVIDIA представила DGX Spark 64GB: настільну систему Grace Blackwell із продуктивністю 1 петафлоп для локальних ШІ-агентів, донавчання та інференсу
NVIDIA оголосила про нову конфігурацію DGX Spark із 64 ГБ пам’яті — від Acer, ASUS, Dell, Gigabyte, HP і MSI — настільної системи штучного інтелекту на базі GB10. Вона дає розробникам змогу почати з однієї системи для локальних моделей і агентів, а згодом об’єднати в кластер дві 64-гігабайтні системи, отримавши 128 ГБ пам’яті в кластері та більше обчислювальної потужності зі зростанням навантажень.
Безпосередній меседж такий: запускайте відкриті моделі й агентів, що працюють постійно, на власному столі, а потім об’єднуйте системи DGX Spark у кластер у міру зростання обсягу роботи — замість використання API з оплатою за споживання.
Час появи новинки не випадковий. Агенти безперервно витрачають токени під час викликів інструментів, повторних спроб, роботи з довгим контекстом і виконання багатокрокових планів. Споживання токенів зросло в 14 разів від початку 2026 року. У хмарному API кожен із цих токенів оплачується. На власному обладнанні плати за кожен токен немає.
Модель на 64 ГБ зберігає той самий суперчип GB10 Grace Blackwell, програмний стек NVIDIA CUDA для прискорення ШІ та мережеве підключення ConnectX-7, що й оригінальна версія, але оснащена 64 ГБ уніфікованої пам’яті LPDDR5x замість 128 ГБ. NVIDIA позиціонує її як достатню для найпотужніших сучасних відкритих моделей класу 30–35B. NVIDIA продовжує пропонувати DGX Spark на 128 ГБ для більших навантажень в одній системі, а об’єднання 64-гігабайтних систем у кластер одночасно додає пам’ять і обчислювальні ресурси.
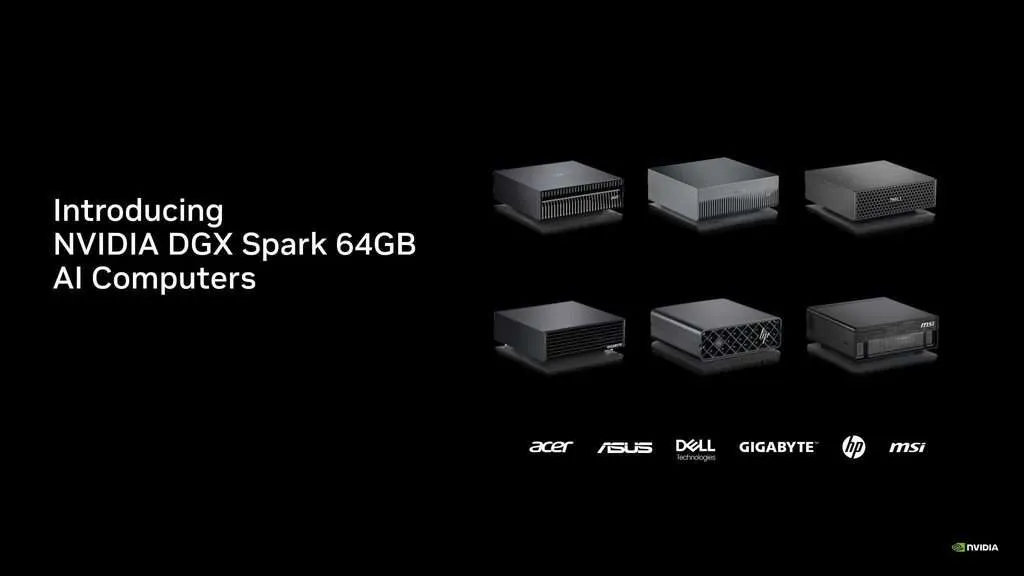
Що всередині
GB10 поєднує графічний процесор Blackwell із тензорними ядрами 5-го покоління та 20-ядерним процесором Grace на базі Arm. Графічний процесор забезпечує до 1 петафлопса обчислень ШІ у форматі FP4 із використанням розрідженості.
| Характеристика | DGX Spark 64GB |
| Суперчип | NVIDIA GB10 Grace Blackwell |
| Процесор | 20-ядерний Arm (10× Cortex-X925 + 10× Cortex-A725) |
| Обчислення ШІ | До 1 петафлопса FP4 (із використанням розрідженості) |
| Пам’ять | 64 ГБ LPDDR5x, когерентна уніфікована |
| Пропускна здатність пам’яті | 273 ГБ/с |
| Накопичувач | NVMe M.2 на 1, 2 або 4 ТБ, із самошифруванням |
| Мережа | Мережевий адаптер ConnectX-7, 200GbE; Wi-Fi 7, BT 5.3 |
| Дисплей | 1× HDMI 2.1a |
| ОС | NVIDIA DGX OS (на базі Ubuntu) |
| Розмір / вага | 150 × 150 × 50,5 мм / 1,2 кг |
| Максимальний розмір локальної моделі | До 100B параметрів |
| Доступність | 23 жовтня 2026 року — NVIDIA Marketplace, партнери-виробники, роздрібна торгівля |
Джерело: технічні характеристики NVIDIA.
Уніфікована пам’ять — ключове конструктивне рішення: процесор і графічний процесор спільно використовують один пул пам’яті через NVLink-C2C, із пропускною здатністю, що у 5 разів перевищує показник PCIe Gen 5. Не потрібно копіювати ваги між системною оперативною пам’яттю та VRAM. Для агентів це означає, що кілька моделей, їхні KV-кеші та процеси інструментів працюють в одному адресному просторі.
Програмне забезпечення готове вже під час першого запуску: DGX OS постачається зі стеком NVIDIA AI, зокрема PyTorch, Jupyter та Ollama. NVIDIA NemoClaw встановлюється однією командою. Він додає засоби конфіденційності та безпеки для агентів OpenClaw. NVIDIA OpenShellTM, що входить до складу NVIDIA Agent ToolkitTM, додає політичні обмеження й захисні механізми. Моделі NVIDIA NemotronTM оптимізовані для цієї системи.
Система працює від звичайної розетки: серверна кімната чи спеціальне охолодження не потрібні. Це важливо для агента, який має працювати цілодобово.
Вбудована мережа для кластеризації: ConnectX-7 дає змогу об’єднати дві системи DGX Spark 64GB у кластер зі 128 ГБ пам’яті та більшою обчислювальною потужністю. NVIDIA Sync Cluster Assistant спрощує налаштування.
Які відкриті моделі поміщаються в 64 ГБ
Обладнання — лише половина історії. Друга полягає в тому, що відкриті моделі класу 30B стали достатньо якісними для роботи агентів.
| Модель | Розробник | Тип | Обсяг | Роль у Spark |
| Muse Glimmer | Meta | 29,6B щільна, текст + зображення, Apache 2.0 | ~17 ГБ (квантизована) | Основна модель агента |
| Nemotron 3.5 Lightning | NVIDIA | 30B MoE (30B-A3B) | Контрольна точка NVFP4 | Швидкий виконавець для агентів із тривалим часом роботи |
| Qwen3.8-27B | Alibaba Qwen | 27B щільна | ~13,5 ГБ ваг (4-бітні) | Універсальний агент і програмування |
Оцінки обсягу стосуються лише ваг; KV-кеш і накладні витрати середовища виконання додаються окремо.
Muse Glimmer — основна модель. Meta дистилювала її з Muse Spark — сімейства моделей, що лежить в основі асистента Meta AI. Вона орієнтована на локальних агентів: надійні виклики інструментів, виконання довгих багатокрокових завдань і відновлення після збоїв. Meta повідомляє про результат 51,2 у SWE-Bench Pro та 75,5 у MCP Atlas. Контекст може містити до 131 тисячі токенів. Модель також доступна як NVIDIA NIM.
Повна версія Glimmer у форматі BF16 потребує понад 55 ГБ, майже не залишаючи місця для контексту. Практичним вибором для 64 ГБ є квантизована версія обсягом близько 17 ГБ.
Для більших моделей, як-от DeepSeek V4 Flash, потрібно більше однієї системи. Власні тести NVIDIA запускають її на 4 об’єднаних у кластер Spark по 64 ГБ.
5 речей, які можна створити на одній системі
1. Персональний агент, що працює постійно
Встановіть Hermes і підключіть його до Muse Glimmer або Nemotron 3.5 Lightning. Надайте йому інструменти: ваші репозиторії GitHub, засіб запуску тестів, RSS-стрічку категорій arXiv. Дозвольте йому працювати вночі.
До ранку він розбере нові проблеми, відтворить помилку в тесті та підготує pull request для перевірки. Він також узагальнить 30 статей, які ви ніколи не відкрили б. Ваші приватні нотатки, код і електронна пошта ніколи не залишать машину.
2. Дообучення моделі програмування на власному репозиторії
QLoRA для моделі 70B поміщається в 64 ГБ. Навчіть її на своїй кодовій базі, внутрішній документації та минулих перевірках pull request. Потім використовуйте її локально як асистента програмування, який знає ваші правила.
NVIDIA виміряла близько 18 400 токенів/с на одному вузлі для розподіленого дообучення nanochat.
3. Тестовий стенд для оцінювання моделей у день їхнього випуску
Нова модель із відкритими вагами з’являється на Hugging Face. Завантажте її через Ollama або vLLM того ж дня. Перевірте її на власному наборі запитань.
Оцініть точність, а потім виміряйте час до першого токена (TTFT) і кількість токенів за секунду. Порівняйте її з поточною моделлю. За повторний запуск оцінювання 50 разів не потрібно платити за API.
4. Команда агентів із кількох моделей
Уніфікована пам’ять дає змогу кільком моделям спільно використовувати один пул. Запустіть Bonsai 2 як маршрутизатор, а Glimmer — як основного агента для міркувань. Разом їхні ваги займають приблизно 23 ГБ.
Решти вистачить на KV-кеш, ОС і процеси інструментів. Коли проблема виходить за межі локальних можливостей, агент може надіслати очищене запитання до більшої хмарної моделі.
5. Прототипування для периферійних систем і робототехніки
Дообучіть візуальний трансформер для конкретного завдання, наприклад виявлення аномалій на зображенні з камери виробничого цеху. Перевірте його локально з тим самим стеком CUDA. Потім розгорніть його на периферійному пристрої NVIDIA Jetson.
Коли однієї системи недостатньо: кластеризація за допомогою NVIDIA Sync
Кожна система DGX Spark постачається з ConnectX-7 і підтримкою 200GbE. Кластеризація є вбудованою функцією, а не додатковою опцією.
| Конфігурація | Об’єднана пам’ять | Обчислення ШІ (FP4) | Підключення |
| 1 Spark (64 ГБ) | 64 ГБ | До 1 PFLOP | — |
| 2 Spark (по 64 ГБ) | 128 ГБ | До 2 PFLOPS | Прямий кабель QSFP, без комутатора |
| 2 Spark (по 128 ГБ) | 256 ГБ | До 2 PFLOPS | Прямий кабель QSFP, без комутатора |
| 3 Spark (по 128 ГБ) | 384 ГБ | До 3 PFLOPS | Кільце QSFP, без комутатора |
| 4 Spark (по 128 ГБ) | 512 ГБ | До 4 PFLOPS | Комутатор 200GbE (QSFP56-DD, RoCE v2) |
Джерело: NVIDIA. Обчислення для 3 вузлів виведено з характеристик однієї системи.
NVIDIA стверджує, що 2 об’єднані в кластер системи по 64 ГБ забезпечують до 1,7 раза вищу продуктивність, ніж одна DGX Spark на 128 ГБ. Причина — подвоєні обчислювальна потужність ШІ та пропускна здатність: 2 системи забезпечують до 546 ГБ/с у сукупності — удвічі більше, ніж одна система.
NVIDIA Sync — це рівень керування. Застосунок для Windows і macOS виявляє Spark у мережі та керує доступом через SSH. Його Cluster Assistant налаштовує мережу ConnectX-7 для до 4 систем. Вузли також можуть підключатися між різними місцями через mesh-мережу Tailscale, без проходження даних через хмару.
Схема досить зрозуміла. Кластеризація приблизно вдвічі скорочує час до першого токена з кожним подвоєнням кількості систем і забезпечує майже лінійне масштабування дообучення. Декодування покращується скромніше — приблизно в 1,4 раза на 4 вузлах. Для агентів, які читають довгі вхідні дані, вирішальним є саме виграш у TTFT.
Покрокові посібники для роботи з кількома вузлами, зокрема vLLM на об’єднаних у стек Spark, доступні на build.nvidia.com/spark.
Що це таке, а чим це не є
- Не чат-сервер для 100 користувачів: пропускна здатність 273 ГБ/с обмежує сукупну швидкість декодування для одночасних запитів.
- Створено для роботи з довгим введенням і коротким виведенням: читання репозиторію, великого масиву журналів або стосу статей із подальшим написанням короткого результату.
- 64 ГБ обмежують розмір моделі в одній системі до 100B параметрів: для більших моделей об’єднайте 2 системи в кластер або оберіть конфігурацію на 128 ГБ.
Ключові висновки
- DGX Spark 64GB зберігає GB10, 1 PFLOP FP4 і повний стек NVIDIA AI.
- 64 ГБ достатньо для сучасних відкритих моделей класу 30–35B, як-от Qwen 3.8 27B і Nemotron 3.5 Lightning.
- Найкращі варіанти використання: агенти, що працюють постійно, дообучення QLoRA та оцінювання моделей у день їхнього випуску — без плати за кожен токен.
- 2 системи об’єднуються в кластер через ConnectX-7 за допомогою NVIDIA Sync, забезпечуючи 128 ГБ і продуктивність до 1,7 раза вищу, ніж у Spark на 128 ГБ.
- Доступна з 23 жовтня; DGX Spark 128GB залишається доступною.
Відвідайте сторінку продукту DGX Spark, NVIDIA Sync і посібники DGX Spark.
Дякуємо команді NVIDIA за експертні матеріали та ресурси для цієї статті. Цю статтю спонсувала NVIDIA.
Перекладено автоматично з англійської. Оригінал статті — за посиланням нижче.