NVIDIA представила DGX Spark 64GB: настольную систему Grace Blackwell с производительностью 1 петафлопс для локальных ИИ-агентов, дообучения и инференса
NVIDIA объявила о новой конфигурации DGX Spark с 64 ГБ — от Acer, ASUS, Dell, Gigabyte, HP и MSI — своей настольной ИИ-системы на базе GB10. Она дает разработчикам возможность начать с одной системы для локальных моделей и агентов, а затем объединить два устройства по 64 ГБ в кластер с 128 ГБ памяти и большей вычислительной мощностью по мере роста рабочих нагрузок.
Главная идея такова: запускайте открытые модели и постоянно работающих агентов прямо на своем столе, а затем объединяйте системы DGX Spark в кластер по мере роста задач — вместо использования API с оплатой за потребление.
Выбор времени не случаен. Агенты непрерывно расходуют токены во время вызовов инструментов, повторных попыток, работы с длинным контекстом и выполнения многоэтапных планов. Потребление токенов выросло в 14 раз с начала 2026 года. При использовании облачного API каждый из этих токенов оплачивается. На собственном оборудовании плата за каждый токен отсутствует.
Модель с 64 ГБ сохраняет тот же суперчип GB10 Grace Blackwell, программный стек NVIDIA для ИИ с ускорением CUDA и сетевое подключение ConnectX-7, что и оригинальная версия, — но оснащается 64 ГБ унифицированной памяти LPDDR5x вместо 128 ГБ. NVIDIA считает этого достаточно для наиболее производительных открытых моделей класса 30–35B на сегодняшний день. NVIDIA продолжает предлагать DGX Spark со 128 ГБ для более крупных задач в рамках одного корпуса, а объединение устройств по 64 ГБ увеличивает одновременно и объем памяти, и вычислительную мощность.
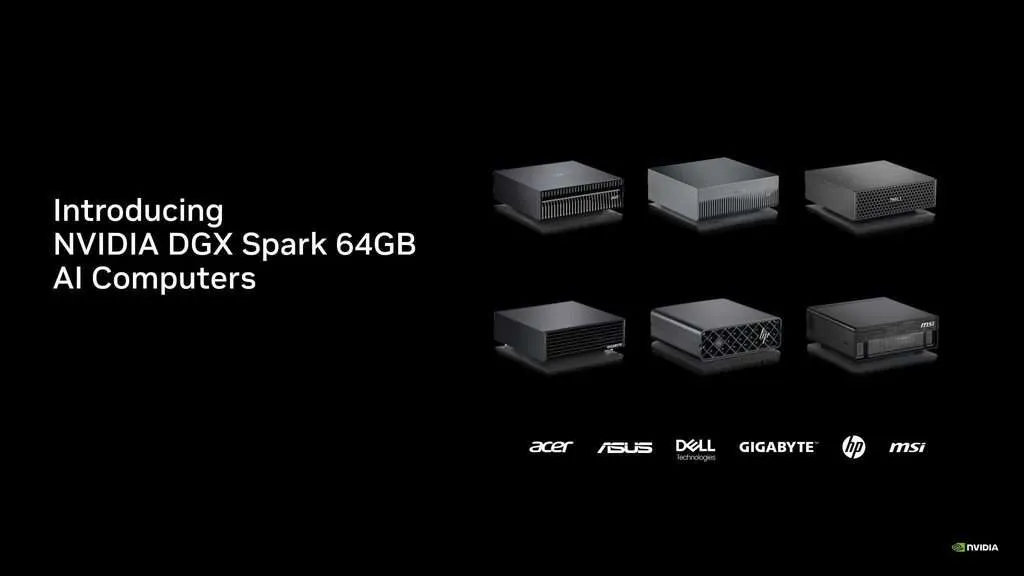
Что находится внутри
GB10 объединяет графический процессор Blackwell с тензорными ядрами пятого поколения и 20-ядерный процессор Grace на базе Arm. GPU обеспечивает до 1 петафлопса вычислений ИИ FP4 с учетом разреженности.
| Характеристика | DGX Spark 64GB |
| Суперчип | NVIDIA GB10 Grace Blackwell |
| CPU | 20-ядерный Arm (10× Cortex-X925 + 10× Cortex-A725) |
| Вычисления ИИ | До 1 петафлопса FP4 (с учетом разреженности) |
| Память | 64 ГБ LPDDR5x, когерентная унифицированная |
| Пропускная способность памяти | 273 ГБ/с |
| Накопитель | 1, 2 или 4 ТБ NVMe M.2, с самошифрованием |
| Сетевые подключения | Сетевой адаптер ConnectX-7, 200GbE; Wi-Fi 7, BT 5.3 |
| Дисплей | 1× HDMI 2.1a |
| ОС | NVIDIA DGX OS (на базе Ubuntu) |
| Размер / вес | 150 × 150 × 50,5 мм / 1,2 кг |
| Максимальный размер локальной модели | До 100 млрд параметров |
| Доступность | 23 октября 2026 года — NVIDIA Marketplace, партнеры — производители оборудования, розничные продавцы |
Источник: спецификации NVIDIA.
Унифицированная память — ключевое конструктивное решение: CPU и GPU используют общий пул через NVLink-C2C, обеспечивающий в 5 раз большую пропускную способность по сравнению с PCIe Gen 5. Не требуется копировать веса между системной оперативной памятью и VRAM. Для агентов это означает, что несколько моделей, их KV-кэши и процессы инструментов работают в одном адресном пространстве.
Программное обеспечение готово уже при первом запуске: DGX OS поставляется со стеком NVIDIA AI, включая PyTorch, Jupyter и Ollama. NVIDIA NemoClaw устанавливается одной командой. Он добавляет средства обеспечения конфиденциальности и безопасности для агентов OpenClaw. NVIDIA OpenShellTM, входящий в состав NVIDIA Agent ToolkitTM, дополняет их политиками и защитными ограничениями. Модели NVIDIA NemotronTM оптимизированы для этой системы.
Система работает от стандартной розетки: серверная не требуется, как и специальное охлаждение. Это важно для агента, который должен работать круглосуточно.
Встроенные сетевые возможности для кластеризации: ConnectX-7 позволяет объединить две системы DGX Spark 64GB в кластер с 128 ГБ памяти и большей вычислительной мощностью. NVIDIA Sync Cluster Assistant упрощает настройку.
Какие открытые модели помещаются в 64 ГБ
Аппаратное обеспечение — лишь половина истории. Другая половина заключается в том, что открытые модели класса 30B стали достаточно хороши для работы агентов.
| Модель | Разработчик | Тип | Объем | Роль на Spark |
| Muse Glimmer | Meta | 29,6B, плотная, текст + изображение, Apache 2.0 | ~17 ГБ (квантизированная) | Основная модель агента |
| Nemotron 3.5 Lightning | NVIDIA | 30B MoE (30B-A3B) | Контрольная точка NVFP4 | Быстрый исполнитель для длительно работающих агентов |
| Qwen3.8-27B | Alibaba Qwen | 27B, плотная | ~13,5 ГБ весов (4-битная) | Универсальный агент и программирование |
Оценки относятся только к весам; KV-кэш и накладные расходы среды выполнения добавляются сверху.
Muse Glimmer — основная модель. Meta дистиллировала ее из Muse Spark — семейства моделей, лежащего в основе ассистента Meta AI. Она ориентирована на локальных агентов: надежные вызовы инструментов, длительные многоэтапные задачи и восстановление после сбоев. Meta сообщает о результатах 51,2 в SWE-Bench Pro и 75,5 в MCP Atlas. Контекст достигает 131 тыс. токенов. Она также доступна в виде NVIDIA NIM.
Полная версия Glimmer в формате BF16 требует более 55 ГБ, практически не оставляя места для контекста. Поэтому сборка объемом около 17 ГБ в квантизированном виде является практичным выбором для 64 ГБ.
Более крупным моделям, таким как DeepSeek V4 Flash, требуется больше одного устройства. В собственных тестах NVIDIA запускает ее на четырех объединенных в кластер Spark по 64 ГБ.
5 вещей, которые можно создать на одной системе
1. Постоянно работающий персональный агент
Установите Hermes и подключите его к Muse Glimmer или Nemotron 3.5 Lightning. Предоставьте ему инструменты: ваши репозитории GitHub, средство запуска тестов, RSS-ленту категорий arXiv. Пусть он работает всю ночь.
К утру он распределит новые задачи, воспроизведет неудачный тест и подготовит pull request для проверки. Он также суммирует содержание 30 статей, которые вы никогда бы не открыли. Ваши личные заметки, код и электронная почта никогда не покинут машину.
2. Дообучение модели программирования на собственном репозитории
QLoRA для модели 70B помещается в 64 ГБ. Обучите ее на своей кодовой базе, внутренних документах и прошлых проверках pull request. Затем используйте ее локально в качестве помощника по программированию, знакомого с вашими соглашениями и правилами.
NVIDIA измерила около 18 400 токенов/с на одном узле при распределенном дообучении nanochat.
3. Стенд для оценки моделей в день их выхода
Новая модель с открытыми весами появляется на Hugging Face. Загрузите ее через Ollama или vLLM в тот же день. Проверьте ее на собственном наборе вопросов.
Оцените точность, а затем измерьте время до первого токена (TTFT) и количество токенов в секунду. Сравните результаты с текущей моделью. За повторный запуск оценки 50 раз платить за API не придется.
4. Команда агентов с несколькими моделями
Унифицированная память позволяет нескольким моделям использовать общий пул. Запустите Bonsai 2 в качестве маршрутизатора, а Glimmer — в качестве основного агента рассуждений. Вместе их веса занимают примерно 23 ГБ.
Остального объема хватит на KV-кэш, ОС и процессы инструментов. Когда задача выходит за пределы локальных возможностей, агент может отправить обезличенный вопрос более крупной облачной модели.
5. Прототипирование для периферийных устройств и робототехники
Дообучите vision transformer для конкретной задачи, например обнаружения аномалий на изображении с камеры на производственном этаже. Проверьте ее локально с тем же стеком CUDA. Затем разверните ее на устройстве NVIDIA Jetson на периферии.
Когда одной системы недостаточно: кластеризация с NVIDIA Sync
Каждая система DGX Spark поставляется с ConnectX-7 и подключением 200GbE. Кластеризация — встроенная функция, а не дополнительная опция.
| Конфигурация | Общий объем памяти | Вычисления ИИ (FP4) | Подключение |
| 1 Spark (64 ГБ) | 64 ГБ | До 1 PFLOP | — |
| 2 Spark (по 64 ГБ) | 128 ГБ | До 2 PFLOPS | Прямой кабель QSFP, без коммутатора |
| 2 Spark (по 128 ГБ) | 256 ГБ | До 2 PFLOPS | Прямой кабель QSFP, без коммутатора |
| 3 Spark (по 128 ГБ) | 384 ГБ | До 3 PFLOPS | Кольцо QSFP, без коммутатора |
| 4 Spark (по 128 ГБ) | 512 ГБ | До 4 PFLOPS | Коммутатор 200GbE (QSFP56-DD, RoCE v2) |
Источник: NVIDIA. Вычисления для 3 узлов рассчитаны на основе характеристик одного устройства.
NVIDIA заявляет, что два объединенных в кластер устройства по 64 ГБ обеспечивают до 1,7 раза большую производительность, чем один DGX Spark со 128 ГБ. Причина заключается в удвоенных вычислительных возможностях ИИ и пропускной способности: два устройства обеспечивают до 546 ГБ/с в совокупности — вдвое больше, чем одна система.
NVIDIA Sync — это уровень управления. Приложение для Windows и macOS обнаруживает Spark в сети и управляет доступом по SSH. Cluster Assistant настраивает сетевое подключение ConnectX-7 для четырех систем. Узлы также могут подключаться между разными местоположениями через mesh-сеть Tailscale, при этом облако не участвует в передаче данных.
Картина довольно ясна. Кластеризация примерно вдвое сокращает время до первого токена при каждом удвоении числа устройств и обеспечивает почти линейное масштабирование дообучения. Декодирование улучшается более умеренно — примерно в 1,4 раза при четырех узлах. Для агентов, которые читают длинные входные данные, прирост TTFT имеет наибольшее значение.
Пошаговые руководства по работе с несколькими узлами, включая vLLM на объединенных в кластер Spark, доступны на сайте build.nvidia.com/spark.
Что это такое, а чем это не является
- Не чат-сервер для 100 пользователей: пропускная способность 273 ГБ/с ограничивает параллельную производительность декодирования.
- Создано для работы с длинными входными и короткими выходными данными: чтение репозитория, дампа логов или набора статей с последующей выдачей краткого результата.
- 64 ГБ ограничивают размер модели в одной системе 100 млрд параметров: для большего объема объедините два устройства в кластер или выберите конфигурацию с 128 ГБ.
Главные выводы
- DGX Spark 64GB сохраняет GB10, 1 PFLOP FP4 и полный стек NVIDIA AI.
- 64 ГБ достаточно для современных открытых моделей класса 30–35B, таких как Qwen 3.8 27B и Nemotron 3.5 Lightning.
- Лучшие варианты использования: постоянно работающие агенты, дообучение QLoRA и оценка моделей в день их выхода — без платы за каждый токен.
- Два устройства объединяются в кластер через ConnectX-7 с помощью NVIDIA Sync, обеспечивая 128 ГБ и до 1,7-кратной производительности Spark со 128 ГБ.
- Доступно с 23 октября; DGX Spark 128GB остается в продаже.
Подробнее см. на странице продукта DGX Spark, на странице NVIDIA Sync и в руководствах DGX Spark.
Благодарим команду NVIDIA за экспертные материалы и ресурсы для этой статьи. Эта статья спонсирована NVIDIA.
Переведено автоматически с английского. Оригинал статьи — по ссылке ниже.