Текстовото преобразуване в реч на Gemini 3.8 казва „здравей“

23 септември 2026 г.
|Gemini 3.8 Flash TTS и Gemini 3.8 Flash-Lite TTS са най-изразителните ни модели за генериране на аудио досега. Създавайте персонализирани гласове на герои и режисирайте диалози по сцени в Google AI Studio, Gemini API, Gemini Enterprise, Gemini Notebook и Google Vids.
Leland Rechis
Групов продуктов мениджър
Alan Cowen
Директор „Научни изследвания“, от името на екипа Gemini Audio
Днес представяме два нови модела за преобразуване на текст в реч към семейството Gemini, превръщайки генерирането на глас от статични предварителни настройки в динамично творческо студио. Тези модели позволяват на създатели, разработчици и предприятия да създават по-богати и по-изразителни аудио изживявания, като същевременно подобряват потребителското изживяване в продукти като Gemini Notebook и Google Vids.
- Gemini 3.8 Flash TTS: Създаден за задълбочено творческо режисиране и разработване на герои. Създавайте изцяло нови гласове от нулата чрез подкани на естествен език, за да вдъхнете живот на герои в игри, завладяващи аудиокниги, подкасти и интерактивни медии. Режисирайте всяка реплика от изпълнението с детайлен контрол върху насоките за актьорска игра, темпото, промените в диалекта и репликите за активно слушане.
- Gemini 3.8 Flash-Lite TTS: Създаден за мащабиране с голям обем и ниски разходи. Оптимизиран за дублаж с голям обем, създаване на аудиосъдържание и изразителни гласови агенти с прецизен контрол върху тона, темпото и изразителните нюанси.
Тези модели допълват бързо развиващото се семейство Gemini Audio, следвайки 3.5 Live Translate, 3.5 Transcribe, 3.8 Live и 3.8 Live Extended Thinking.
Създавайте и персонализирайте свои собствени гласове
Разширете избора си от 30 оригинални гласа до безкрайна библиотека. Независимо дали ви е необходим напълно оригинален глас на герой или последователен посланик на марката, нашият модел 3.8 Flash TTS предоставя цялостно гласово студио. Това ви позволява да създавате и използвате изразителни, естествено звучащи гласове за всеки момент, като същевременно дава възможност на разработчици и предприятия лесно да създават персонализирани аудио изживявания.
- Генеративен дизайн на глас: С Gemini 3.8 Flash TTS създавайте уникални гласове от нулата, като персонализирате ролята, акцента и характеристиките на гласа на над 100 езика и диалекта чрез подкани на естествен език — независимо дали вдъхвате живот на драматичен огнедишащ дракон или създавате харизматичен разказвач с отличителен регионален ритъм на речта.
Чуйте как Gemini 3.8 Flash TTS генерира енергичен глас на диджей от Мелбърн.
Чуйте как Gemini 3.8 Flash TTS генерира роботизиран глас с много метален тембър и монотонно звучене.
Чуйте как Gemini 3.8 Flash TTS вдъхва живот на японски дракон.
- Богата библиотека от гласове: Получете достъп до над 2000 готови за производство гласа с широко езиково покритие — включително регионални разновидности като мексикански испански, квебекски френски и шотландски английски.
- Копиране на глас: Пресъздайте последователни гласови профили само от 30-секунден аудиозапис на вашия глас или на глас, който имате право да използвате, с вградена проверка на съгласието, водни знаци SynthID и идентификационни данни C2PA за защита както на разработчиците, така и на гласовите изпълнители.
- Запазване и мащабиране: Запазвайте и управлявайте персонализираните гласове, които сте създали, за да осигурите последователно изпълнение и минимално отклонение в текущите проекти.
- Ремиксиране на гласове: Очаквайте скоро: изберете глас от нашата библиотека и настройте фино тембъра, височината, скоростта и акцента. Използвайте подкани, за да прецизирате характеристиките (например „добави лек южняшки американски акцент“ или „направи изпълнението по-меко“).
Режисирайте изпълнението, реплика по реплика
След като изберете гласовете си, и двата TTS модела ви дават прецизен контрол върху начина, по който се произнася всяка реплика.
- Режисирайте изпълнението реплика по реплика: Напишете собствени сценични указания или оставете Gemini да насочва изпълнението с естествени подсказки в сценария — от спокоен служител за обслужване на клиенти до прошепната напрегната сцена.
Чуйте как Gemini 3.8 Flash TTS позволява естествени, силно изразителни разговори за интерактивни гласови агенти.
Гледайте и чуйте как Gemini 3.8 Flash TTS използва детайлен контрол върху сценария, за да създаде дълбоко ангажиращо и завладяващо аудио изживяване.
- Генериране на дълго съдържание: Поддържайте високо качество на гласа, естествено темпо и тембър на героя в продължение на часове непрекъснато аудио с минимално отклонение на говорещия — идеално за подкасти и аудиокниги.
- Вградена постановка на сцени с двама говорители: Режисирайте безпроблемно разговори с множество реплики от един сценарий — независимо дали става дума за подкаст или драматичен разказ — като същевременно запазвате ясно разграничение между двата гласа и естествено редуване на репликите.
- Сценарни вокални изблици и реплики за активно слушане: Добавяйте реалистична разговорна текстура чрез невербални сигнали (като <laughs>, <sigh>, <gasp>) и междуметия за активно слушане (като |mhm| или |yeah|) за прецизен комедиен тайминг и реакционни моменти.
Вижте как Gemini 3.8 Flash TTS превръща подкани на естествен език в уникални гласови персони от нулата.
Гледайте как Gemini 3.8 Flash TTS позволява на създателите да проектират персонализирани сцени, за да вдъхнат живот на анимирани диалози.
Вижте как Gemini 3.8 Flash TTS превръща сценариите в напълно изпълнени диалогови сцени, позволявайки на създателите да режисират вокалното изпълнение и естественото редуване на репликите.
Получете изразително, висококачествено генериране на реч, създадено за глобален мащаб
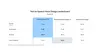
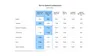
Gemini 3.8 Flash TTS предлага водещи възможности за персонализиране на гласа, като заема първо място като цяло в Voice Design Benchmark на Hume AI (71.4), както и водеща позиция при моделирането на акценти (60.8).
Gemini 3.8 Flash TTS и Gemini 3.8 Flash-Lite TTS позволяват наистина изразителни изпълнения без компромис с надеждността, като заемат съответно първо и второ място в индекса за цялостно качество на Hume AI. В сравнение с Gemini 3.1 Flash TTS моделът показва значителни подобрения при широк спектър от случаи на употреба, като съдържание в дълъг формат и контрол на сценарии с двама говорители.
При сляпи оценки на човешките предпочитания във Voice Arena Gemini 3.8 Flash и Flash-Lite TTS заемат водещи позиции сред конкурентите на ключови световни езици, включително японски, бразилски португалски, виетнамски, съвременен стандартен арабски (MSA), мексикански испански и хинди. С поддръжка на над 100 езика тези модели дават възможност на създатели, разработчици и предприятия да изграждат висококачествени, многоезични гласови изживявания по целия свят.

Изграждайте с доверие, съгласие и прозрачност
Създадохме възможностите си за създаване и копиране на гласове със строги мерки за защита, за да помагаме за защитата на гласовите изпълнители, да уважаваме идентичността и да гарантираме прозрачност на съдържанието. При копиране на глас системата ни използва проверка на съгласието: потребителите трябва да предоставят запис на устно съгласие от собственика на гласа, който съвпада с референтния говорител, преди да бъде създаден глас.
В по-широк план всеки аудиоклип, генериран от моделите Gemini Audio, е маркиран с воден знак SynthID. Този незабележим воден знак е вплетен директно в аудиоизхода, като гарантира, че генерираната от AI реч остава откриваема и помага за предотвратяване на дезинформацията. За повече подробности относно подхода ни към безопасността и отговорността прегледайте картата на модела.
Изпробвайте новата аудио площадка на Google AI Studio
От днес разработчиците могат да изпробват тези нови възможности за генериране на реч в Google AI Studio. Създадена като работно пространство за дизайн на гласове, тя ви позволява да създавате изцяло нови гласови идентичности от нулата или да копирате собствения си глас 1 , след което да ги пренесете директно в редактор на сценарии с двама говорители, за да режисирате изпълнението реплика по реплика.
Изпробвайте копирането на глас в Google AI Studio.
Лесно внедрявайте високопроизводителни гласови интерфейси
С помощта на Gemini API платформи за разработчици като Agora, LiveKit, Pipecat, Vercel дават възможност на разработчиците лесно да създават и внедряват високопроизводителни изживявания за генериране на реч.
Партнираме си с компании като Figma, HeyGen, Linguana, Wondercraft, 99.co и Ollang, които интегрират най-новите ни TTS модели, за да помогнат за ускоряване на глобалния дублаж, локализиране на медии с нюансирани регионални акценти и захранване на разговорни гласови агенти в голям мащаб.


Започнете да използвате най-новите ни модели Gemini Audio:
Gemini 3.8 Flash TTS се внедрява от днес:
- За разработчици: В Gemini API и Google AI Studio
- За предприятия: Очаквайте скоро чрез API в Gemini Enterprise
- За всички: В Gemini Notebook.
Gemini 3.8 Flash-Lite TTS се внедрява от днес:
- За разработчици: В Gemini API и Google AI Studio
- За предприятия: Очаквайте скоро чрез API в Gemini Enterprise
- За всички: В Google Vids
Преведено автоматично от английски. Оригиналната статия е на връзката по-долу.