Синтез мовлення з тексту Gemini 3.8 каже «привіт»

23 вересня 2026 р.
|Gemini 3.8 Flash TTS і Gemini 3.8 Flash-Lite TTS — наші найвиразніші моделі генерації аудіо. Створюйте голоси власних персонажів і керуйте діалогами сцен у Google AI Studio, Gemini API, Gemini Enterprise, Gemini Notebook і Google Vids.
Leland Rechis
Керівник групи з управління продуктами
Alan Cowen
Директор із дослідницької науки, від імені команди Gemini Audio
Сьогодні ми представляємо дві нові моделі перетворення тексту на мовлення в сімействі Gemini, які перетворюють генерацію голосу зі статичних пресетів на динамічну творчу студію. Ці моделі дають змогу творцям, розробникам і підприємствам створювати насиченіші та виразніші аудіовраження, а також покращують взаємодію з користувачами в таких продуктах, як Gemini Notebook і Google Vids.
- Gemini 3.8 Flash TTS: Створена для глибокого творчого керування та розробки персонажів. Створюйте абсолютно нові голоси з нуля за допомогою підказок природною мовою, щоб оживити персонажів в іграх, захопливих аудіокнигах, подкастах та інтерактивних медіа. Керуйте кожною реплікою виступу з детальним контролем акторських вказівок, темпу, зміни діалекту та реплік активного слухання.
- Gemini 3.8 Flash-Lite TTS: Створена для масштабування великих обсягів за оптимальної вартості. Оптимізована для дубляжу у великих обсягах, створення аудіоконтенту та виразних голосових агентів із точним контролем тону, темпу й емоційних нюансів.
Ці моделі доповнюють наше стрімко зростаюче сімейство Gemini Audio після випуску 3.5 Live Translate, 3.5 Transcribe, 3.8 Live і 3.8 Live Extended Thinking.
Створюйте й налаштовуйте власні голоси
Розширте бібліотеку з 30 оригінальних голосів до нескінченності. Незалежно від того, чи потрібен вам абсолютно оригінальний голос персонажа, чи незмінний голос представника бренду, наша модель 3.8 Flash TTS забезпечує роботу повноцінної вокальної студії. Це дає змогу створювати й використовувати виразні, природні голоси для кожної ситуації, а розробникам і підприємствам — легко створювати власні аудіовраження.
- Генеративний дизайн голосу: За допомогою Gemini 3.8 Flash TTS створюйте унікальні голоси з нуля, налаштовуючи роль, акцент і характеристики голосу більш ніж 100 мовами та діалектами за допомогою підказок природною мовою — чи то для оживлення драматичного дракона, що дихає вогнем, чи для створення харизматичного оповідача з виразною регіональною манерою мовлення.
Послухайте, як Gemini 3.8 Flash TTS генерує енергійний голос діджея з Мельбурна.
Послухайте, як Gemini 3.8 Flash TTS генерує дуже дзвінкий монотонний голос робота.
Послухайте, як Gemini 3.8 Flash TTS оживляє японського дракона.
- Розширена бібліотека голосів: Отримуйте доступ до понад 2 000 готових до використання голосів із широким мовним охопленням, зокрема до регіональних різновидів, таких як мексиканська іспанська, квебекська французька та шотландська англійська.
- Відтворення голосу: Відтворюйте незмінний голосовий профіль лише за 30-секундним аудіозразком власного голосу або голосу, на використання якого ви маєте права. Захист розробників і талантів забезпечують вбудована перевірка згоди, водяні знаки SynthID і облікові дані C2PA.
- Зберігайте й масштабуйте: Зберігайте та керуйте створеними власноруч голосами, щоб забезпечити стабільне звучання й мінімальні відхилення в поточних проєктах.
- Мікшування голосу: Незабаром ви зможете вибрати голос із нашої бібліотеки й точно налаштувати тембр, висоту, темп і акцент. Використовуйте підказки для коригування характеристик (наприклад, «додати легкий акцент півдня США» або «зробити подачу м’якшою»).
Керуйте виступом, репліка за реплікою
Після вибору голосів обидві моделі TTS дають точний контроль над тим, як вимовляється кожна репліка.
- Керуйте виступом репліка за реплікою: Пишіть власні сценічні вказівки або дозвольте Gemini керувати подачею за допомогою сценарних підказок природною мовою — від спокійного агента служби підтримки до пошепки озвученої напруженої сцени.
Послухайте, як Gemini 3.8 Flash TTS забезпечує природні, надзвичайно виразні розмови для інтерактивних голосових агентів.
Подивіться та послухайте, як Gemini 3.8 Flash TTS використовує детальний контроль сценарію для створення глибоко захопливого аудіовраження.
- Генерація довгих форм: Зберігайте високу якість голосу, природний темп і тембр персонажа протягом годин безперервного аудіо з мінімальним відхиленням голосу — ідеально для подкастів та аудіокниг.
- Вбудована постановка сцен із двома мовцями: Безперешкодно керуйте багатотуровими розмовами з одного сценарію — чи то для подкасту, чи то для драматичної оповіді — зберігаючи чітке розділення обох голосів і природну черговість реплік.
- Сценарні вокальні вигуки та репліки активного слухання: Додавайте реалістичну розмовну фактуру за допомогою невербальних сигналів (як-от <laughs>, <sigh>, <gasp>) і реплік активного слухання (як-от |mhm| або |yeah|) для точного комедійного таймінгу й реакцій.
Дізнайтеся, як Gemini 3.8 Flash TTS перетворює підказки природною мовою на унікальні голосові образи з нуля.
Подивіться, як Gemini 3.8 Flash TTS дає змогу творцям створювати власні сцени й оживляти анімовані діалоги.
Дізнайтеся, як Gemini 3.8 Flash TTS перетворює сценарії на повністю озвучені діалогові сцени, даючи творцям змогу керувати подачею голосу та природною черговістю реплік.
Отримуйте виразну високоякісну генерацію мовлення, розраховану на глобальне масштабування
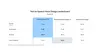
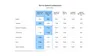
Gemini 3.8 Flash TTS пропонує провідні можливості налаштування голосу, посівши перше місце в загальному заліку Voice Design Benchmark від Hume AI (71,4), а також перше місце в моделюванні акцентів (60,8).
Gemini 3.8 Flash TTS і Gemini 3.8 Flash-Lite TTS забезпечують по-справжньому виразні виступи без шкоди для надійності, посівши відповідно перше та друге місця в Overall Quality Index від Hume AI. Порівняно з Gemini 3.1 Flash TTS модель демонструє значні покращення в широкому спектрі сценаріїв використання, зокрема в довгих форматах контенту та керуванні сценаріями з двома мовцями.
У сліпих оцінюваннях людських уподобань на Voice Arena Gemini 3.8 Flash і Flash-Lite TTS посідають провідні позиції серед конкурентів ключовими світовими мовами, зокрема японською, бразильською португальською, в’єтнамською, сучасною стандартною арабською (MSA), мексиканською іспанською та гінді. Завдяки підтримці понад 100 мов ці моделі дають творцям, розробникам і підприємствам змогу створювати високоякісні багатомовні голосові враження в усьому світі.

Створюйте з довірою, згодою та прозорістю
Ми розробили можливості створення та відтворення голосів із суворими запобіжними заходами, щоб захистити голосові таланти, поважати ідентичність і забезпечити прозорість контенту. Для відтворення голосу наша система використовує перевірку згоди: користувачі повинні надати запис усної згоди власника голосу, який відповідає голосу в еталонному записі, перш ніж голос можна буде створити.
Загалом кожен аудіокліп, згенерований нашими моделями Gemini Audio, має водяний знак SynthID. Цей непомітний водяний знак безпосередньо вбудований у вихідний аудіосигнал, завдяки чому мовлення, створене ШІ, залишається виявлюваним, що допомагає запобігати дезінформації. Докладніше про наш підхід до безпеки та відповідальності читайте в картці моделі.
Спробуйте нову аудіопісочницю Google AI Studio
Від сьогодні розробники можуть випробувати ці нові можливості генерації мовлення у Google AI Studio. Створений як робочий простір для дизайну голосу, цей інструмент дає змогу створювати абсолютно нові голосові образи з нуля або відтворювати власний голос 1 , а потім безпосередньо переносити їх у редактор сценаріїв із двома мовцями, щоб керувати подачею реплік рядок за рядком.
Спробуйте відтворення голосу в Google AI Studio.
Легко розгортайте високопродуктивні голосові інтерфейси
Використовуючи Gemini API, платформи для розробників, як-от Agora, LiveKit, Pipecat і Vercel, дають змогу розробникам легко створювати й розгортати високопродуктивні рішення для генерації мовлення.
Ми співпрацюємо з такими компаніями, як Figma, HeyGen, Linguana, Wondercraft, 99.co та Ollang, які інтегрують наші новітні моделі TTS, щоб прискорити глобальний дубляж, локалізувати медіа з урахуванням тонких регіональних акцентів і масштабувати голосових агентів для ведення розмов.


Почніть використовувати наші найновіші моделі Gemini Audio:
Розгортання Gemini 3.8 Flash TTS розпочинається сьогодні:
- Для розробників: у Gemini API та Google AI Studio
- Для підприємств: незабаром через API у Gemini Enterprise
- Для всіх: у Gemini Notebook.
Розгортання Gemini 3.8 Flash-Lite TTS розпочинається сьогодні:
- Для розробників: у Gemini API та Google AI Studio
- Для підприємств: незабаром через API у Gemini Enterprise
- Для всіх: у Google Vids
Перекладено автоматично з англійської. Оригінал статті — за посиланням нижче.