Система преобразования текста в речь Gemini 3.8 говорит «привет»

23 сент. 2026 г.
|Gemini 3.8 Flash TTS и Gemini 3.8 Flash-Lite TTS — наши самые выразительные модели генерации аудио. Создавайте голоса уникальных персонажей и управляйте диалогами в сценах через Google AI Studio, Gemini API, Gemini Enterprise, Gemini Notebook и Google Vids.
Leland Rechis
Руководитель группы по продукту
Alan Cowen
Директор по научным исследованиям от имени команды Gemini Audio
Сегодня мы представляем две новые модели преобразования текста в речь в семействе Gemini, превращая генерацию голосов из набора статичных пресетов в динамичную творческую студию. Эти модели позволяют создателям, разработчикам и предприятиям создавать более насыщенные и выразительные аудиовозможности, а также улучшать пользовательский опыт в таких продуктах, как Gemini Notebook и Google Vids.
- Gemini 3.8 Flash TTS: создана для глубокой творческой режиссуры и разработки персонажей. Создавайте совершенно новые голоса с нуля с помощью подсказок на естественном языке, чтобы оживлять персонажей в играх, иммерсивных аудиокнигах, подкастах и интерактивных медиа. Управляйте каждой репликой выступления с детальным контролем актёрских указаний, темпа, смены диалекта и реплик активного слушания.
- Gemini 3.8 Flash-Lite TTS: создана для масштабирования с высокой нагрузкой и эффективными затратами. Оптимизирована для массовой озвучки, создания аудиоконтента и выразительных голосовых агентов с точным контролем тона, темпа и выразительных нюансов.
Эти модели дополняют наше быстро развивающееся семейство Gemini Audio вслед за 3.5 Live Translate, 3.5 Transcribe, 3.8 Live и 3.8 Live Extended Thinking.
Создавайте и настраивайте собственные голоса
Расширьте выбор с 30 оригинальных голосов до бесконечной библиотеки. Нужен ли вам полностью оригинальный голос персонажа или неизменный голос представителя бренда, наша модель 3.8 Flash TTS превращает систему в полноценную вокальную студию. Она позволяет создавать и использовать выразительные, естественно звучащие голоса для любых задач, а разработчикам и предприятиям — легко создавать собственные аудиовозможности.
- Генеративный дизайн голоса: с помощью Gemini 3.8 Flash TTS создавайте уникальные голоса с нуля, настраивая роль, акцент и характеристики голоса более чем на 100 языках и диалектах с помощью подсказок на естественном языке — будь то драматичный огнедышащий дракон или харизматичный рассказчик с особой региональной манерой речи.
Послушайте, как Gemini 3.8 Flash TTS создаёт энергичный голос диджея из Мельбурна.
Послушайте, как Gemini 3.8 Flash TTS создаёт очень металлический монотонный голос робота.
Послушайте, как Gemini 3.8 Flash TTS оживляет японского дракона.
- Обширная библиотека голосов: получите доступ к более чем 2000 готовых к использованию голосов с широким языковым охватом, включая региональные варианты, такие как мексиканский испанский, квебекский французский и шотландский английский.
- Копирование голоса: воссоздавайте неизменные голосовые профили всего по 30-секундному аудиосэмплу собственного голоса или голоса, на использование которого у вас есть права. Функция поддерживается встроенной проверкой согласия, водяными знаками SynthID и учётными данными C2PA, защищающими как разработчиков, так и обладателей голосов.
- Сохраняйте и масштабируйте: сохраняйте и управляйте созданными вами пользовательскими голосами, чтобы обеспечить стабильное звучание и минимальные отклонения в текущих проектах.
- Микширование голоса: скоро появится возможность выбрать голос из нашей библиотеки и точно настроить тембр, высоту, темп и акцент. Используйте подсказки для настройки характеристик (например, «добавь лёгкий южноамериканский акцент» или «смягчи подачу»).
Управляйте исполнением, реплика за репликой
Выбрав голоса, вы получите точный контроль над тем, как произносится каждая реплика, в обеих моделях TTS.
- Управляйте исполнением построчно: пишите собственные сценические указания или позволяйте Gemini управлять подачей с помощью естественных подсказок в сценарии — от спокойного агента службы поддержки до шёпота в напряжённой сцене.
Послушайте, как Gemini 3.8 Flash TTS обеспечивает естественные, выразительные диалоги для интерактивных голосовых агентов.
Посмотрите и послушайте, как Gemini 3.8 Flash TTS использует детальный контроль сценария для создания глубоко захватывающего иммерсивного аудио.
- Генерация длинных форматов: сохраняйте высокое качество голоса, естественный темп и тембр персонажа на протяжении нескольких часов непрерывного аудио с минимальным дрейфом голоса — идеально для подкастов и аудиокниг.
- Встроенная постановка сцен с двумя говорящими: легко управляйте многоходовыми диалогами из одного сценария — будь то подкаст или драматическое повествование — сохраняя чёткое разделение голосов и естественную очередность реплик.
- Сценарные вокальные реакции и реплики активного слушания: добавляйте реалистичную разговорную фактуру с помощью невербальных сигналов (например, <смех>, <вздох>, <вскрик>) и реплик активного слушания (например, |угу| или |да|), чтобы точно выдерживать комедийный тайминг и моменты реакции.
Узнайте, как Gemini 3.8 Flash TTS превращает подсказки на естественном языке в уникальные голосовые образы с нуля.
Посмотрите, как Gemini 3.8 Flash TTS позволяет создателям разрабатывать собственные сцены и оживлять диалоги анимационных персонажей.
Узнайте, как Gemini 3.8 Flash TTS превращает сценарии в полностью озвученные диалоги, позволяя создателям управлять подачей реплик и естественной очередностью ответов.
Получайте выразительную высококачественную генерацию речи в глобальном масштабе
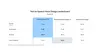
Gemini 3.8 Flash TTS предлагает передовые возможности настройки голоса, заняв первое место в общем зачёте Hume AI Voice Design Benchmark (71,4), а также лидируя в моделировании акцентов (60,8).
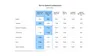
Gemini 3.8 Flash TTS и Gemini 3.8 Flash-Lite TTS обеспечивают по-настоящему выразительное исполнение без ущерба для надёжности, заняв соответственно первое и второе места в Overall Quality Index от Hume AI. По сравнению с Gemini 3.1 Flash TTS модель демонстрирует значительные улучшения в широком спектре сценариев использования, включая длинноформатный контент и управление сценарием с двумя говорящими.
В слепых оценках пользовательских предпочтений на платформе Voice Arena Gemini 3.8 Flash и Flash-Lite TTS занимают ведущие позиции среди конкурентов на ключевых мировых языках, включая японский, бразильский португальский, вьетнамский, современный литературный арабский (MSA), мексиканский испанский и хинди. Благодаря поддержке более 100 языков эти модели позволяют создателям, разработчикам и предприятиям создавать высококачественные многоязычные голосовые продукты по всему миру.

Создавайте с доверием, согласием и прозрачностью
Мы разработали возможности создания и копирования голосов со строгими мерами безопасности, чтобы защищать обладателей голосов, уважать личность и обеспечивать прозрачность контента. Для копирования голоса наша система использует проверку согласия: пользователь должен предоставить запись устного согласия владельца голоса, соответствующую эталонному говорящему, прежде чем голос можно будет создать.
Кроме того, каждый аудиоклип, созданный моделями Gemini Audio, снабжается водяным знаком SynthID. Этот незаметный водяной знак встраивается непосредственно в аудиовыход, благодаря чему речь, сгенерированную ИИ, можно обнаружить и предотвратить распространение дезинформации. Подробнее о нашем подходе к безопасности и ответственному использованию см. в карточке модели.
Попробуйте новую аудиоплощадку Google AI Studio
Начиная с сегодняшнего дня разработчики могут протестировать новые возможности генерации речи в Google AI Studio. Работая как пространство для дизайна голосов, площадка позволяет создавать совершенно новые голосовые образы с нуля или копировать собственный голос 1 , а затем непосредственно переносить их в редактор сценариев с двумя говорящими для управления подачей каждой реплики.
Попробуйте копирование голоса в Google AI Studio.
Легко разворачивайте высокопроизводительные голосовые интерфейсы
Используя Gemini API, платформы разработчиков, такие как Agora, LiveKit, Pipecat и Vercel, позволяют разработчикам легко создавать и развёртывать высокопроизводительные решения для генерации речи.
Мы сотрудничаем с такими компаниями, как Figma, HeyGen, Linguana, Wondercraft, 99.co и Ollang, которые интегрируют наши новейшие модели TTS, чтобы ускорить глобальную озвучку, локализовать медиа с учётом региональных акцентов и масштабировать разговорных голосовых агентов.


Начните использовать наши новейшие модели Gemini Audio:
Gemini 3.8 Flash TTS начинает поэтапно предоставляться с сегодняшнего дня:
- Для разработчиков: в Gemini API и Google AI Studio
- Для предприятий: скоро через API в Gemini Enterprise
- Для всех: в Gemini Notebook.
Gemini 3.8 Flash-Lite TTS начинает поэтапно предоставляться с сегодняшнего дня:
- Для разработчиков: в Gemini API и Google AI Studio
- Для предприятий: скоро через API в Gemini Enterprise
- Для всех: в Google Vids
Переведено автоматически с английского. Оригинал статьи — по ссылке ниже.