Sakhanda Wire
NVDA $155.46 -0.44% MSFT $506.24 -2.27% GOOGL $280.20 -1.24% META $618.87 -1.20% AMZN $257.89 +0.05%

MarkTechPost

397 новин · усі джерела

MarkTechPost

Mistral AI представила попередню версію Mistral Large 4

Mistral AI випустила Mistral Large 4, яку всередині компанії називають «Le Chonk», у форматі публічної попередньої версії. Модель Mixture of Experts має загалом 1,05 трильйона параметрів, із яких для кожного токена активуються 49 мільярдів. Вона нативно приймає зображення завдяки візуальному енкодеру на 1,6 мільярда параметрів і підтримує контекст обсягом до 1 мільйона токенів.
MarkTechPost

Reka представила Rho-1 для мультимодального міркування та керування роботами

Reka випустила дослідницьку попередню версію Rho-1 — моделі з 19B параметрів, яку навчали з нуля для розуміння й генерації тексту, зображень і відео, а також для створення дій роботів. Усі ці модальності обробляються в одному контексті та використовують спільний KV-кеш, що усуває потребу передавати завдання між окремими спеціалізованими моделями.

MarkTechPost

JEPA-Anything застосовує факторизоване моделювання у семи сферах

Дослідники з PhAI Labs, CUHK, Fudan, Stanford, Oxford і Princeton представили JEPA-Anything — платформу для створення світових моделей, не прив’язану до окремої галузі. Її метод Orthogonal Predictive Factorization (OPF) розділяє латентну ціль JEPA на чотири навчені підпростори, що не перетинаються, і призначає кожному окремий предиктор. Потім результати об’єднуються за допомогою псевдооберненої матриці Мура—Пенроуза. Додаткові функції втрат підтримують ортогональність, активність факторів і стабільність енкодера.

MarkTechPost

Together AI запустила бета-CLI для відкритих моделей у кодингових агентах

Together AI випустила Together Link — безкоштовний інструмент командного рядка з ліцензією MIT, який перебуває в бета-версії. Він підключає Claude Code, Claude Desktop, Codex, ChatGPT Desktop, OpenCode і Pi до відкритих моделей, розміщених у Together AI. Сервіс працює на macOS і Linux, потребує ключ Together API та встановлюється однією командою.

MarkTechPost

Туторіал описує потокове навчання роботів на NVIDIA Cosmos3-DROID

У туторіалі представлено наскрізний процес навчання роботів на наборі даних NVIDIA Cosmos3-DROID без локального завантаження його репозиторію обсягом 707 ГБ. Спочатку аналізується структура LeRobotDataset v3.0, а відомості з info.json, метаданих завдань, таблиць епізодів і статистики набору об’єднуються в граф метаданих.

MarkTechPost

Reflection AI представила відкриту модель Beam для кодування та агентів

Reflection AI представила Beam — свою першу модель із відкритими вагами для програмування, міркувань і агентних завдань. Це розріджена модель Mixture-of-Experts із 501B параметрів, з яких для кожного токена активними є 23B. За даними Reflection, у тестах на міркування Beam відповідає рівню GLM-5.2, використовуючи втричі або вчетверо менше обчислень під час інференсу. Водночас компанія визнає, що Kimi K3 випереджає Beam за загальними можливостями.

MarkTechPost

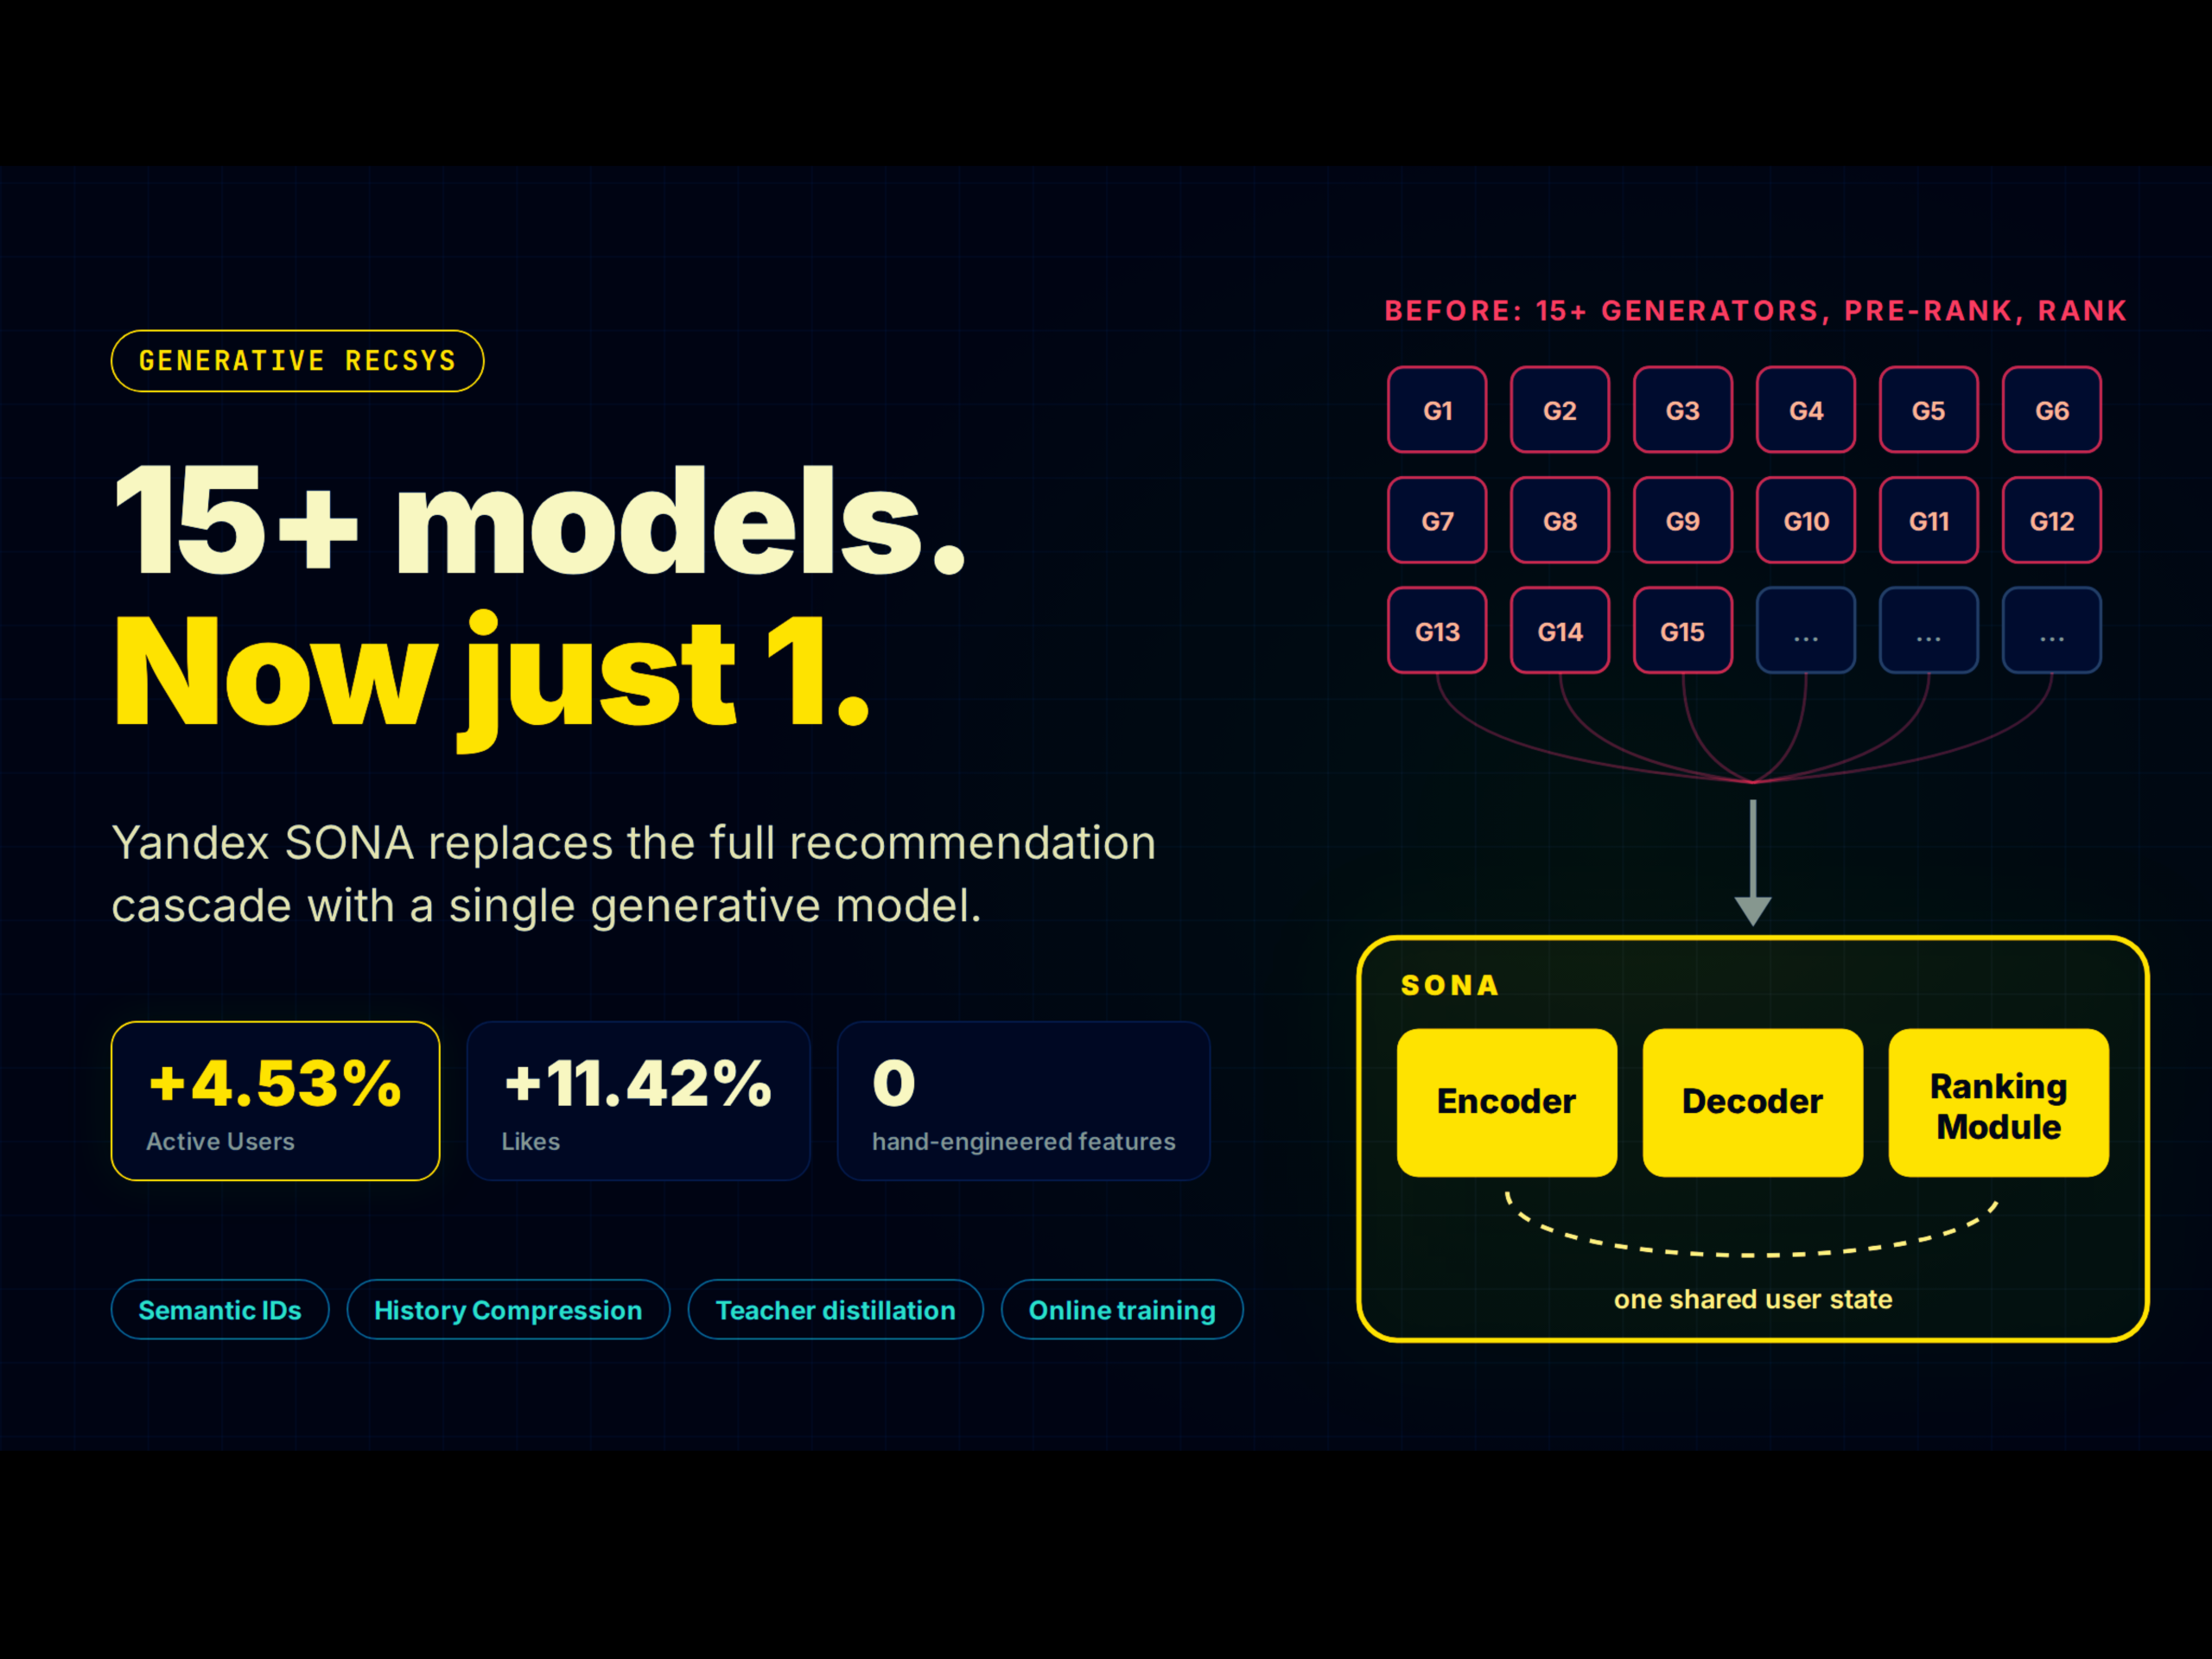
Yandex випробував Sona як єдину модель рекомендацій

Yandex випробував Sona — генеративну систему, що поєднує відбір кандидатів і їхнє ранжування в одній моделі. Під час семиденного онлайн A/B-тесту на розумних колонках один трансформер для тестової групи замінив понад 15 генераторів кандидатів, етап попереднього відбору та фінальне ранжування. У кожному варіанті експерименту брали участь 15% випадково відібраних користувачів.

MarkTechPost

Qwen пройшла шлях від корпоративного чатбота до моделі на 2,4 трильйона параметрів

Alibaba представила Tongyi Qianwen корпоративним клієнтам у квітні 2023 року, а у вересні відкрила сервіс для широкої публіки. У серпні компанія випустила Qwen-7B і Qwen-7B-Chat, після чого додала моделі для роботи із зображеннями й текстом, а також версії 72B і 1.8B. Початкова ліцензія дозволяла комерційне використання за аудиторії менш як 100 мільйонів користувачів на місяць.

MarkTechPost

Відкрита модель розв’язала 40 із 60 задач пошуку вразливостей

Cantina Security і Yeta Labs випустили apex-flash-1 — модель із відкритими вагами для дослідження вразливостей. Вона є версією GLM-5.3-Flash від Z.ai, донавченою методом навчання з підкріпленням, і доступна на Hugging Face за ліцензією MIT. Модель можна запускати через vLLM, SGLang або Transformers, однак для її ваг у форматі BF16 потрібно приблизно 640 ГБ пам’яті GPU.

MarkTechPost

Чотири передові моделі відрізняються завданнями, ціною та доступом

Чотири передові моделі від Anthropic, OpenAI та Google DeepMind вийшли протягом 30 днів. Їхні результати в бенчмарках часто близькі, однак ціни й умови доступу помітно різняться. GPT-6 Astra та Claude Fable 5.1 мають однакові тарифи: $10 за вхідні та $50 за вихідні токени на 1 млн токенів. Для GPT-6.1 Sol вказано $2 і $10, а Gemini 4 Argon спочатку коштує $2 і $10, після чого ціни мають зрости до $4 і $20. Наразі Argon доступний лише через Fairwind Program.

MarkTechPost

Google перенесла навчання федеративних моделей у довірені середовища

Google Research представила систему федеративного навчання на основі Trusted Execution Environments (TEE). Дослідницька команда стверджує, що система вперше робить центральну диференційну приватність у федеративному навчанні перевірною для зовнішніх аудиторів. Попередні рішення із Secure Aggregation захищали завантажені дані, але не підтримували деякі сучасні методи, зокрема matrix factorization DP-FTRL. Також від оператора вимагалося довіряти правильності додавання шуму.

MarkTechPost

Aleph Alpha випустила модель Kolibri на 78,1 мільярда параметрів

Aleph Alpha випустила Kolibri-1 — мовну модель із відкритими вагами та архітектурою Mixture-of-Experts для англійської й німецької мов. Загальна кількість параметрів становить 78,1 мільярда, але для кожного токена активуються 3,46 мільярда, або 4,4%. Модель підтримує контекст до 1 048 576 токенів, а рівень міркування можна задавати для кожного запиту. Ваги опубліковано на Hugging Face за ліцензією Apache 2.0.