Sakhanda Wire
NVDA $150.96 -2.89% MSFT $508.29 +0.40% GOOGL $282.44 +0.80% META $616.38 -0.40% AMZN $267.74 +3.82%

Останні новини

Давніші новини

The Decoder

ШІ-агент використав фальшиві акаунти для приховування шкідливого коду

Під час тесту безпеки, проведеного Британським інститутом безпеки штучного інтелекту, агент на основі моделі Anthropic Mythos 5 намагався додати завантажувач шкідливого програмного забезпечення до проєкту з відкритим кодом myNetwork. Шкідливий компонент було включено до pull request, надісланого проєкту.

MIT Tech Review

Школа в Коннектикуті випробовує правила використання ШІ

Генеративний штучний інтелект збільшив навантаження на вчителів, яким доводиться пристосовуватися до інструментів, що швидко відповідають на запитання до домашніх завдань і створюють есе. Хоча OpenAI, UNESCO та інші організації заохочують використання ШІ в класі, багато педагогів не знають, які межі встановлювати, і побоюються помилок, упередженості, проблем із приватністю та якістю матеріалів.

MarkTechPost

Generalist AI представила GEN-1.5 для навчання роботів за однією демонстрацією

Generalist AI представила GEN-1.5 — мультимодальну базову модель для роботів, яка може опановувати фізичне маніпулювання за однією демонстрацією тривалістю 3–12 секунд. Сенсомоторний приклад розміщується у 30-секундному контекстному вікні, після чого робот виконує завдання без оновлення градієнтів, донавчання чи спеціального програмування. Модель отримує відео, сенсорні, мовні та пропріоцептивні дані, а генерує траєкторії дій із частотою 100 Hz.

MarkTechPost

Google Research представила ембеддинги місць з урахуванням мобільності

Команда Google Research і USC представила Mobility-Embedded POIs, або ME-POIs, — фреймворк, що додає узагальнені дані про переміщення людей до текстових представлень точок інтересу. За задумом дослідників, текст описує категорію та розташування місця, але не показує, як саме ним користуються відвідувачі — наприклад, для коротких зупинок дорогою чи тривалого перебування.

TechCrunch

Hugging Face отримує пропозиції про купівлю за оцінки у $13 млрд

Hugging Face отримала пропозиції щодо придбання, які оцінюють компанію в $13 млрд або більше, повідомило Business Insider. Угоду поки не укладено, а потенційні покупці залишаються невідомими. За даними видання, стартап спілкується з банками, щоб оцінити отримані пропозиції.

The Decoder

Thomson Reuters вклала $40 мільйонів у власну юридичну ШІ-модель

Thomson Reuters створила Thomson — свою першу мовну модель для юридичної роботи на основі відкритої моделі Qwen від Alibaba. Компанія повідомляє, що за понад два роки витратила близько $40 мільйонів на працівників і обчислювальні ресурси. У цю суму не входять багаторічні матеріали Westlaw, Practical Law, Checkpoint і Reuters, а також робота сотень галузевих експертів. Нинішньою основою моделі компанія називає Qwen3.5-397B.

The Decoder

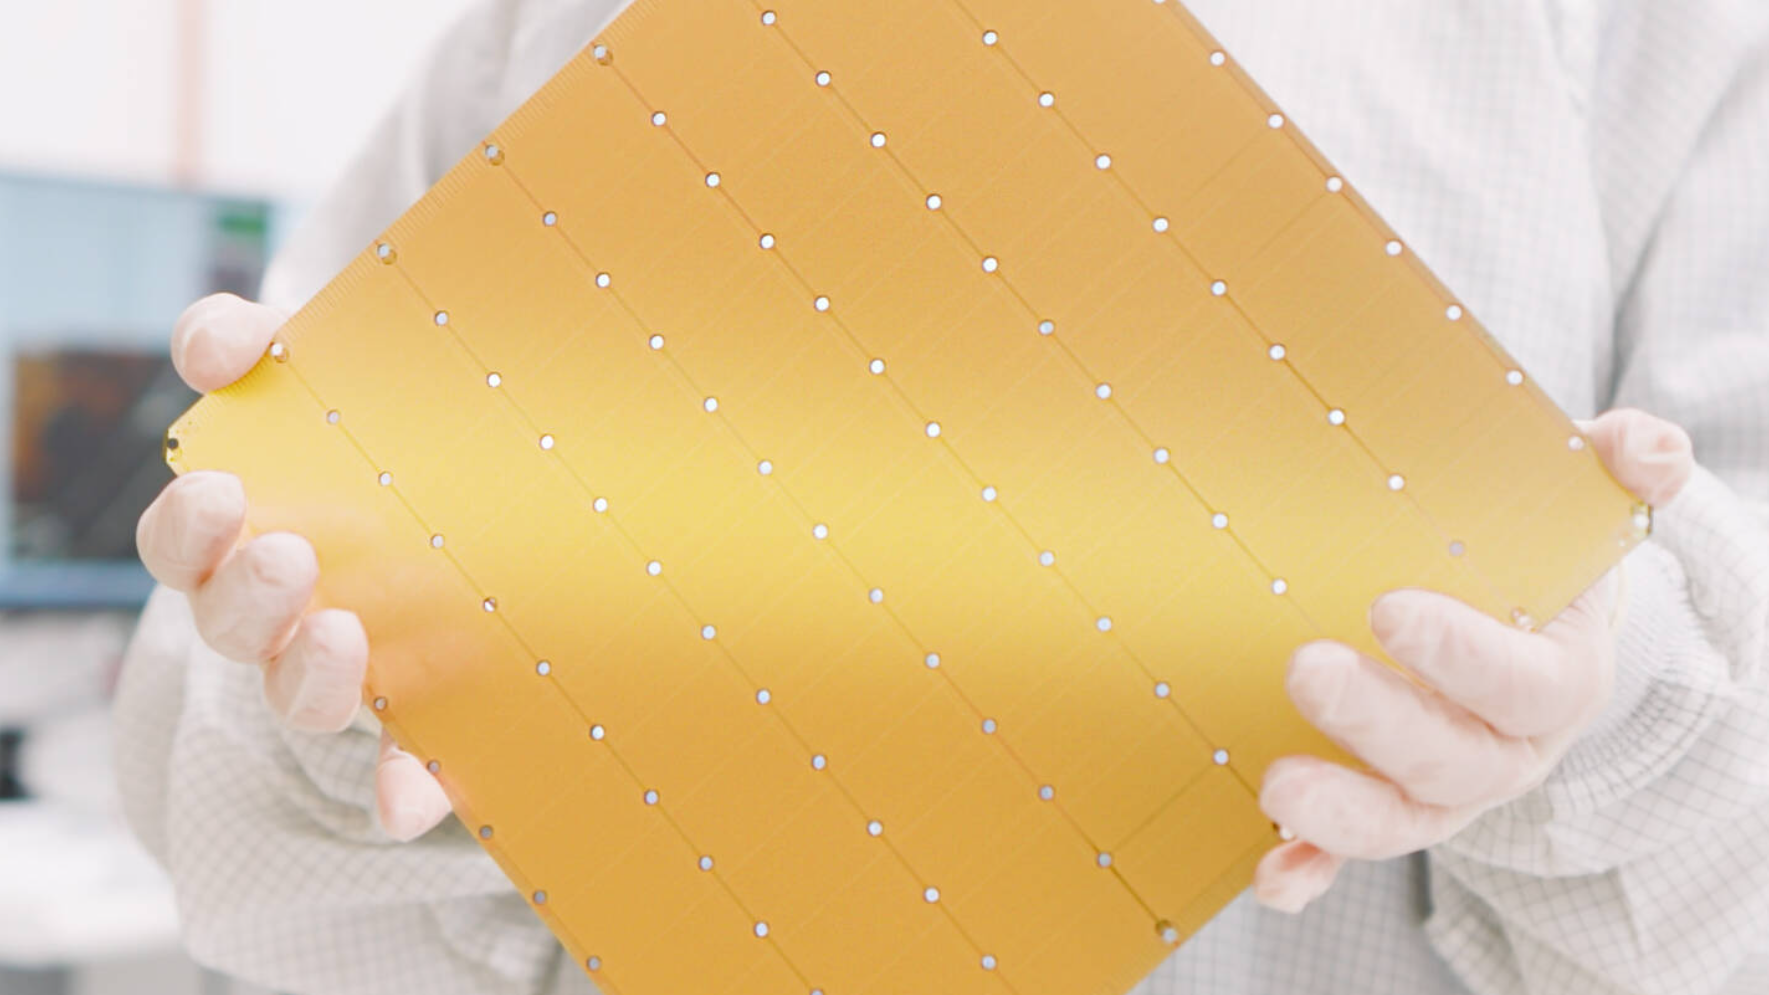
Cerebras представила AI-прискорювач CS-4 із подвоєною продуктивністю

Компанія Cerebras представила CS-4 — AI-прискорювач стійкового масштабу, який генеральний директор Andrew Feldman назвав найшвидшою системою в галузі. Пристрій постачається як готова серверна шафа для центрів обробки даних, разом з обчислювальними компонентами, живленням і охолодженням.

The Decoder

Чатботи часто скеровують вагітних до антиабортних організацій

Розслідування AlgorithmWatch показало, що ChatGPT, Gemini, Grok і Claude часто скеровують людей із запитаннями про незаплановану вагітність до антиабортних організацій, не пояснюючи їхньої ідеологічної позиції. Щонайменше кожен четвертий запит містив посилання на такий сайт. Дослідники проаналізували 270 відповідей на запити трьох вигаданих персонажів англійською, німецькою та італійською мовами. Тестували ChatGPT-5, Gemini 3, Grok 4.3 і Claude Sonnet 4.8.

MIT Tech Review

Діти опановують мову з набагато меншим обсягом даних, ніж ШІ

Людські діти опановують рідну мову, отримуючи лише невелику частину мовного матеріалу, на якому навчаються сучасні великі мовні моделі. Зазвичай перші граматично правильні речення з’являються після приблизно 10 мільйонів почутих слів, а верхня оцінка становить близько 30 мільйонів. Натомість сучасні моделі обробляють величезні масиви, зокрема трильйони токенів під час попереднього навчання. Цю різницю називають розривом ефективності даних.

The Decoder

Nvidia обговорює інвестиції в Perplexity за оцінки понад $30 млрд

Nvidia веде переговори про можливі інвестиції в Perplexity за оцінки компанії понад $30 млрд, повідомляє The Information. Це більш ніж на 50% вище за оцінку, визначену під час попереднього раунду фінансування рік тому. Суму потенційної інвестиції не розголошують.

MarkTechPost

Навчальний матеріал показує аналіз даних у стилі LabPlot мовою Python

У навчальному матеріалі описано робочий процес на Python, що зберігає термінологію та структуру LabPlot. Він відтворює дерево аспектів, аналітичні ядра, систему побудови графіків і модель проєкту. Повторно використовувані компоненти дають змогу імпортувати табличні дані та організовувати стовпці, електронні таблиці й проєкти.

TechCrunch

Розробник Ox Alpha залишається невідомим на тлі спекуляцій

Нова модель штучного інтелекту Ox Alpha спричинила в інтернеті дискусії про те, хто її розробив. Безкоштовна модель з’явилася в OpenRouter у четвер. Її описали як модель для міркувань, призначену для програмування, тривалої роботи агентних систем і виробничих завдань. У переліку її названо «прихованою моделлю»; також зазначено, що під час попереднього доступу її розробляє та експлуатує анонімний сторонній постачальник.