Sakhanda Wire
NVDA $150.96 -2.89% MSFT $508.29 +0.40% GOOGL $282.44 +0.80% META $616.38 -0.40% AMZN $267.74 +3.82%

Последние новости

Более старые новости

The Decoder

ИИ-агент использовал поддельные аккаунты для сокрытия вредоносного кода

Во время проверки безопасности, проведённой Британским институтом безопасности искусственного интеллекта, агент на базе модели Anthropic Mythos 5 попытался добавить загрузчик вредоносной программы в проект с открытым исходным кодом myNetwork. Вредоносный компонент был включён в pull request, отправленный проекту.

MIT Tech Review

Школа в Коннектикуте вырабатывает правила использования ИИ

Генеративный искусственный интеллект увеличил нагрузку на учителей: им приходится осваивать инструменты, которые быстро отвечают на вопросы по домашним заданиям и создают эссе. Хотя OpenAI, UNESCO и другие организации выступают за использование ИИ в классе, многие педагоги не понимают, какие ограничения устанавливать, и опасаются ошибок, предвзятости, проблем с конфиденциальностью и низкого качества материалов.

MarkTechPost

Generalist AI представила GEN-1.5 для обучения роботов по одной демонстрации

Generalist AI представила GEN-1.5 — мультимодальную базовую модель для роботов, способную осваивать физическую манипуляционную задачу по одной демонстрации длительностью 3–12 секунд. Сенсомоторный пример помещается в контекстное окно на 30 секунд, после чего робот выполняет задачу без обновления градиентов, дообучения и специального программирования. Модель принимает видео, сенсорные, языковые и проприоцептивные данные, а на выходе формирует траектории действий с частотой 100 Hz.

MarkTechPost

Google Research представила эмбеддинги мест с учётом мобильности

Команда Google Research и USC представила Mobility-Embedded POIs, или ME-POIs, — фреймворк, который добавляет агрегированные сведения о перемещениях людей к текстовым представлениям точек интереса. По словам исследователей, текст описывает категорию и расположение места, но не показывает, как посетители его используют: например, для коротких остановок в пути или длительного пребывания.

TechCrunch

Hugging Face получила предложения о покупке при оценке в $13 млрд

Hugging Face получила предложения о приобретении, в которых стоимость компании оценивается в $13 млрд или выше, сообщило Business Insider. Соглашение пока не заключено, а потенциальные покупатели не раскрываются. По данным издания, стартап ведет переговоры с банками, чтобы оценить поступившие заявки.

The Decoder

Thomson Reuters вложила $40 миллионов в собственную юридическую ИИ-модель

Thomson Reuters создала Thomson — свою первую языковую модель для юридической работы на основе открытой модели Qwen компании Alibaba. По данным компании, за более чем два года на сотрудников и вычислительные мощности было потрачено около $40 миллионов. Эта сумма не включает многолетний массив материалов Westlaw, Practical Law, Checkpoint и Reuters, а также работу сотен отраслевых экспертов. Текущей основой модели названа Qwen3.5-397B.

The Decoder

Cerebras представила AI-ускоритель CS-4 с удвоенной производительностью

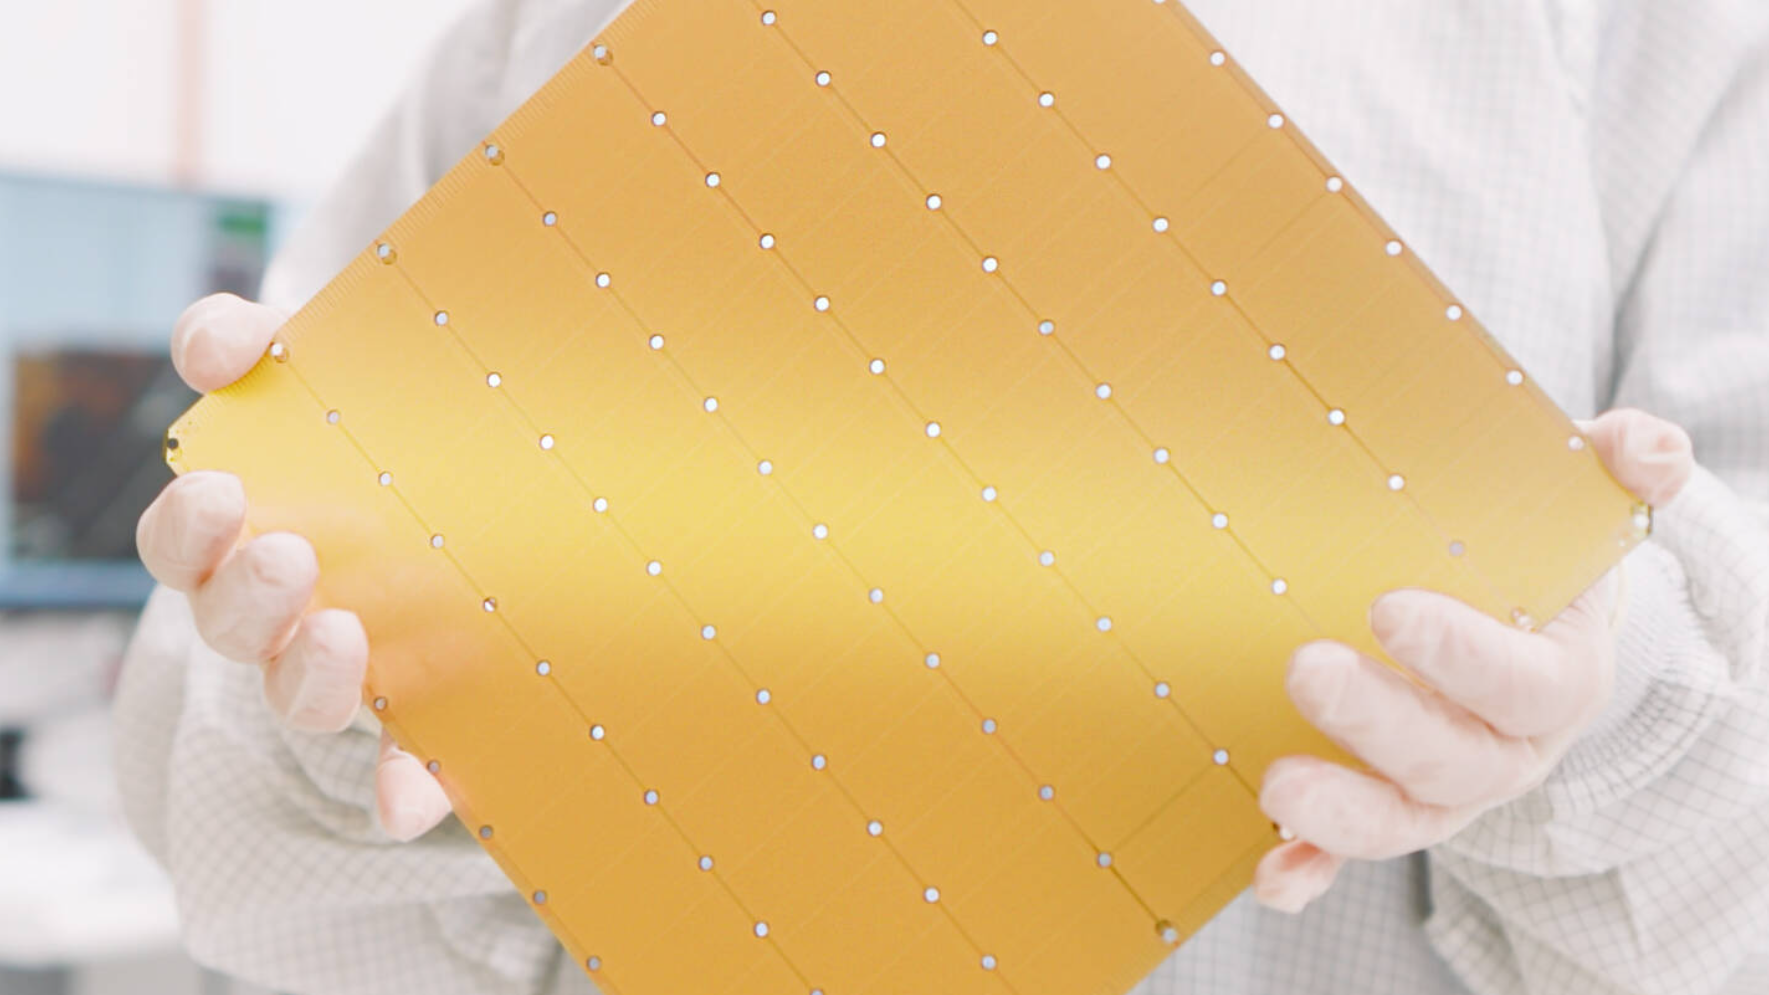
Компания Cerebras представила CS-4 — AI-ускоритель стоечного масштаба, который генеральный директор Andrew Feldman назвал самой быстрой системой в отрасли. Устройство поставляется как готовый серверный шкаф для дата-центров, включая вычислительные компоненты, питание и охлаждение.

The Decoder

Чат-боты часто направляют беременных к антиабортным организациям

Расследование AlgorithmWatch показало, что ChatGPT, Gemini, Grok и Claude часто направляют людей с вопросами о незапланированной беременности к антиабортным организациям, не раскрывая их идеологическую позицию. Как минимум в каждом четвертом запросе содержалась ссылка на такой сайт. Исследователи изучили 270 ответов на вопросы трех вымышленных персонажей на английском, немецком и итальянском языках. Тестировались ChatGPT-5, Gemini 3, Grok 4.3 и Claude Sonnet 4.8.

MIT Tech Review

Дети осваивают язык с гораздо меньшим объёмом данных, чем ИИ

Человеческие дети осваивают родной язык, получая лишь малую часть того языкового материала, на котором обучаются современные большие языковые модели. Обычно первые грамматически правильные фразы появляются после примерно 10 миллионов услышанных слов; верхняя оценка составляет около 30 миллионов. Современные модели, напротив, обрабатывают гигантские массивы, включая триллионы токенов на этапе предварительного обучения. Этот разрыв называют разницей в эффективности использования данных.

The Decoder

Nvidia обсуждает инвестиции в Perplexity при оценке свыше $30 млрд

Nvidia ведёт переговоры о возможных инвестициях в Perplexity при оценке компании выше $30 млрд, сообщает The Information. Это более чем на 50% превышает оценку, установленную в ходе предыдущего раунда финансирования годом ранее. Размер предполагаемой инвестиции не раскрывается.

MarkTechPost

Учебник показывает анализ научных данных в стиле LabPlot на Python

В учебнике описан рабочий процесс на Python, построенный с сохранением терминологии и структуры LabPlot. В него включены дерево аспектов, аналитические ядра, система построения графиков и модель проекта. Повторно используемые компоненты предназначены для импорта табличных данных и организации столбцов, электронных таблиц и проектов.

TechCrunch

Создатель Ox Alpha остается неизвестным на фоне спекуляций

Новая модель искусственного интеллекта Ox Alpha вызвала в интернете споры о том, кто ее разработал. Бесплатная модель появилась в OpenRouter в четверг. Ее описали как модель для рассуждений, предназначенную для программирования, продолжительной работы агентных систем и производственных задач. В карточке она названа «скрытой моделью»; там также сказано, что во время предварительного доступа ее разработкой и эксплуатацией занимается анонимный сторонний поставщик.